ARTICLE · 1292858
AI 的"神经网络"里,没有一个神经元
1958 年,《纽约时报》报道了康奈尔一位年轻研究者造出的机器。报道里说,海军期待它能"走路、说话、看、写、自我复制,并意识到自己的存在"。
那台机器叫感知机。它只学得会一件事:用一条直线把两类东西分开。
今天你用的每一个 AI,背后都是同一种东西——神经网络。但如果你把它拆开看,里面没有一个神经元。没有细胞,没有突触,没有电信号,也没有任何东西在"放电"。
名字留下来了,实质从来没有。
一、一个"神经元"的全部工作
先看最小的单位。假设你要让程序决定"今天带不带伞"。
你给它三个输入:湿度 0.8、云量 0.9、气压正在降(记作 1.0)。然后给每个输入配一个权重,加起来:
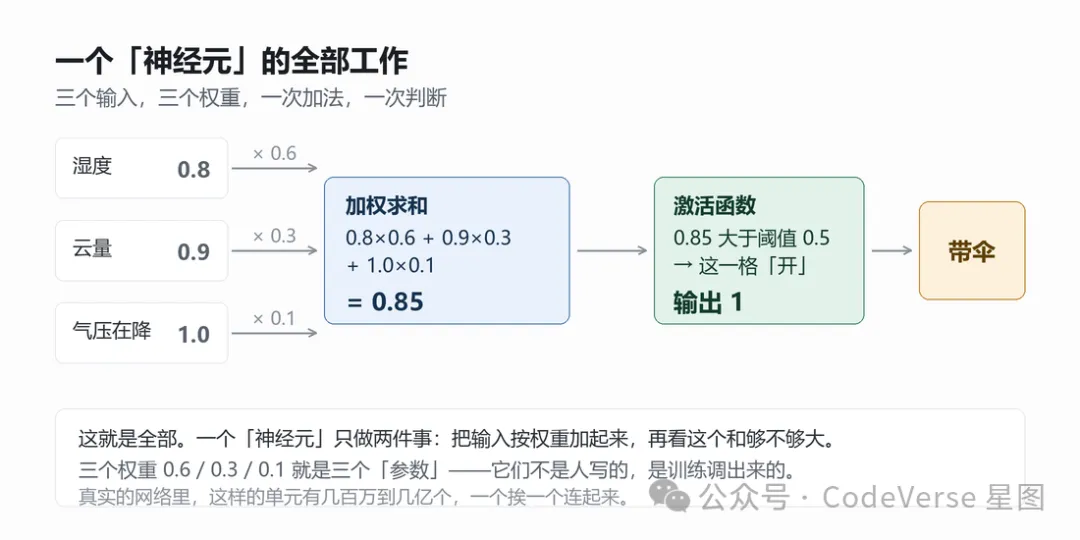
0.8×0.6 + 0.9×0.3 + 1.0×0.1 = 0.85。
这个和超过了阈值 0.5,于是输出"带伞"。
就这么点东西。写成数学式子是 y = f(w₁x₁ + w₂x₂ + w₃x₃ + b)——一次加权求和,再过一次判断。
那些 w 和 b,就是参数。上一篇文章里 70B 模型的"700 亿个参数",指的就是 700 亿个这样的数字。
这里有个关键点:没人告诉它湿度最重要。 0.6、0.3、0.1 这三个权重不是程序员定的,是训练调出来的。如果数据里显示云量其实更准,训练完之后权重会自己变成 0.2、0.7、0.1。
它是被数据改写的,不是被规则编写的。 这句话是整个领域的地基。
二、堆起来,然后加一个"拐弯"
一个这样的单元什么也做不了——它只能画一条直线。
于是把它们堆起来:一层放几十到几千个,叠几十到上百层。理论上,堆得越多,能表达的东西越复杂。
但这里有个陷阱,而且是个数学上严格的陷阱:如果每一层都只是加权求和,那么一百层叠起来,和一层完全等价。
因为一串线性变换乘起来还是一个线性变换。堆再多,也只是换了个更复杂的直线。
所以必须加一样东西:激活函数。它在每一层的加权求和之后,把结果"折"一下——负数归零、或者压到 0 到 1 之间。这个折的动作引入了非线性,堆叠才开始真正有意义。
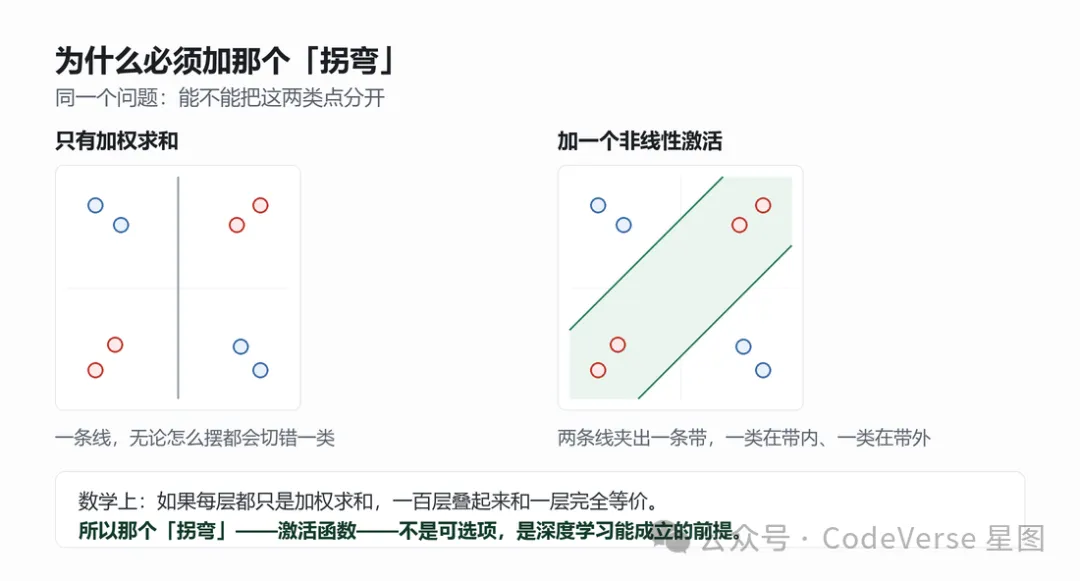
这张图讲的是 1969 年那个著名的问题:异或。
四簇点分成两类,分别在左上和右下、右上和左下。你没法用一条直线把两类分开——不管怎么摆,总会有一类被切开。
但如果你有两条线,夹出一条带,就能把一类装进带内、另一类全留在带外。而"两条线"要靠两个神经元,加上非线性才能组合出来。
1969 年,明斯基和帕佩特在《感知机》里证明了单层网络做不到这件事。这本书的语气被读成了"神经网络没前途",研究经费随之断掉,这个领域冷了十几年。
他们说的其实只是"单层不行",但没人听清后面半句。
三、它怎么学:从猜错开始
现在有一个网络,几百万个参数全是随机数。它什么都不会。它怎么学会?
四步,重复几百万次:
第一步,猜。 输入一张标着"猫"的图片,网络按当前的随机参数算一遍,输出"狗,87%"。
第二步,算差多少。 有一个函数专门量这个差距,叫损失函数。这里它就错了,差得很远。
第三步,追责。 这是反向传播干的事:从最后一层往前推,算出每个参数对这次错误"负多少责任",以及责任的方向——你该调大还是调小。用的是微积分里的链式法则。
第四步,微调。 每个参数朝减小误差的方向动一点点。动多少由一个叫学习率的数控制,通常小得可怜,比如 0.0001。
然后换下一张图,重来。
打个比方:这不是把规则讲给一个人听,而是让他做一百万道题,每道题都告诉他错了多少、偏在哪个方向,然后他把手里的每个旋钮都拧一点点。拧一百万次之后,他就"会"了。
整个过程叫梯度下降。你可以想象一个人蒙着眼睛下山,看不见路,只能用脚感觉哪个方向更斜,然后迈一小步。重复几万步,就到谷底了。
这里没有"理解",只有"调整"。它不是被教的,是被纠正的。
四、为什么等到 2012 年才成
反向传播是 1986 年就发表了的。但神经网络真正起飞,又等了二十六年。
中间发生了什么:
关键在 2012 年那一次。AlexNet 用的还是卷积网络,思路和 1989 年没有本质区别。它赢在别的地方:
数据:ImageNet 有 120 万张人工标注的图片,1000 个类别。以前的数据集只有几万张。 算力:两块消费级 GPU(GTX 580)。这件事以前只能用 CPU 慢慢磨。 技巧:ReLU 激活函数缓解了深层网络的梯度消失,Dropout 抑制了过拟合。
想法在 1986 年就有了,缺的是让它跑起来的东西。 这也是为什么 2012 年之后进展突然变快——不是人突然变聪明了,是数据和算力同时到位了。
五、它和 AI 到底是什么关系
这才是最容易混淆的地方。
三个词不是并列的,是套娃:
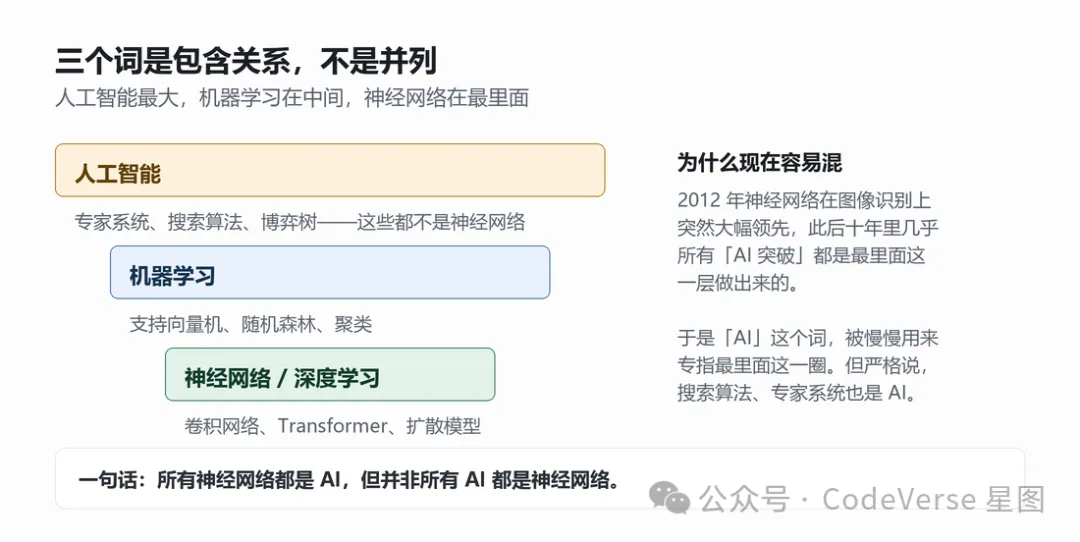
人工智能是最大的那个圈:让机器做那些原本要人来做的事。
机器学习是其中一种做法:不写死规则,而是给例子让它自己找规律。
神经网络是机器学习里的一种具体方法:用一层层的加权求和来拟合这些规律。
关键在于,AI 里面有很多东西不是神经网络:
深蓝下赢卡斯帕罗夫,靠的是搜索加评估函数,一行神经网络都没有 早期的专家系统,是几百条 if-then 规则堆出来的 你手机里的地图导航,是图上的最短路算法
它们都算 AI。只是 2012 年之后,几乎所有被称为"AI 突破"的进展,都是神经网络做的。于是"AI"这个词慢慢被用来专指最里面那一圈。
所以准确的说法是:所有神经网络都是 AI,但并非所有 AI 都是神经网络。
今天说的大模型,也只是这一圈里的一个具体品种:神经网络 + Transformer 结构 + 海量数据 + 海量算力。
六、它擅长什么,不擅长什么
擅长的:模式识别——这张图是不是猫、这段语音说了什么、这句话是好评还是差评。还有一类更微妙的:模糊映射,比如"把这段话改得更礼貌但不改变意思"。这类事传统编程根本写不出来,因为你没法用 if-then 描述"礼貌"。
不擅长的:
精确计算。让它算 347 × 289,它可能给你一个"看起来很像"的错数。因为它的输出是概率分布里抽出来的,不是算出来的。 需要绝对保证的场合。它给的是"很可能对",不是"一定对"。 没见过的输入。训练数据里没有的情况,它照样会自信地给答案。 解释自己。你知道第 3741 号参数是多少,但你不知道它在干什么。七千亿个参数,没有一个对应"猫"这个概念。
这些不是暂时的缺陷,是方法的性质决定的:它的本质是在拟合一个函数,不是在理解一套规则。
乐昆(Yann LeCun)说过一句被反复引用的话,大意是:深度学习没那么了不起,它本质上就是曲线拟合。
七、为什么"模仿大脑"这个说法有害
回到开头那个名字。
生物神经元长什么样:树突接收信号,轴突把信号传出去,通过突触连接到上千个其他神经元;信号是电脉冲,有时间上的累积和抑制,还牵扯几十种神经递质。
人工"神经元"长什么样:一个加权求和,加一个激活函数。
就这两样。 它没有时间维度,没有脉冲,没有连接结构,也没有任何化学过程。
真实的相似点只有一个:大量简单的单元连在一起,能涌现出单个单元没有的行为。 这个洞察是真的,而且是整个领域的起点。
但把"神经网络"这个词用下去,会带来一个很贵的误解:人们会以为它有意图、会思考、在"理解"你说的话。
它没有。它是在做一件很具体的事:给你大量的输入输出对应关系,它找一个函数把两者连起来。 训练就是找这个函数,推理就是用它算一次。
结语
神经网络不聪明。
它是一堆加法和乘法,加一个把结果折一下的小函数,然后被反复纠错纠了几万亿次。
但它确实做成了很多原本只有人能做的事。而这个"做成"的方式,和你想象的完全不一样——它不是想明白了才做对,是先做,再被纠正,直到看起来像想明白了。
下次看到"AI 又突破了",你可以这样翻译:一堆乘加,又在更多例子上被调准了一点点。