ARTICLE · 1294381
OpenAI金融负责人:AI做金融,难的已经不是“别出错”,而是品味
一句话:OpenAI ChatGPT金融服务负责人之一约瑟夫·金在Latent Space的纽约现场说,会断送职业的事实错误,模型已经越来越少犯,它现在缺的是“这张幻灯片看着就不对”的品味;他们的办法很老派,找人两两比较幻灯片训奖励模型。他还说,评测分数涨了研究员往往不去查,GPT-6跑金融评测分数没怎么动,一查才发现是评测坏了。
Latent Space本期画面:金说,模型现在缺的不是不出错,而是人的判断和品味
“模型今天还缺、还需要提升的,其实不是会断送职业的错误,而是需要人的判断和品味的那部分。”
金融圈有个流行的说法:一个错误交上去,整个职业生涯就完了。照这个逻辑,AI进金融最大的门槛应该是“别出错”。可在OpenAI做金融产品的约瑟夫·金看来,最要命的那类错误,模型已经越来越少犯了,真正难的是一件更软的事:做出来的东西“没错,但看着不对”。
约瑟夫·金(Joseph Kim)是OpenAI ChatGPT金融服务(ChatGPT for Financial Services)的负责人之一。主持人介绍说,他是研究出身,如今带着这块业务的产品和工程;他在节目里提到自己在谷歌干过。这个产品今年9月10日发布,主打企业客户,设计合作方是摩根士丹利和Evercore。
这期节目是Latent Space在纽约AI Engineer大会现场录的,10月中旬录制,2026年10月31日发布,约28分钟。主持人是swyx和Latent Space的编辑负责人理查德·麦克马纳斯(Richard MacManus)。金刚在大会上做完主旨演讲,对话从金融推理数据聊起,谈到产品怎么做、安全怎么管、品味怎么训、评测为什么难。本文先讲品味和评测这条主线,再补上产品和安全两块。
“没错,但看着就不对”
swyx问:金融圈有种误解,觉得一个错误会层层放大,“交错一样东西,你整个职业生涯就有风险”。抱着这种心态的分析师,该怎么开始用这些工具?
金说,他觉得“一个错误职业就完了”这个说法本身就不对,不过先假设它是真的。即便如此,错误也不都一样,模型的能力也不都一样。能断送职业的错误,通常是你把一条事实弄错了,而这条事实改变了结论。他说,“幻觉”是2022、2023年常被提起的词,现在已经没那么常听到了,模型在事实错误上的可靠性“正在大幅提升”。(编者注:幻觉指模型一本正经地编造不存在的事实。)
他说,这种进步加上金融机构现有的层层复核,会让这类错误一路传到MD那里的概率“非常低”。(编者注:MD即董事总经理,投行里最高一级的业务负责人。)
“模型今天还缺、还需要提升的,其实不是会断送职业的错误,而是需要人的判断和品味的那部分。”他举的例子是:“这张幻灯片很丑。”它没错,可格式上颜色有点不对劲,整体看着粗糙,所以这不是一张好幻灯片。
这不会让人丢饭碗,但他说,“它仍然要紧”,关系到这份活到底有多大用处。他预计到2027年,模型在品味上会好很多,尤其是那些更“软”的目标:“不是对或错,而是比较:有没有比这更好的?”
品味怎么训?找人两两比较
主持人追问:怎么把品味训进模型?
金说这事挺有意思:很早的时候,也就是RLHF刚兴起那会儿,模型训的“基本上只有品味”。那时靠的是基于人类反馈的强化学习(RLHF),人类反馈永远是两两比较:给两个选项,哪个更好?后来有了可验证奖励、各种环境,大家造了一大堆别的机器,反倒忘了强化学习最早就是围绕人的品味做起来的。(编者注:强化学习是让模型按“奖励”信号反复试错来改进的训练方法;可验证奖励指答案对错能被程序自动判定的奖励,比如代码能不能跑通。)
“技术上的答案很简单,实际做起来当然复杂得多。”他说,办法就是训一个奖励模型(reward model):找一批人看成对的东西,说哪个更好,“这招现在依然管用”。(编者注:奖励模型是专门给主模型的输出打分的模型,主模型再照着这个分数去改进。)
他透露了一个“趣事”:他们做幻灯片就是这么干的。怎么让模型更会做演示文稿?找一批人看成对的幻灯片,说哪张更好看。
“人在审美判断上其实非常非常厉害,比模型强得多,这是我们发现的。”他说,人看两张幻灯片,几秒钟就能说出哪张更好;换成一个评分模型来做,“它会花一大堆推理token,琢磨这些像素这样、那个东西那样,然后可能还得出错误的结论”。(编者注:token是模型处理文字的基本单位;推理token指模型在给出答案前“思考”时消耗的token。)
图:访谈视频截图(16:50)
所以他说,人在让模型变好这件事上仍然非常有价值,他们会大量依靠人的偏好,把品味这类东西灌进模型。
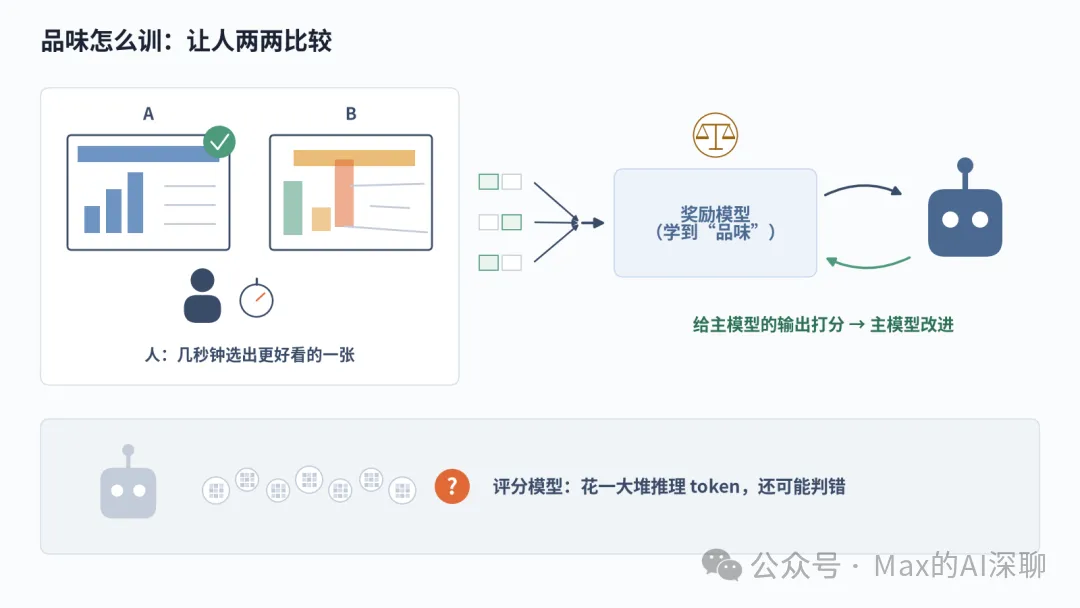
幻灯片好不好看,金说人比模型判断得又快又准,所以OpenAI靠人的偏好来训(示意)
编程已经走过一遍
金说,让他们有信心的是,这条路有先例,就是编程。
他说,编程还没完全解决,“但比方说我们走到了80%,正在攻剩下的20%”。编程是可验证奖励加人的品味:代码能不能编译、有没有语法错误、函数输出是不是预期的,这些都能自动检查;可好的软件工程还在于系统设计干不干净、能不能长期维护、好不好做单元测试、是不是符合业界大多数人认可的范式。
他说,很多金融工作长得很像:一个Excel模型,加总对不对、有没有引用错误,这些都能检查,算是过了第一道“合理性检查”;但还有很多是“这是不是我会搭的那种模型”。
他进了金融圈才学到一个说法,叫模型的“手感”:有经验的从业者会去扰动输入、看输出怎么变,从而判断数据在这个模型里流得顺不顺,“感觉对不对”。他说,这种人的偏好跟“这段代码干不干净、写得好不好”非常像,“我们在编程上的成功,让我有信心在金融上也能解决很多这样的问题”。
2027年,往associate和MD的活走
麦克马纳斯接着问到金的另一个2027年预测:模型会更擅长提出投资论点、产生投资和交易想法。可这恰恰是老练的金融人靠直觉做的事,而且往往和主流看法唱反调,不然很难有高回报。
金说,到目前为止,AI在金融里的绝大多数应用,都集中在初级分析师的活上。一是产品得按今天模型的能力来做,而今天的模型很擅长照着具体指令执行,比如“给我做一张幻灯片,要这个样子,做好看点,用我们的模板”;二是大家更想让模型去做人不擅长、不爱做的事。他说,他聊过的大多数人(当然也有例外)都不爱搭Excel模型,那活又枯燥又抠细节,很容易出错;做幻灯片也一样,复制logo、精确地摆到页面某个位置,很磨人。
“我觉得这两方面低垂的果子,我们摘了不少了。所以进入2027年,我们要开始往上走了。”他说,要从初级分析师能做的活,走到associate能做的一部分活,再到MD会做的一部分活。(编者注:associate是投行里分析师之上的一级,负责复核分析师的工作。)
越往上,目标就越模糊:从“这张幻灯片明摆着好不好、能不能放到客户面前”,变成“我不知道这个投资想法好不好”,可能得等上3年,看市场怎么走,才能给出明确答案。他说,这让训练变难了,从研究角度更难,“但我想说的是,并不是不可能”。这需要大量研究投入、大量好数据、大量领域专家的反馈,“我们真的想拿到P99.9那种水平的反馈”,让模型和人一样好。(编者注:P99.9指排在前0.1%的顶尖水平。)
分数好看,没人去查
swyx问他怎么看现有的金融基准。
金说,评测(eval)是他“心头所好”,花了很多时间在上面。他想先给大家一个前提:做一个好评测难得惊人,没做过的人往往想不到。你搭出来的东西只是想测的那项能力的一个代理指标,而且只是一个维度;标准答案和评分方式又特别费劲,评分做不对,模型就很容易刷分(reward hack),评测分数很高,真本事却很差。(编者注:评测即用一套题目给模型打分的测试;刷分指模型钻评分规则的空子拿高分,却没真正学会。)
他说,他们认为今天还没有一个真正好的金融评测。他提到OpenAI自己做过的GDPval,测的范围更广,是知识工作:“你们去看Astra的发布,我们没提GDPval。我们知道这个评测已经完全饱和了,没饱和的那部分基本上是坏的。所以我们其实不报这个分了,也不再跟踪它了。”(编者注:GDPval是OpenAI做的一套评测,用真实职业任务考模型;饱和指模型分数已经接近满分,再也拉不开差距。Astra指OpenAI今年9月发布的GPT-6 Astra。)
他还讲到评测里的一种偏差:“如果数字好看,研究员就默认模型变好了,不会去查。如果你做出了一个强得多的模型,评测数字却不好看,或者没涨到你想要的幅度,你才会去查。”
图:访谈视频截图(24:32)
他说GPT-6就碰上了这种事:拿GPT-6跑一组金融评测,数字没怎么变,“我们就想,这是怎么了?来看看这个评测”。深挖下去,发现很多东西是坏的:基本上评测已经被他们做饱和了,模型答错的那些题,原因是标准答案错了、题目没说清楚,或者评测本身有别的毛病。
所以他的团队现在在做一个好得多的评测,要能真正预测某个职业的工作能不能被自动化。比如一个投行评测:如果在上面得分高,“你大概就能把投行初级分析师的很多工作自动化了”。
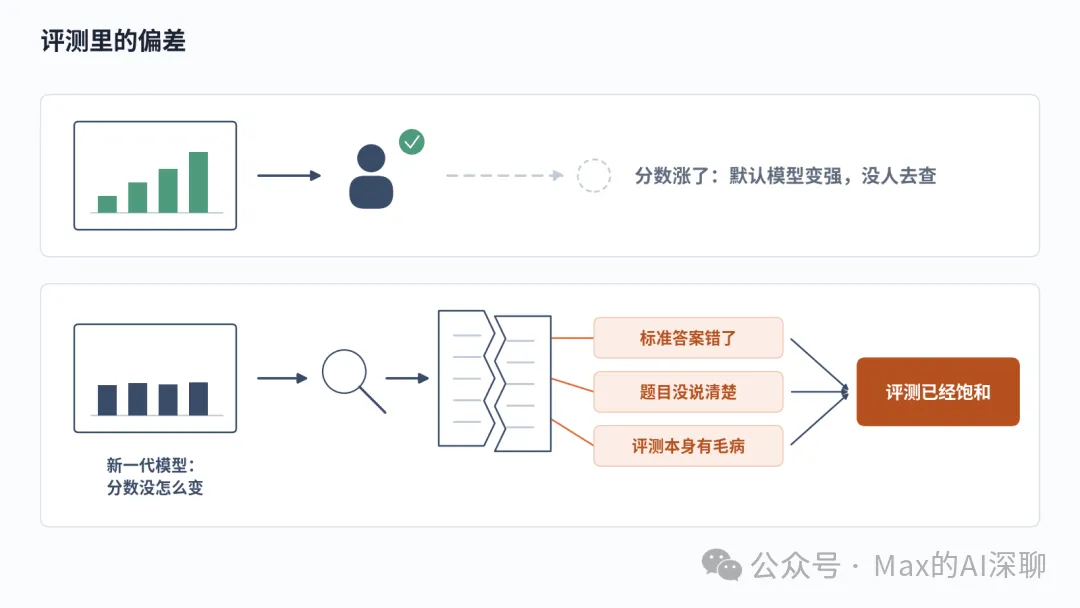
金说GPT-6跑金融评测时就碰上过这种事:分数不动,深挖下去,问题出在评测上(示意)
内部Codex:金融法务销售,从0跳到约90%
回到对话前半段。金在主旨演讲里放过一张图,是OpenAI内部Codex的使用率。(编者注:Codex是OpenAI的编程智能体;智能体指能自己规划、调用工具、连续执行任务的AI程序。)
他说,软件工程的曲线很平稳地往右上走,大家慢慢把它用进日常工作。可金融、法务、销售那几条线,“基本一直在0”,然后突然差不多跳到了90%。看跳上去的时间点,正是他们2月发布Codex桌面版的时候。他说,这说明模型和产品得一起做,产品的意义就是让模型的智能被尽可能多的人用上。
有的大牌MCP,错误率40%以上
麦克马纳斯问,从金融场景用Codex的这波数据里学到了什么。金说,做ChatGPT金融服务这半年,他最大的体会是做企业产品得面对所在行业的现实,光从第一性原理推,推出来的东西再有道理,忽视行业里的各方力量,也做不出对的产品。
他举的例子是数据。他想把季度财报电话会的文字稿打包进产品,大家第一反应是:商店里已经有MCP连接了,你打包进来有什么增量价值?客户可能已经有授权,会觉得付了两次钱。“纸面上看,这很不好看。”(编者注:MCP即模型上下文协议,一种让AI模型接入外部数据和工具的标准接口。)
“现实是,我们去把这些MCP都测了一遍,发现错误率真的非常非常高。我们接的一些MCP,有些是大牌,错误率40%以上。”所以他们决定,唯一能规模化解决的办法,是把数据收进自家,端到端控制体验,多付的钱是值得的。他说客户很认,提得最多的就是数据。
图:访谈视频截图(06:02)
“95%的东西,创业公司也能做”
swyx问,如果有人想在法务、销售等别的领域照着做一遍,有什么经验。
金说:大家爱聊后训练,因为那是OpenAI独有的,“但我们做的东西里有95%,绝对是一家创业公司、另一家公司也能做的”,他们并不需要靠改模型来做出好产品。(编者注:后训练指模型预训练完成后,再针对具体任务和行为做的训练。)
他说,产品大部分是搭在ChatGPT的插件架构和基础组件上的,他的团队某种程度上就像一家在OpenAI技术上创业的公司。团队的判断是,Codex能把你带到一个能在市场上成功的产品的大约80%,剩下20%缺着;“如果你直接拿Codex当金融产品发布,它会失败”,所以那20%才是关键。
他说:“我真的觉得,会有一家十亿美元级的公司建在ChatGPT插件上。”通用的功能都现成,你只要在上面加自己的秘方,可能是数据,可能是界面改动,也可能是一个集成。
让模型像新员工一样,逐级拿权限
麦克马纳斯问到安全。金说,现在发布的产品是给知识工作者的效率工具,背后有个很深的前提:永远有人在环。分析师每天一长串待办,每一项先让ChatGPT做,可能做到30%,可能做到80%,看任务而定,但审核和复核的责任交在人的手里。(编者注:人在环指AI的产出始终要经过人审核把关。)
他说,他们在想下一步,而下一步和一个时刻被人盯着的效率工具不一样。他们的思路是:大家最直觉就懂的,是怎么跟人共事,所以要把产品的安全设定做得像一个人。
一是读写权限,人也有。他说,你作为新工程师进一家公司,往往要先过一些关,他在谷歌时需要一个叫可读性认证(readability)的东西,系统里有各种制衡,过了才能动系统。“如果模型表现得更像人,你就能用上这些现成的系统。”(编者注:可读性认证是谷歌内部按编程语言授予的代码规范资格,没有这项资格的工程师,提交的代码要由持证同事额外审核。)
图:访谈视频截图(11:22)
二是投行本来就有一套层级:初级分析师打底,活交给associate复核,associate加上自己的判断,再交给VP,VP往上到董事、董事总经理,层层之间有隐性的复核。“人犯的错误和模型一样多”,这些系统本来就是为防人犯错建的,他们也会大量借用。
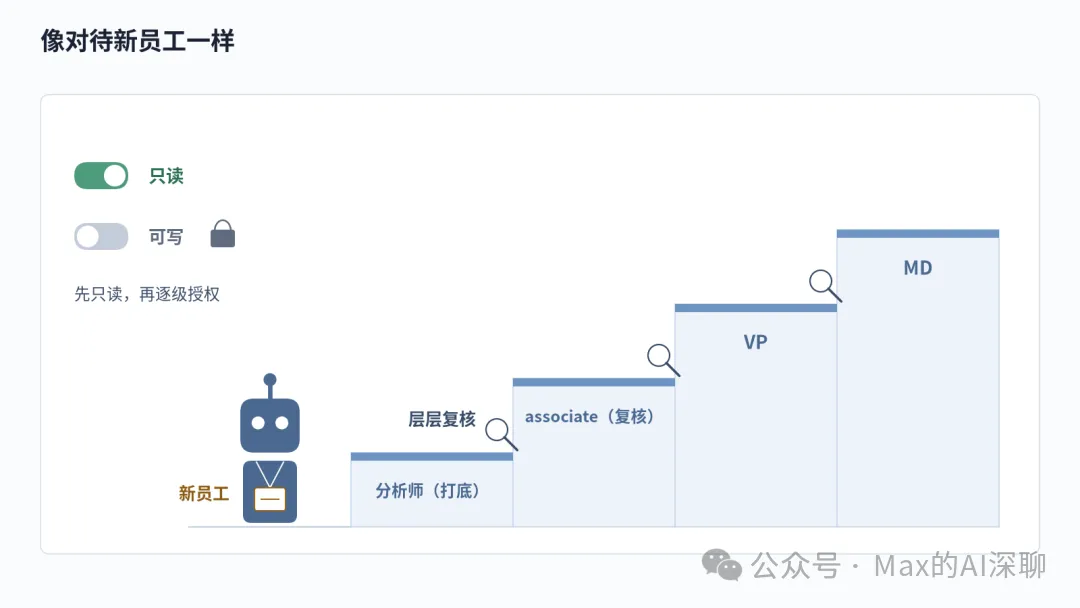
金的思路:投行本来就靠层级互相把关,让模型照人的规矩一步步拿权限;今天的产品默认仍有人在环(示意)
写在最后
整场对话听下来,金反复在讲同一件事:AI在金融里的难题,正在从“对不对”转向“好不好”。事实错误能靠可靠性提升和层层复核兜住,品味却很难让程序判分,得回到最老的办法,找人一对一对地比;评测也一样,分数涨了反而没人去查。
也得留个心眼:这些是OpenAI自家产品负责人的说法,“约90%”“40%以上”“95%”“80%”都是他在节目里的原话和估计,2027年往上走是他的预期,他说的是“并不是不可能”,产品今天的默认设定仍然是人在环,并不是AI已经能顶替分析师。
如果你是做金融或者做PPT的人,你觉得自己最难被替代的,是不出错,还是那一眼就看出“这张不对”的手感?
————————————————————
原始来源:Latent Space(纽约AI Engineer大会现场),主持人swyx、理查德·麦克马纳斯(Richard MacManus),嘉宾约瑟夫·金(Joseph Kim,OpenAI ChatGPT金融服务负责人之一),2026年10月31日发布,时长约28分钟。
视频:https://www.youtube.com/watch?v=v-d1WTqIULs
文字稿:YouTube自动英文字幕(关键段落经对照视频校对)
这期的播客版在小宇宙「Max的AI深聊」,搜一下就能听