ARTICLE · 1294953
如何用 AI 完成音乐母带处理
混音、降噪、母带和发布:音乐制作的“最后一公里”到底包含什么,AI 又是如何改变它的。
如何用 AI 完成音乐母带处理
混音、降噪、母带和发布:音乐制作的“最后一公里”到底包含什么,AI 又是如何改变它的。
如今,你用一台笔记本、一件乐器和一支麦克风就能做出一首歌,有些人光用手机也能做。但要把这首歌“做完”,做到能和播放列表里其他歌放在一起毫不逊色,就难多了。从粗糙的录音到发布之间的这一段,就是音乐制作的“最后一公里”。
传统上,走完这一段有两条路。一是自己学:这意味着刷上无数小时的 YouTube 教程、在 Logic Pro 这类软件里学习混音和母带工具,还要花好几年训练你的耳朵,直到你信得过它。二是花钱请专家:专业母带处理通常每首约 500 美元,你还得等。
对大多数独立音乐人来说,两条路都不太合用。一条费时间,一条费钱。而且,音乐人不是用压缩器参数的思维来思考的。他们用的是“更暖一点”“更有劲”“别那么糊”“人声多一点空气感”这样的词。
我所在的实验室,多年来一直在研究这道鸿沟:音乐人用语言描述声音的方式,和工具让他们能控制的东西之间,隔着一道缝。这篇文章我会带你走一遍“最后一公里”的每一步,并指出现如今 AI 在哪里帮上了忙。
产品演示:Sequential AI 从音频上传、自然语言调整到母带导出的工作流程。该图片展示产品界面,不代表所有曲目都能获得相同效果。
音乐制作的“最后一公里”包含什么
一首歌写完、录完之后,在任何人听到它之前,还有四件事要做。
1. 混音(Mixing)。 混音是把一首歌的各个部分彼此平衡:人声和吉他之间、底鼓和贝斯之间。每个部分都有自己的音量、在立体声场里的位置和音色,好让所有东西都听得见。一旦做砸了,一段绝佳的人声会淹没在拥挤的混音里,或者一段在录音棚监听上听着没问题的混音,一到耳机上就垮了。
2. 降噪与修复(Denoising and restoration)。 家庭录音会沾上廉价声卡、背景里嗡嗡作响的冰箱或空调、卧室的回声,或者电平推太高造成的失真等各种杂音。尽早清理很重要,因为后面每个环节都会把它放大。越来越多的音乐一开始就是家庭或手机录音,所以这一步只会越来越重要。
3. 母带处理(Mastering)。 母带处理是把混好的成品准备到可以发布的状态。它调整音色平衡(太轰、太刺、太闷)、动态、响度和立体声宽度,并让一张 EP 或专辑里的歌听起来像是一家人。这里没有固定正确答案。工程师会根据曲风、根据艺人想要的效果,做出几十个小小的判断。
4. 发行(Distribution)。 然后,这首歌得送到听众面前。它要以正确的格式导出,配上元数据和封面图,再投递到各大流媒体平台。
这几个步骤,传统上每一个都需要各自的工具和技能,往往还得由不同的人来做。
为什么“暖”对电脑来说很难
音乐人会用“暖、亮、糊、通透、有劲、单薄”这类比喻来描述声音。工程师要花好几年学习这些词如何转化为具体的调整。大致来说,“糊”通常指低频中段能量过多,“亮”指高频内容更多,而“有劲”关乎鼓的击打和衰减方式。
这些转换取决于具体是哪一首。给一首偏暗的原声抒情歌“加暖”,和给一个本来就低频很重的 trap 节拍“加暖”,是完全不同的活儿,同一个词可能要求相反的操作。
基于预设的工具在这方面很吃力。一个预设把一个词绑死到一条固定的处理链上,然后对每一首歌都用同样的方式套上去。
预设对“让它更暖”只给一个答案。而一位好工程师会先问:相对于什么更暖?
音频-语言模型从大量“音频配描述和编辑”的样本里学习。由此,它们学会一个词对眼前这个具体声音意味着什么,从而能够执行一条模糊的、人类式的指令。
修复 vs. 重新生成
传统修复工具做的是减法。降噪器估算出嘶嘶声再把它减掉,去混响工具试图把人声直达声和房间声分开。这对轻微问题有效。但减法没法把从未录进去的细节找回来,比如廉价手机麦克风丢掉的高频。
生成式模型已经学会了“干净、录制良好的音乐”是什么样子,所以它们既能去噪,也能补上听起来合理的、缺失的细节。这就是为什么一段手机录音处理完,听起来像是在一个好得多的房间里录的。
风险在于,模型会偏离原始演绎。它必须忠实于音乐人实际弹奏和演唱的东西。把握这个平衡,至今仍是一个开放的研究问题,也是我们实验室在做的事情之一。
落到实处:Sequential AI
据开发团队介绍,Sequential AI[1] 将这条“最后一公里”整合到一个工作流中。用户上传歌曲后,系统会尝试平衡人声与伴奏、清理噪声并完成母带处理;还可以通过“让混音更暖一点”“把贝斯提出来”等自然语言指令继续调整。实际效果会受到原始录音质量、曲风和目标平台等因素影响,仍需人工试听确认。
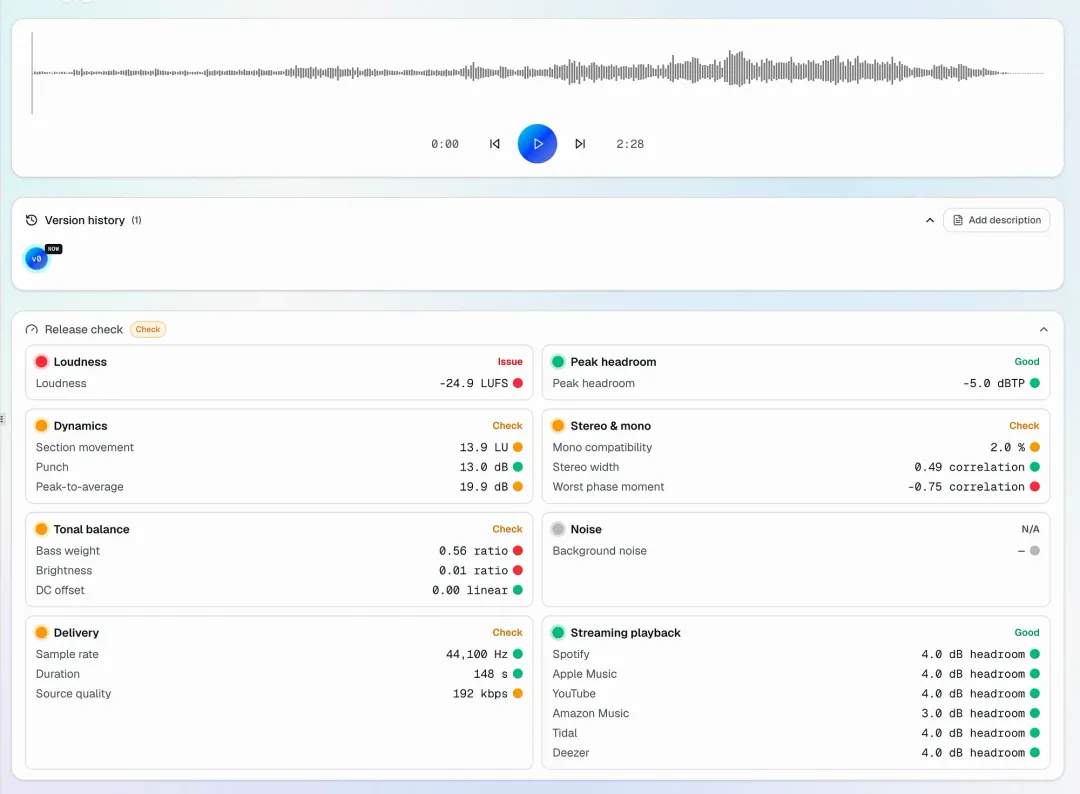
一个制作面板会把结果拿去和母带工程师会检查的那些东西逐项核对:
响度与峰值余量: 整体 LUFS 和真峰值,有异常时会标出来
动态: 各段落起伏多少、冲击感、峰均比
立体声与单声道: 立体声宽度、单声道兼容性,以及相位最差的那些瞬间
音色平衡: 低频重量、亮度、直流偏移
噪声: 背景噪声水平
交付: 采样率、时长、源质量
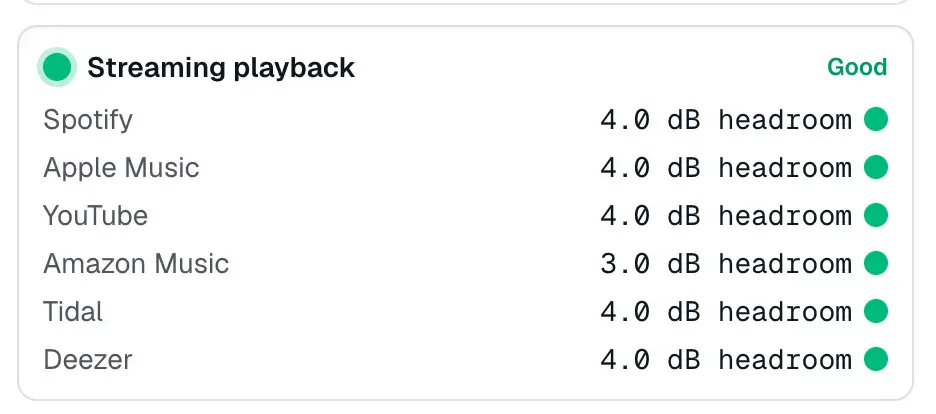
流媒体播放: 针对 Spotify、Apple Music、YouTube、Amazon Music、Tidal 和 Deezer 的响度目标,看你还剩多少余量
此外还有一个“音乐智能”面板,提供对音乐本身的洞察。
我们的模型是怎么工作的
我二十多年前就做出了自己的第一个音乐生成模型(我是认真的,想了解那个模型可以看这里[2]!),那时候大多数人还觉得 AI 音乐是科幻。自那以后,我的研究一直在追问:机器能不能理解和创作音乐。目标始终是为音乐人打造工具。
Sequential AI 跑的是我们自己建的母带和音乐智能模型,而不是别人的模型。它们来自“音频、音乐与 AI 实验室”(AMAAI Lab)多年来在“连接音乐、语言与情感”上的研究。
大多数自动母带工具都是套一条固定的信号处理链,再调几个设置。我们的模型接收你的音频和一段文字指令,直接用基于流的扩散模型(flow-based diffusion model)生成改善后的音频。
因为模型把语言和声音连在了一起,同一个系统就能通过同一个文本框完成许多任务,包括均衡、动态、响度、立体声宽度,以及噪声、混响这类修复问题。
我们即将完成一个更大规模下一代模型的训练。它能更好地处理多样曲风、手机录音和嘈杂音频,也能遵循更细致的指令。
如何用 AI 给一首歌做母带:一套实用流程
这些习惯对任何工具都适用。
留足余量。 导出时总线上别挂限幅器,峰值留到零以下几个分贝。如果混音本身已经被压扁了,母带就没剩多少可操作的了。
先在混音里解决大问题。 母带能让一首歌更精致,也能救回一段粗糙录音,但当编曲和平衡本身已经差不多到位时,它效果最好。
描述你想听到的效果。 “让人声更靠前一点”对 AI 模型来说,比“把 3 kHz 提起来”信息量更大。
一次只改一样。 提一个要求,听一遍,再提下一个。你会逐渐搞清楚每条指令对你的歌做了什么。
在同等响度下比较。 我们的耳朵倾向于偏好更响的那个版本,所以一个母带可能只是因为更响就显得更好。做决定前先把电平对齐。
在多个系统上试听。 耳机、笔记本扬声器和车载音响,各自会暴露出不同的问题。
瞄准流媒体的目标。 大约 -14 LUFS 整体响度、真峰值低于 -1 dBTP,在 Spotify 和 YouTube 上回放都很干净,在 Apple Music 上也只需做很小的调整。(RoEx[3])
响度战争已经结束(某种程度上)
几十年来,唱片越来越响。工程师把每一个分贝都榨出来,因为一首更响的歌在电台和商店里显得更带劲——而音乐也在这一路上丢掉了动态。
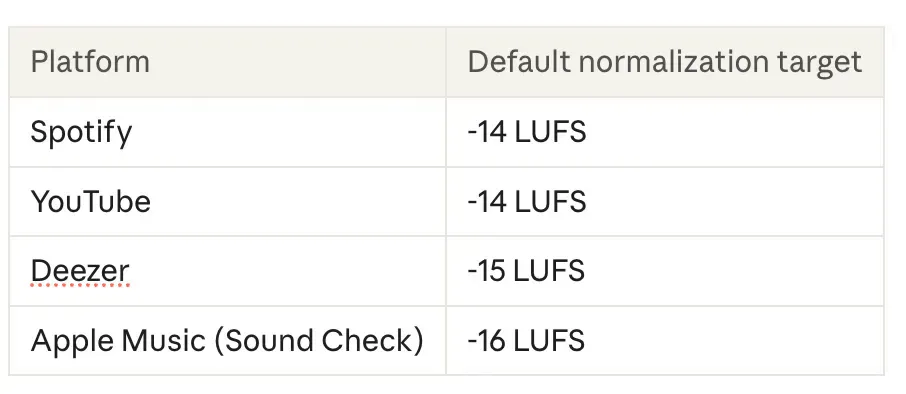
流媒体改变了这一切。平台会用 LUFS(相对满刻度的响度单位)测量每首歌的感知响度,再把它调高或调低到一个统一水平,这样听众就不用一首歌一首歌地调音量。Spotify 和 YouTube 归一到 -14 LUFS,Deezer 是 -15,Apple Music 是 -16。
一首做到 -6 LUFS 的极响歌曲,在 Spotify 上会被调低 8 dB。结果它并不比周围的歌更响,而且听起来更扁平,因为被挤掉的动态回不来了。(RoEx[4]、MasteringBOX[5])
在流媒体平台上,一个更响的母带并不会听起来更响,只会听起来更扁。
现在的目标,是在平台将要播放的那个音量上,达到尽可能好的声音。Sequential AI 的制作面板会替你测量这一点,并针对每个主流平台,显示你的母带相对于该平台目标还剩多少分贝余量。
模型还能从一首歌里听出什么
母带只是我们实验室工作的一部分。我们很多研究,是在看模型仅仅通过“听”一首歌,能学到什么。
情感(Emotion)。 音乐里的情感通常有两种标注方式:一种是用开心、悲伤、紧张这样的类别;另一种是两个维度——效价(valence,感觉有多正面)和唤醒度(arousal,有多澎湃)。大多数数据集只用一种体系,这让它们很难合并使用。我们的 Music2Emo 模型同时在两种标注上训练,因此能从多得多的数据里学习。既然两个人听同一首歌会感受到不同的东西,这类模型预测的,就是听众倾向于感知到什么。(论文[6]、演示[7])
流行度与审美质量(Popularity and aesthetic quality)。 我在热单预测上研究多年,第一篇相关论文[8]发表于 2014 年。AI 音乐平台改变了这个问题。如今每天都有成千上万首歌冒出来,背后没有艺人名气,也没有唱片公司。
我们的 APEX 模型,是在 Suno 和 Udio 生成的超过 21.1 万首 AI 歌曲、约 1 万小时音频上训练的。它预测参与度(播放量和点赞),同时预测五种审美品质:连贯性、音乐性、易记性、清晰度和自然度。加入这些审美品质后,模型在预测人们更喜欢哪些歌上表现更好,即便是它训练时从未见过的音乐生成器做出的歌。(论文[9])
没有模型能保证一首歌会火。时机、受众、KOL 和推广都扮演着重要角色。我们把这类分数看作对一首歌的反馈。
可控生成(Controllable generation)。 我们的文本到音乐模型 Mustango,能让一段文字提示设定具体的音乐元素,比如和弦、速度和调性,以及整体风格。(论文[10])
来自这些研究的情感分析和走红潜力分析,很快会出现在 Sequential AI 的面板上。
从实验室到公司
Sequential AI 在新加坡科技设计大学(SUTD)的 GAP 计划下孵化,该计划帮助研究团队把成果商业化。我们还完成了由新加坡国立大学(NUS)Virginia Cha 教授主导的 ARISE 验证与创业营计划,它把我们推出实验室去和音乐人交流。有两个要求被反复提到。艺人们想用自己的话控制声音,也想救回那些因为噪声而被他们放弃的录音。不过当我们给他们演示这个平台时,最让他们惊讶的,反而是那些“音乐智能”功能。
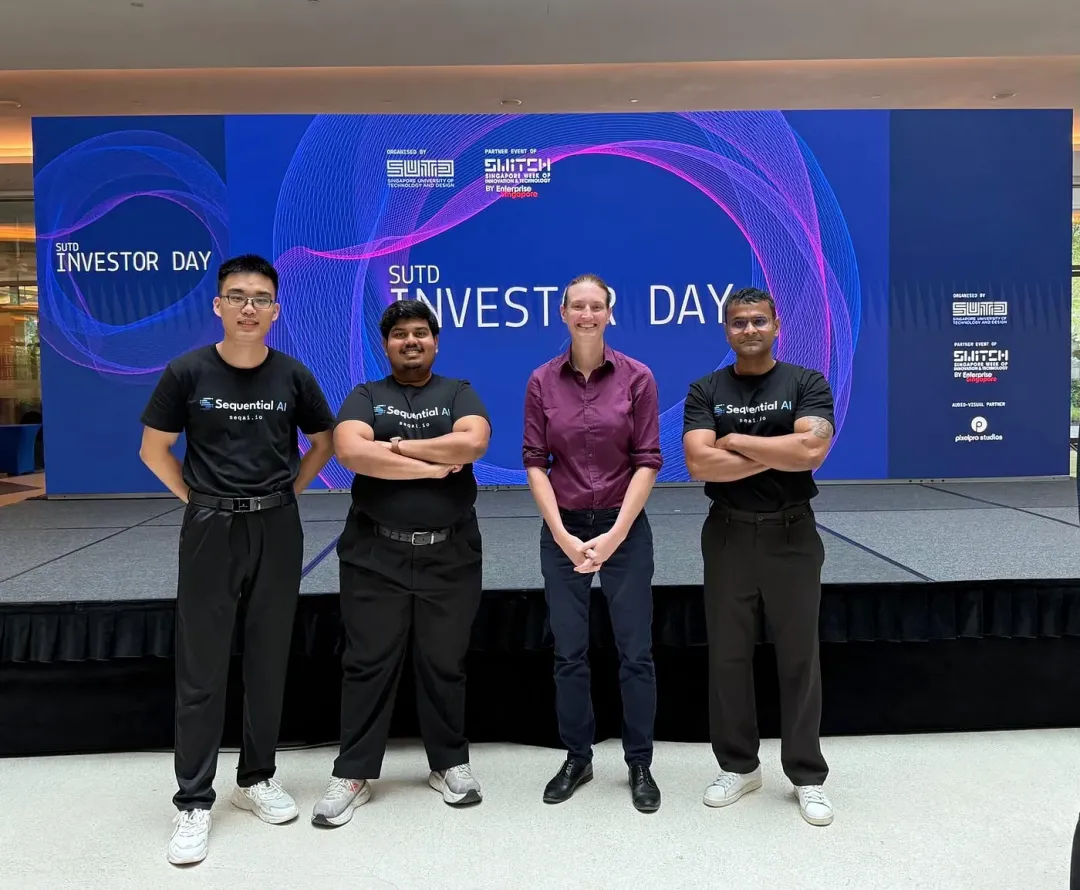
团队:
Abhinaba Roy 博士(联合创始人):AI 研究科学家,专攻用于音频分析的机器学习和信号处理。
Ambuj Mehrish 博士(联合创始人):AI 研究科学家,研究深度学习、自然语言处理,以及支撑我们核心技术的多模态系统。
Shi Qilun(产品工程师):负责 UI/UX 和产品管理,收集用户反馈并负责市场。
Roshan Emmanuel(产品工程师):负责平台的全栈开发,同时作为一位受过训练的钢琴家,主导对平台音乐输出的评估。
Dorien Herremans 副教授(创始人;也就是我):领导 AMAAI 实验室,并制定研究与产品方向。
你可以在 seqai.io/team[11] 找到我们。
接下来,以及你能怎么帮忙
我们的路线图上:
分轨级母带(Stem-level mastering): 对人声、鼓、贝斯和乐器分开控制
参考匹配(Reference matching): 上传一首你喜欢的歌,得到一个方向相近的母带
更大的模型: 更好地处理多样曲风、困难录音和细致指令
面板里更多的音乐智能, 包括情感和热单潜力
Sequential AI 在公测期间免费。如果你做音乐,拿你自己的一首歌在 seqai.io[12] 上试试,然后告诉我们哪些好用、哪些不好用。我们会读所有反馈,并把它用在下一个版本里。
Dorien Herremans 副教授,Sequential AI 联合创始人、SUTD 的 AMAAI 实验室负责人
参考资料
原文作者:Dorien Herremans来源平台:AI Advances(Medium)阅读时长:9 分钟发布日期:2026-10-22原文链接:https://aiadvances.org/how-to-master-your-music-with-ai-e84aabffa4e6[13]
引用链接
[1]Sequential AI: http://seqai.io
[2]这里: https://dorienherremans.com/sites/default/files/Thesis.pdf
[3]RoEx: https://www.roexaudio.com/blog/what-lufs-should-i-master-at
[4]RoEx: https://www.roexaudio.com/blog/what-lufs-should-i-master-at
[5]MasteringBOX: https://masteringbox.com/learn/mastering-for-streaming
[6]论文: https://arxiv.org/abs/2502.03979
[7]演示: https://huggingface.co/spaces/amaai-lab/music2emo
[8]第一篇相关论文: https://www.tandfonline.com/doi/full/10.1080/09298215.2014.881888
[9]论文: https://arxiv.org/abs/2605.03395
[10]论文: https://arxiv.org/abs/2311.08355
[11]seqai.io/team: https://seqai.io/team
[12]seqai.io: https://seqai.io
[13]https://aiadvances.org/how-to-master-your-music-with-ai-e84aabffa4e6