ARTICLE · 1298575
AI决策治理与组织能力:DPM口径建模:让智能体AI问数从“随机抽口径”变成“精确查字典”.
刘凯出席金融风险经理论坛:重新定义什么是“数据”,从被动记录到主动构建,从数据准确性到定义一致性,重塑AI智能体的治理底座
一、三个数字,把会议室问安静了
会议室不大,投影仪调得很清楚。
销售数据分析师、财务BP、IT建模三拨人坐了一排。议题本来很具体:把销售仪表板里那堆硬编码的指标卡,改成按钮参数驱动,同时让新上线的AI问数助手"问得准"。
销售数据分析师先开口,一句话把天聊死了。
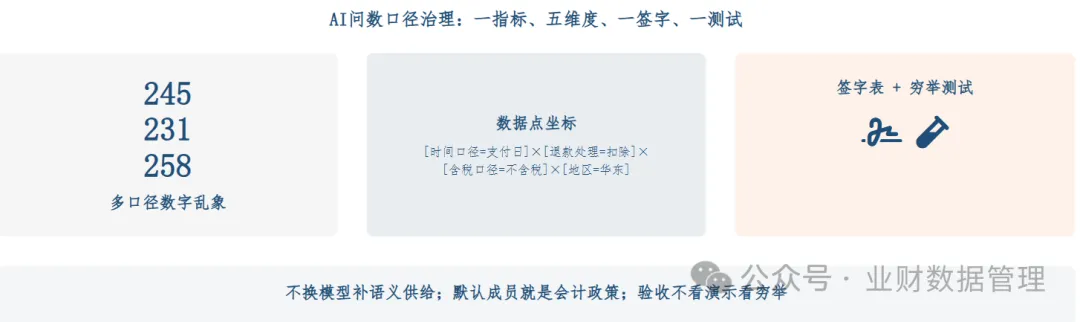
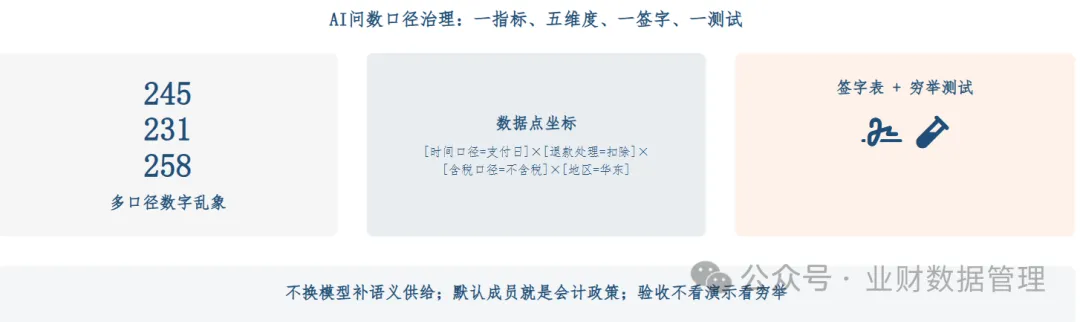
"大家在对话框里打'上个月华东区销售额',AI给我们返回了三个不同的数。销售部问出来245万,财务部231万,运营部258万。三个人把截图发到群里,问我'到底哪个是对的'。"
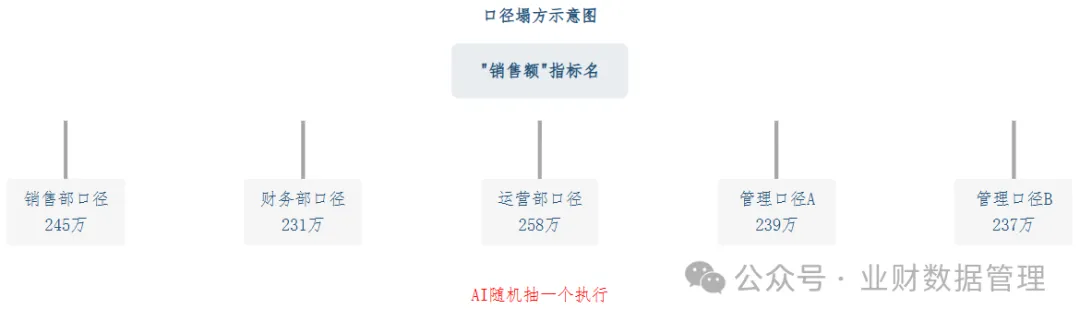
他停了一下,补了一句:"AI没算错。它只是把三个部门各自写在报表里的口径,随机抽了一个执行。"
财务BP接了一句:"我的口径很具体:选了'服装'作为分类项,要看子类别里前N项的求和占全集的百分比。但AI连'总利润'的求和和平均都分不清。"
没人接话。
我补了一句过渡:"按钮驱动只是前台动作。按钮点下去,后台取的是哪套口径,才是真正卡住AI问数的地方。"
我在白板上画了一张表。
图1:同一句"上个月华东区销售额",系统里至少五种写法
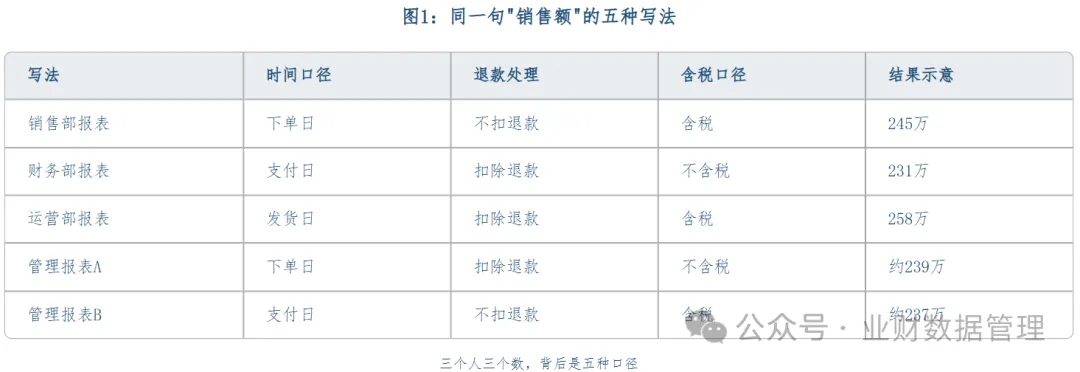
"三个人三个数,背后是五种写法。"我说,"不是三个人说了五种话,而是同一个指标名在系统里至少躺着五套口径,AI随机抽了一套执行。"
对于许多CFO来说,这一幕并不陌生:
AI问数不是算错了,它是在没人给它一张"口径的多维空间坐标系"的情况下,替公司做了一个没人签字的决定。
二、不是AI的大模型不聪明,而是语义上下文供给不足
"先别争AI该按谁的口径来。"
AI+数据治理与流程再造:数据中台从管道思维转向意义思维,数据治理的第一性原理不是“统一”,而是....
我把白板笔递过去,"今天不讲换哪个更大的模型,讲一件更基础的事。"
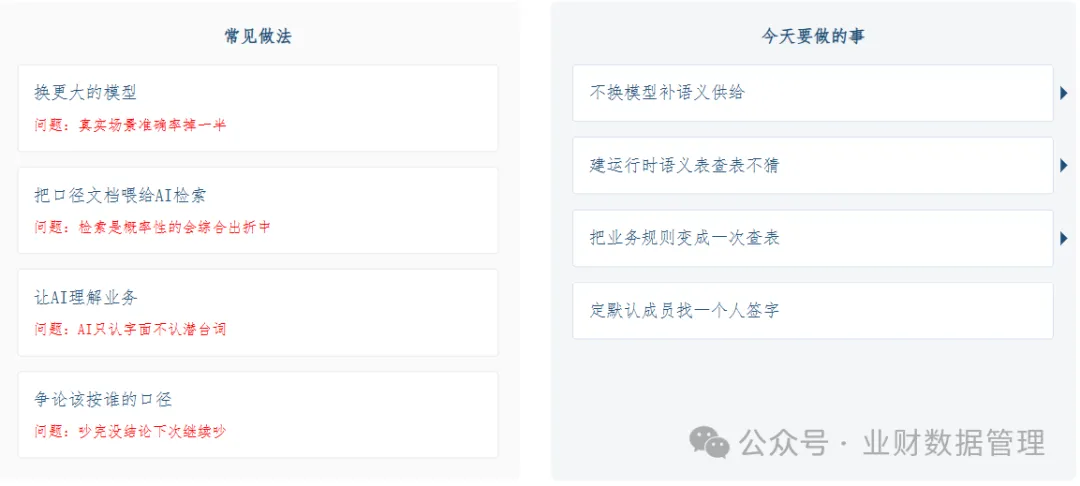
我列了一张对比表。
图2:常见做法 vs 今天要做的事
AI猜错的取数指令,往往能正常执行,返回一个看起来合理的数字。
财务总监拿它去汇报,老板拿它做决策,三个月后审计发现对不上,追责链条从AI查到IT就惨了,最后发现"销售额"在数据字典里根本没定义。
报错?报错反而安全,静默错误才危险。
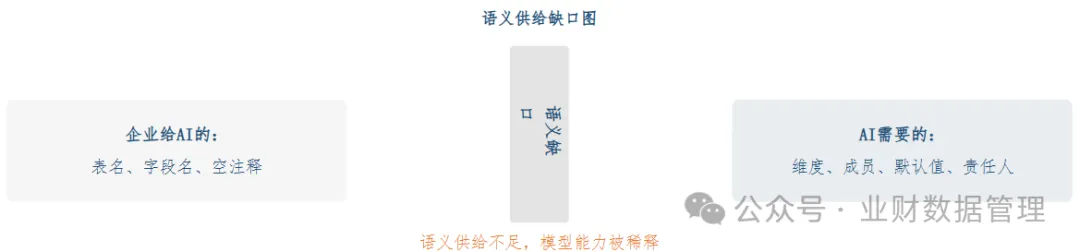
企业AI问数查询的真实情况统计是,在未施加语义约束时业务正确率54%,施加指标定义与使用边界约束后升至68%。这两组数字不是同一把尺子,不能直接相减,但共同说明一件事:语义供给不足时,AI智能体背后的模型能力会被环境稀释。 那46%的错误里,绝大部分不是模型"算错了",而是"算了一个不该算的东西"。
AI智能体,不是财务部的"新会计",它是一个只认字面、不认潜台词的"新分析员"。你不给它一张签了字的语义表,它就把三个部门的口径随机抽一个执行,而且错得静悄悄。
三、数据点建模:把"口径"变成多维空间里的一个坐标
业财数据建模新纪元:ISO 5116-1 数据点建模方法论(DPM), 实时驱动数据闭环
我在白板上写了最核心的一句话:
一个数据点,是"定量方面"与"定性方面"的组合。定量是那个值;定性是一组维度—成员对,精确描述这个值"是什么、按什么拆、在什么口径下"。
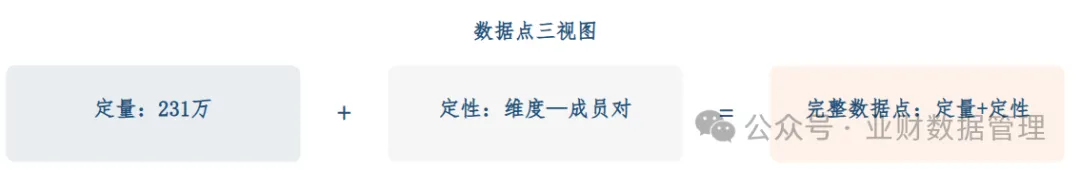
"你可以把它想成一张完整的报销单。"我说,"报销单上的金额是定量,但光有金额不够,还要有费用类型、发生日期、报销部门、是否含税、是否跨期。没有这些标签,金额就是一笔说不清的账。"
AI时代的语义治理和数据治理,不做,你的AI智能体就是银样镴枪头,不行哇
图3:数据点 = 多维空间里的一个坐标
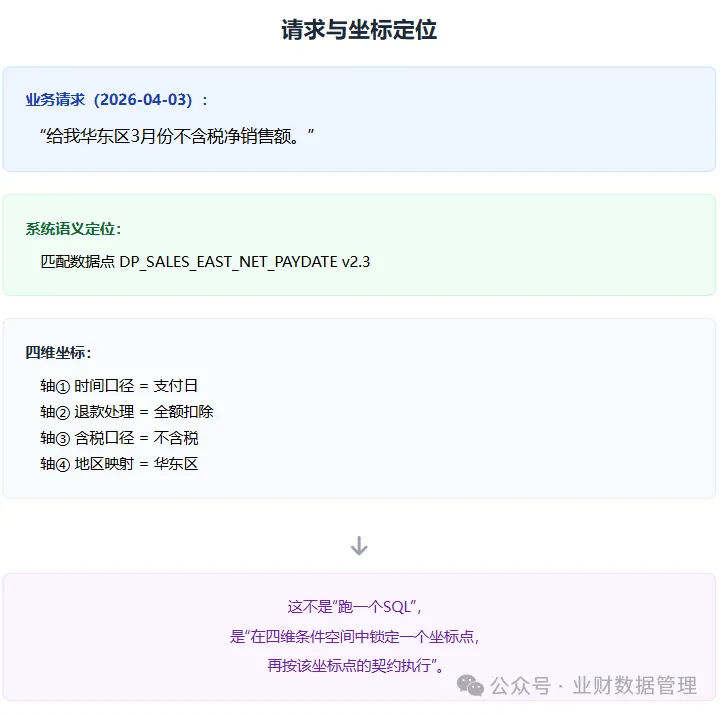
用户要是问"上个月华东区销售额是多少",AI要回答的不是"查哪张表",而是"取坐标系当中(不同坐标轴上刻度)的值"。坐标不确定,数就不确定。
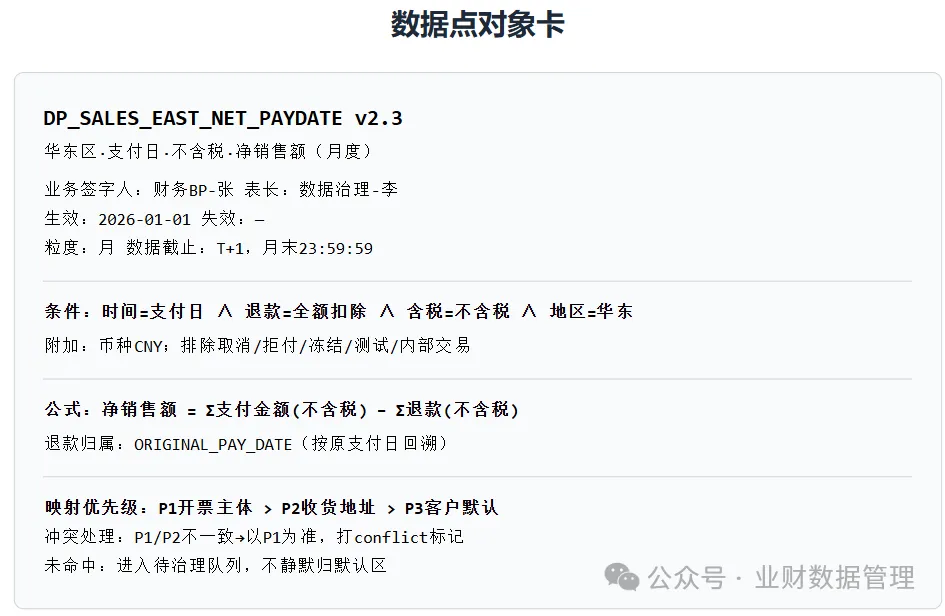
数据点建模有一条硬规矩:
一个数据点只由严格必要的维度来识别;未使用的维度取默认成员。
用户没有指定"退款处理"时,取默认成员;用户指定了"不扣退款"时,系统切换到对应成员。这不是"教AI理解业务",这是把业务规则从自然语言文档里抽出来,变成AI可以执行的一次查表操作。
四、战胜99%AI智能体大模型幻觉的四大原理
原理可以用四句话讲清楚:查表不猜,默认兜底、显式覆盖,找不到就拒答。
第一,查表不猜。
AI不需要"理解"什么是支付日;它查表发现用户没说时间口径,就取"是否默认=是"那一行,拿到date_field = 'pay_date'拼进取数指令。语义理解是概率性的,条件查表是确定性的。
第二,默认兜底。 用户问"销售额"时不会每次说全维度。用户沉默时,系统替他做的决定就是默认成员。时间口径默认"支付日"还是"下单日"?退款处理默认"扣除"还是"不扣除"?这个决定不能藏在IT代码里,不能藏在某个分析师习惯里。它必须像会计政策一样,有定义、有签字人、有生效日期。
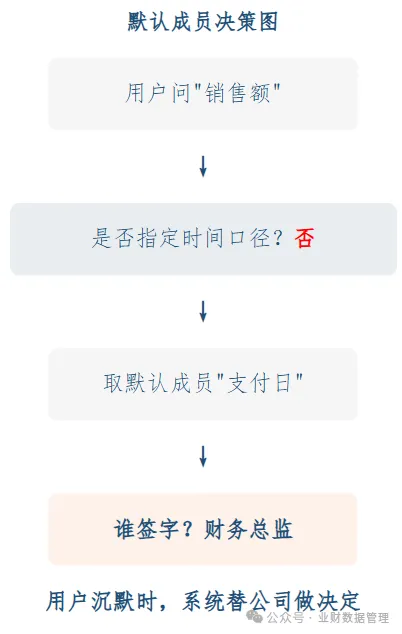
第三,显式覆盖。 用户说"按下单日算的销售额",AI识别出"下单日"这个成员,覆盖默认的"支付日"。默认成员负责兜底,显式覆盖负责精确。
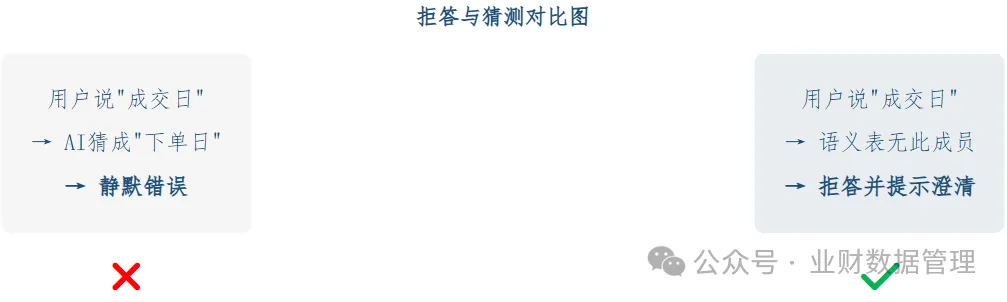
第四,找不到就拒答。 用户说"按成交日",语义表里没有这个成员,系统返回空白或提示澄清,绝不用"相近词"去猜。找不到明确成员,不许用默认值去覆盖一个本应显式指定的维度。
五、五大好处:AI不猜、AI错可追、默认有签字、变更可回溯、验收可重复
对CFO来说,数据点建模的好处不是技术上的,是治理上的。
AI不猜。 每次取数都落到语义表里一行,找不到就拒答,而不是随机抽一个口径。
错可追。 追责对象从"AI大模型"转移到"数据点模型(DPM)字典维护者":这个默认值是谁签的字,出了偏差就追谁。
默认有签字。 默认成员就是"用户沉默时,公司替他做的决定",必须有人签字,和会计政策一样。
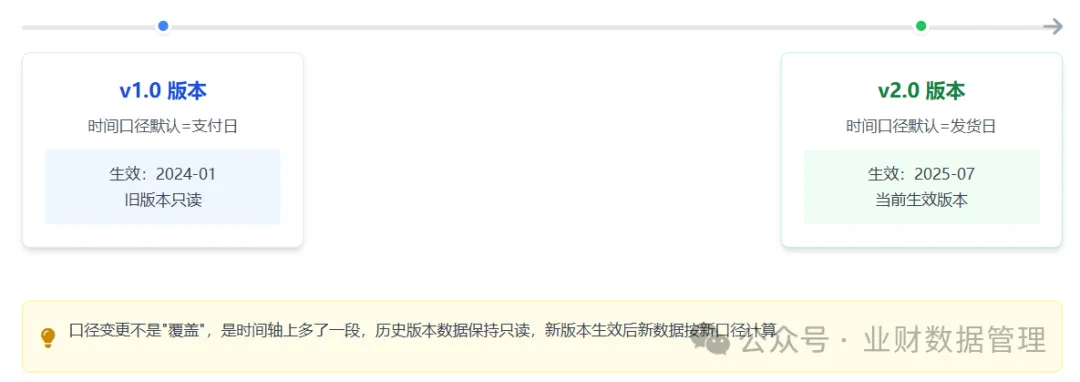
变更可回溯。 口径变更不是覆盖,是时间轴上多了一段;旧版本只读保留,AI问数日志带版本号。
验收可重复。 不看演示看穷举测试:同一业务意图的不同问法,是否收敛到同一个数据点。
一句话讲深刻: 没有签字的默认值,就是没有约束的默认值。
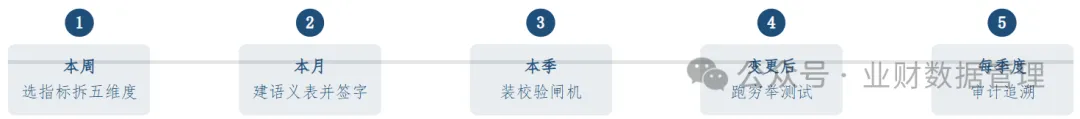
六、整体五步:拆、建、闸、签、验
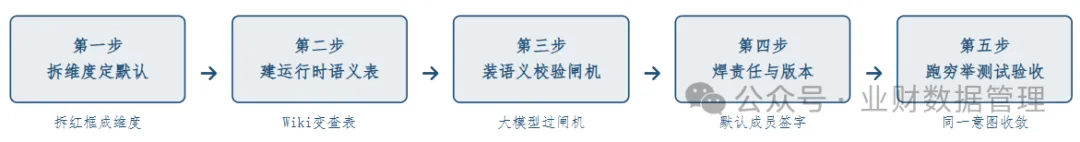
工作坊不是讲概念,是当场把一张表签出来。整体五步,好记:拆维度、建语义表、装校验闸机、焊责任版本、跑穷举验收。
图:五步走——每步有负责人、有产出
第一步:拆维度定默认候选——把仪表板红框翻译成AI能读的维度
我让数据分析师、财务BP把仪表板截图上所有红框标注,逐个写成"维度.成员"格式。不商量,先暴露。
销售分析皱眉:"这些红框在我眼里是'功能',怎么变成'维度'了?"
"因为功能是给人用的,维度是给AI查的。"我说,"你点一个按钮,AI不需要知道'你点了按钮',它需要知道'当前数据点在"合计口径"这个维度上,取的是哪个成员'。"
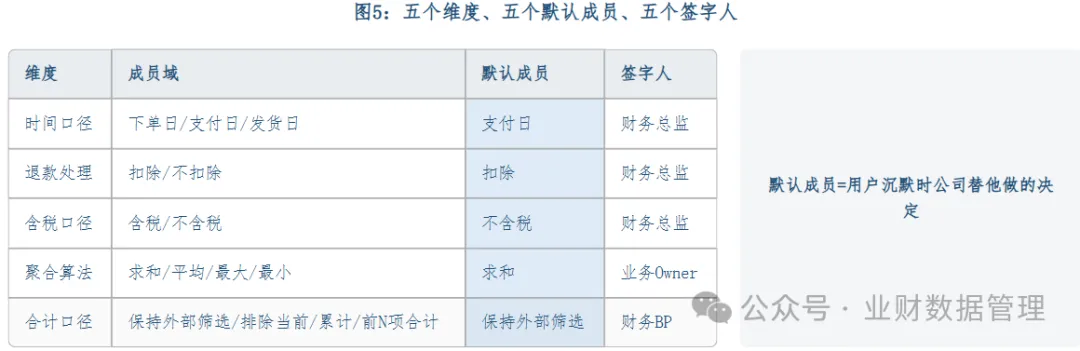
图5:五个维度与默认成员候选(签字人第四步确认)
三条硬规矩:
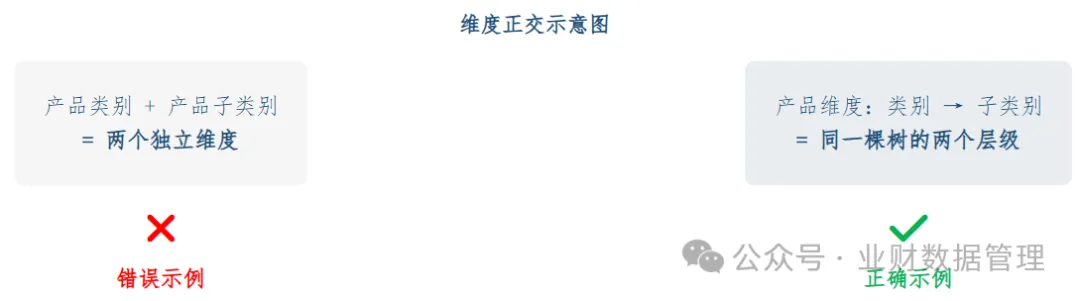
维度必须正交(产品类别和子类别不是两个独立维度);
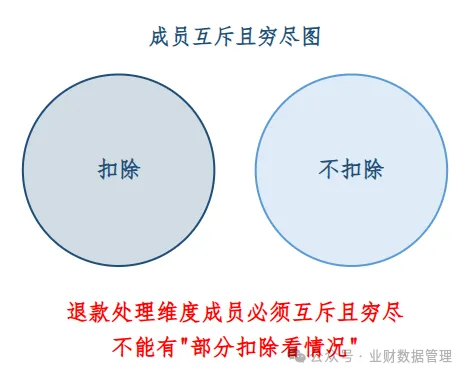
成员域必须互斥且穷尽(退款处理只能是{扣除,不扣除},不能"部分扣除看情况");
默认成员候选先暴露出来,第四步由业务Owner签字确认。
第二步:建运行时语义表——不是Wiki知识库,是AI每次取数前必须查的表
很多企业把口径写在Wiki、Excel附件、会议纪要里,指望通过知识库让AI"读懂了再回答"。这行不通:检索是概率性的,口径校验必须是确定性的;文档是给人读的,不是给机器查的。
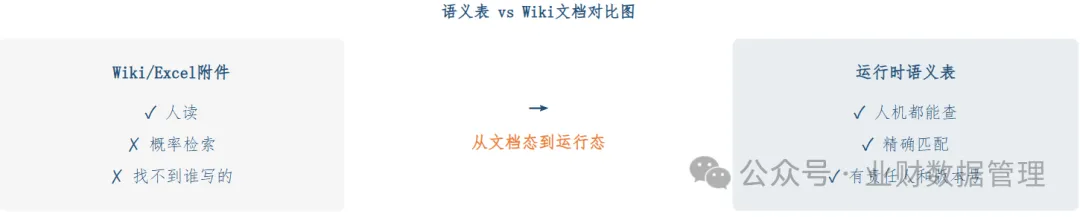
图:语义表的关键,是"人读一列,机器读一列"(此处仅用表格示例)
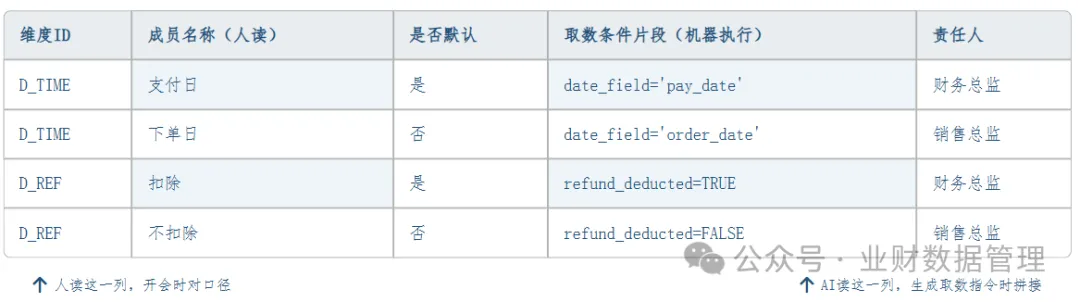
图注:D_TIME是"时间口径"的机器ID,D_REF是"退款处理"的机器ID。CFO只看"是否默认"和"责任人"两列;取数条件片段由IT确认。 完整语义表含图5五维,含税、聚合、合计同理各一行默认成员。
财务BP问:"销售部的人问'按下单日看的销售额',AI怎么处理?"
"AI识别到'下单日',去表里查成员名称='下单日'那一行,拿到date_field = 'order_date',覆盖默认的支付日条件。用户说清楚了,系统按用户说的来;用户没说,系统按默认来。默认是谁签的字,出了偏差就追谁。"
IT建模问:"如果用户说'按成交日',表里没有呢?"
"拒答,而不是猜。责任人存在的意义,就是在AI说'我不知道这个成员'时,有人能决定是加一行新成员,还是告诉用户'请用标准口径'。"
第三步:装语义校验闸机——大模型可以生成指令,但必须刷卡过闸
很多团队的链路是:用户问句→大模型→直接生成取数指令→执行→返回数字。中间没有层去校验:大模型生成的指令里,用的到底是哪个维度的哪个成员。
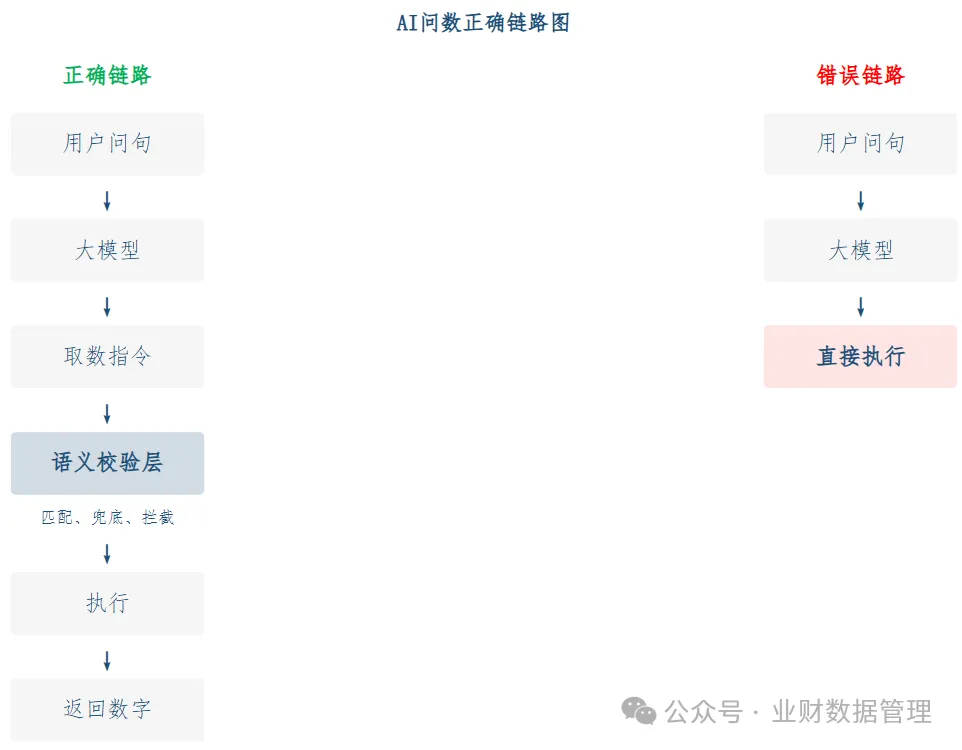
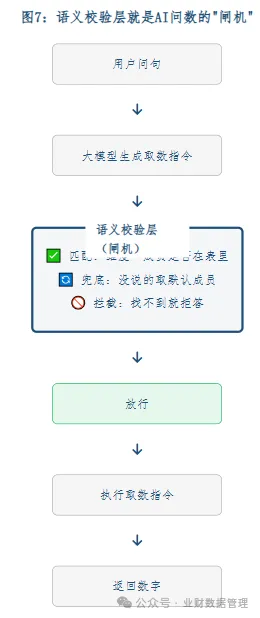
正确架构是在大模型生成取数指令之后、执行之前,插入语义校验层。你可以把它想成地铁闸机:大模型可以生成指令,但指令必须刷卡过闸;卡里没有明确的口径成员,闸机不放行。
图:语义校验层就是AI问数的"闸机"
用户问"前6项子类别中,利润占全集的百分比是多少"。
通过DPM方法论,多常见的分析方法(18种分析方法能解决分析师95%的问题)进行逆向建模抽象,实现预制好算子参数,为AI问数供应语义。
大模型解析出聚合算法=求和、字段=利润、合计口径=前N项合计、迭代算法=逐项求和、N=6。
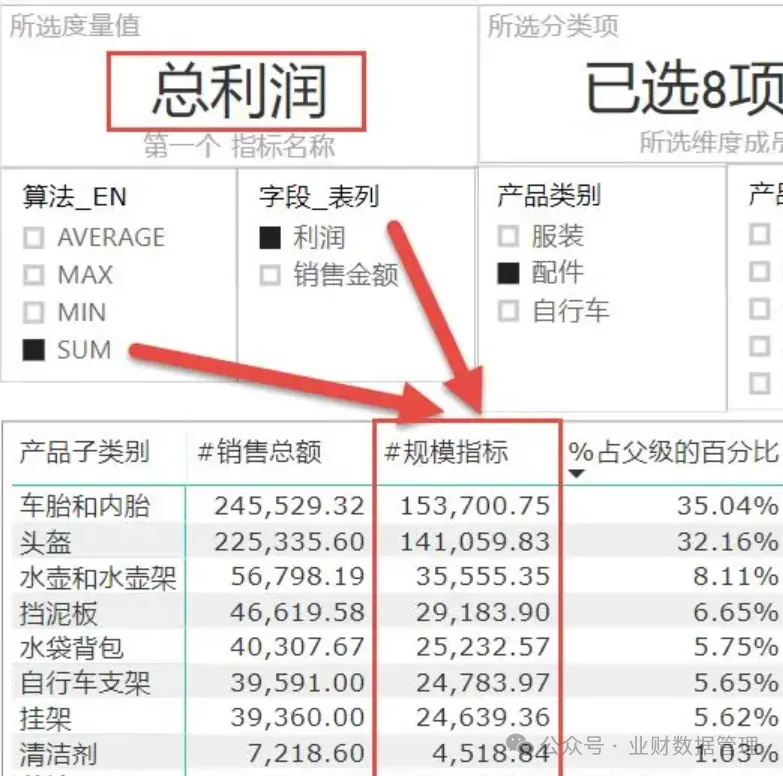
校验层逐项查表:匹配则注入;排序方向没解析出,查表默认降序;
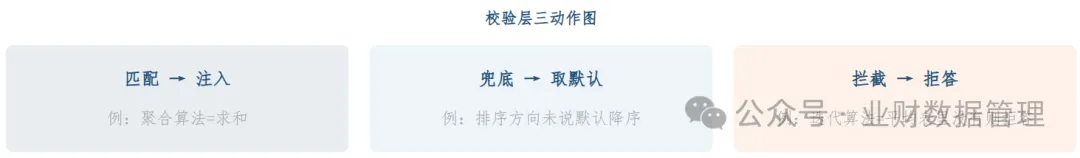
产品层级只说了"子类别"没说父级,查表默认取"全部类别"作为筛选范围。
全部匹配,放行。
如果大模型解析出"迭代算法=平均",而表里只有"逐项求和"和"逐项平均",校验层拒答,提示用户澄清。这不是AI在"理解",这是语义表在"拦截"。
第四步:责任与版本——默认成员就是AI时代的会计政策
现在,把第一步的默认成员候选,变成签字确认。
图8:五个维度,五个默认成员,五个签字人
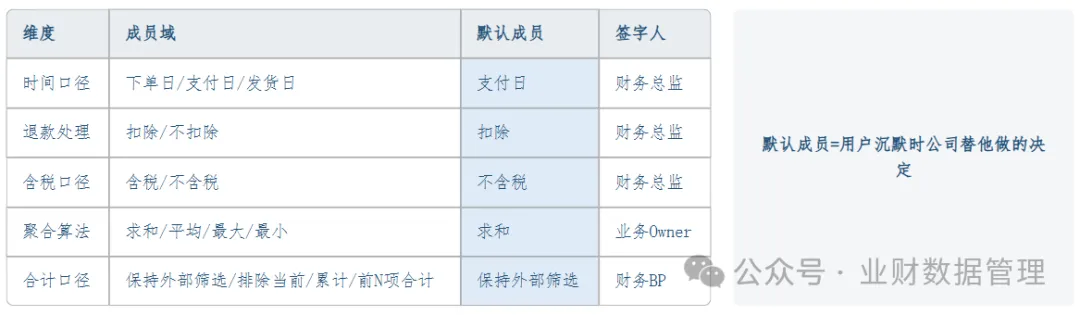
财务总监看到"时间口径的默认成员是支付日,责任人是财务总监",停了几秒,说了一句让全场安静的话:
"我签这个字,意味着以后AI问数里所有没指定时间口径的销售额,都是按支付日算的。销售部如果拿这个数去考核,发现跟他们的下单日口径对不上,来找我,我不能说'这是AI算的',我得说'这是我定的'。"
"对。"我说,"AI问数不是把责任从人转移给机器,是把责任从'没人负责的模糊地带'转移到'签了字的默认成员'上。这张责任表,就是AI问数的口径宪法。"
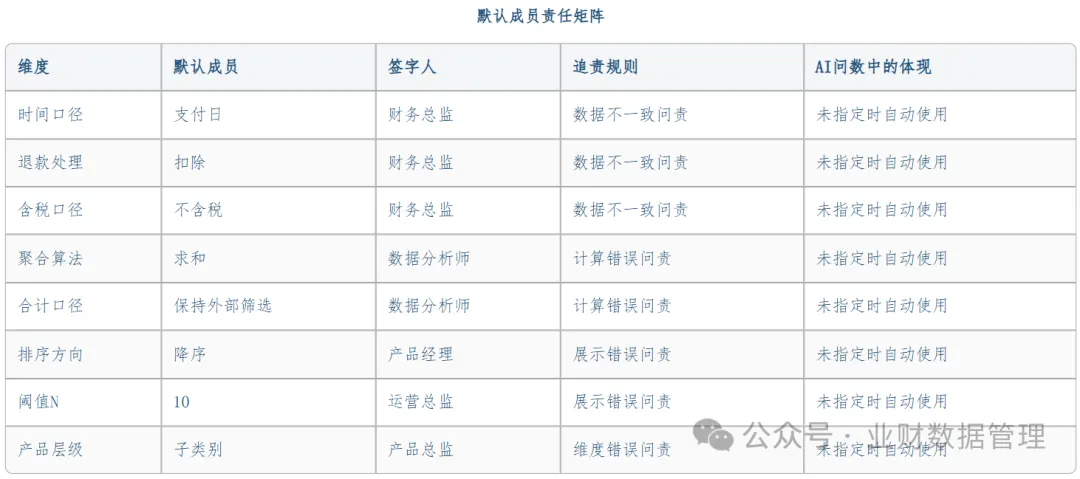
图:口径变更不是"覆盖",是时间轴上多了一段
三条规矩:
改默认成员必须双签(业务提出、财务审批、IT执行);
旧版本必须只读保留;
AI问数日志必须带语义表版本号。
此外,AI问数界面必须提供"按旧口径"开关或问句识别入口,否则"旧版本只读"只是库里有、用户调不到。
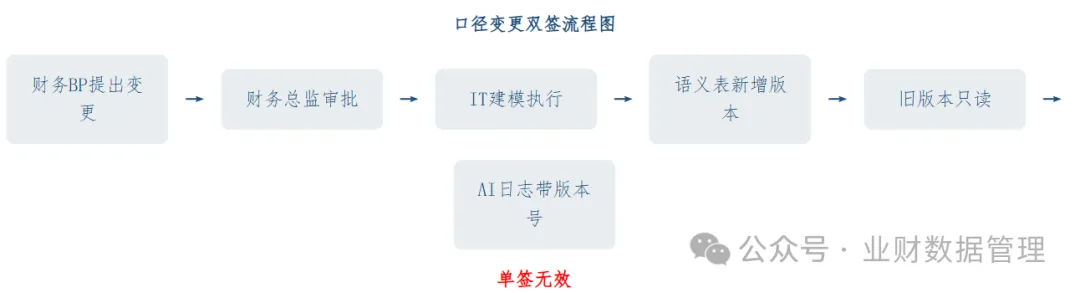
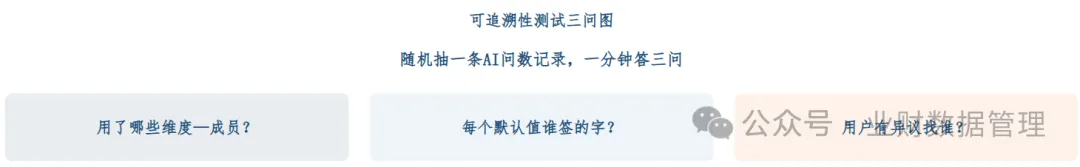
可追溯性测试(责任与版本验收): 随机抽一条AI问数历史记录,三个问题一分钟内答上来——这条记录用了哪些维度—成员?每个默认值是谁签的字?用户有异议找谁?
第五步:跑穷举测试验收——不要用"感觉对了"验收AI问数
散会前,财务总监问:"我怎么判断AI问数是真的'懂'了,还是碰巧答对了?"
"验收分两类:A收敛测试,验口径;B可追溯测试,验责任版本。B刚才已经过了,现在咱们做A收敛测试。"
图:穷举测试——五种问法,一个数据点
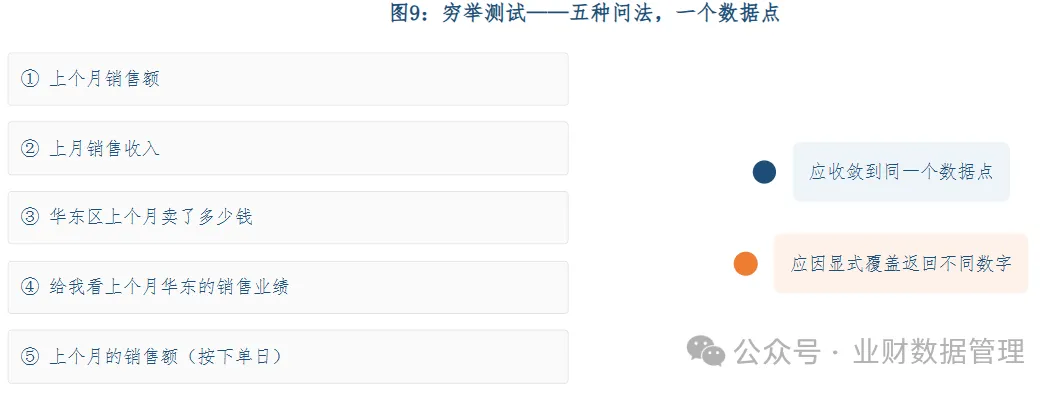
注意:⑤不是同数据点,是显式覆盖测试;若默认本就是下单日,需换一个非默认成员做覆盖测试。前四个返回不同数字,说明语义表有维度没覆盖到,或默认成员解析有漏洞。变更后自动跑测试集,挂了就回滚。
七、收尾:从责怪AI模型,到检查DPM数据点字典
我最后做了三分钟复盘,只说了三句话。
不换模型补语义: AI问数要的不是口径文档,是数据点目录和多维空间语义层。
默认成员要签字: 默认成员就是会计政策;没有签字的默认值,就是没有约束的默认值。
验收看穷举: 一指标、五维度、一签字、一测试;不看演示看收敛。
拿一张纸,把你们公司那个被三个部门问出三个数的指标,拆成五个维度,每个维度定一个默认成员,找一个人签字。
你今天把语义表签清楚,明天AI问数才有法可依,口径争议才追得到根。