ARTICLE · 1300538
用户还没说完,AI 已经调用了 5 个工具
语音 / TTS / 多模态补更简报|2026-10-29—11-02
Speech-to-Speech · Voice Agent Infrastructure · Cloud TTS · Zero-shot TTS · Turn-taking
本期 5 项更新:Phonic-1 在用户说话期间并行调用工具;Deepgram 宣布收购 Daily / Pipecat,并提出 Real-Time Context Standard;Google 将 Gemini 3.8 Flash TTS 与 Flash-Lite TTS 推进至 GA;一篇 Zero-shot TTS 论文证明参考音频选择可显著影响 WER;SpeakerTurn 则把目标说话人识别、转写和话轮判断放进同一模型。
标题中的“5 个工具”来自 Phonic 官方发布页的一次受控对比演示,不是所有任务的平均表现。Google 两个 TTS 主模型已经 GA,但 Voice Design 与 Voice Replication 仍处于 Preview;SpeakerTurn 的主要结果来自合成多人语音,尚未证明能在真实会议和连续通话中保持同等表现。
速览
01|Phonic-1:用户仍在说话,后台工具已经运行
发布日期:2026-10-29类型:Speech-to-Speech / Voice Agent / Tool Calling
Phonic 发布原生 Speech-to-Speech 模型 Phonic-1,并宣布完成 2,750 万美元 A 轮融资。模型在 50 多种语言上训练,支持对话中途切换语言,同时保持输出声音身份一致。
它最有辨识度的能力不是更快合成第一段语音,而是把后台任务与用户发言放到同一时间轴上。传统 Voice Agent 往往需要等待 End-of-turn,再根据完整转写调用工具;Phonic-1 会根据已经到达的语音先行发起查询,让网络和工具耗时与剩余发言重叠。
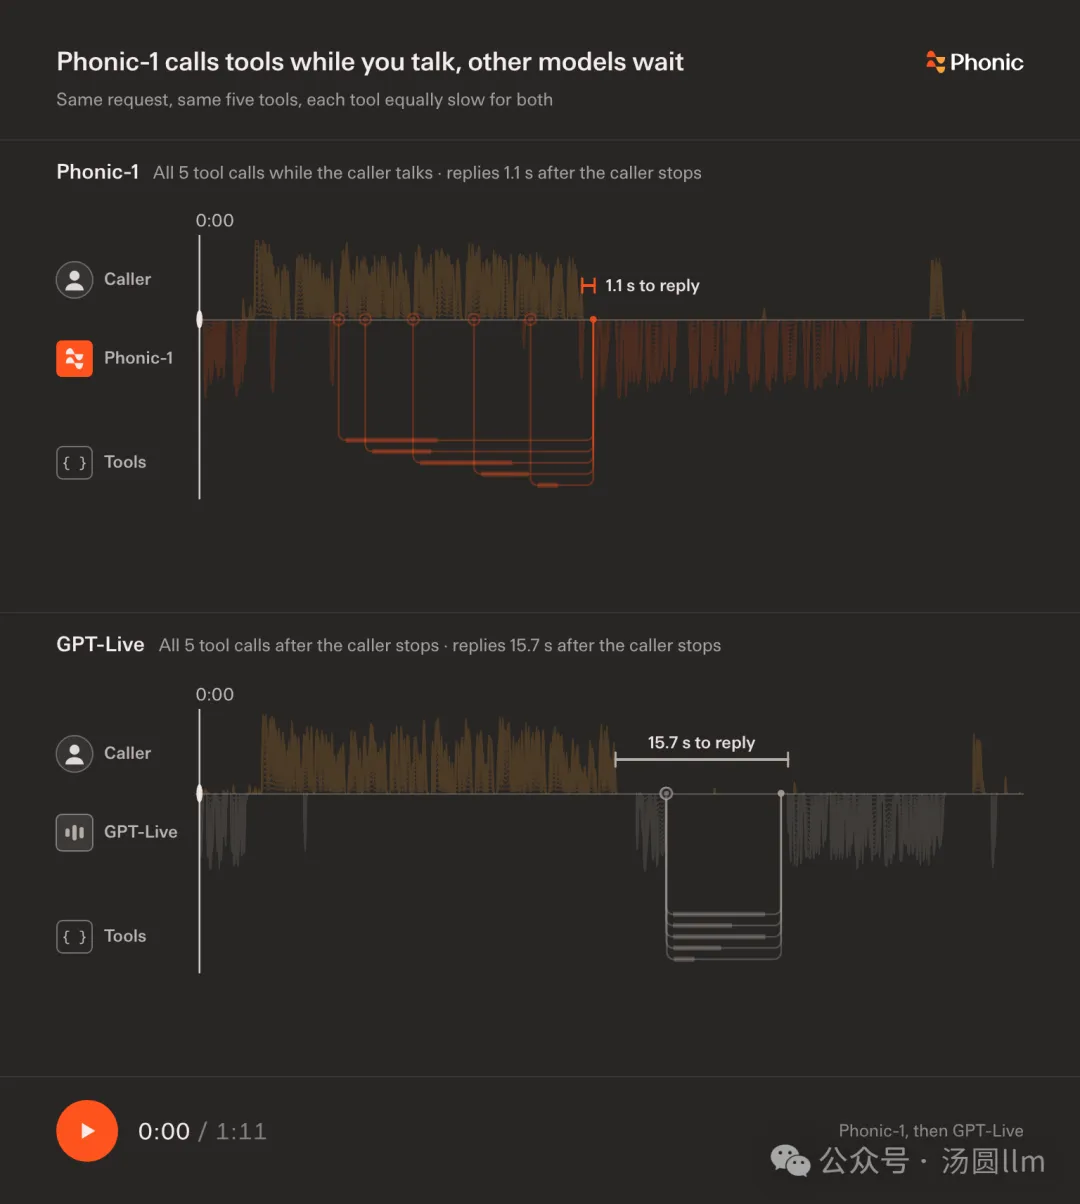
图 1:Phonic 官方对比演示。相同请求和五个等速工具下,Phonic-1 在用户发言期间发起全部调用,用户停止后 1.1 秒回复;对照系统在用户停止后调用工具,15.7 秒后回复。
这张图应当按演示案例理解,而不是平均延迟结论。提前执行也引入明确的系统风险:用户可能在后半句修改目的地、日期或金额,前面触发的任务随即过期。生产系统因此仍需要区分:
可以提前执行的只读查询; 需要 End-of-turn 确认的写操作; 用户改口后应取消或废弃的旧任务; 已完成但不应再播报的过期结果。
截至本期截稿时,Artificial Analysis 页面给出的第三方结果为:
| 87.1 | |
| 92.3% | |
| 0.61s |
这些指标来自各自固定协议,不能替代真实电话中的工具正确性、取消行为、语言切换和长通话稳定性测试。Phonic 另外展示了一通 44 分钟、包含 123 次工具调用的酒店预订对话,但仍属于厂商演示。
技术意义: Voice Agent 的任务延迟不再只是
ASR → LLM → TTS各阶段延迟之和。让监听、意图更新、工具执行和回复规划并行,可以直接隐藏外部 API 的等待时间;真正困难的部分则变成任务版本管理、撤销策略和执行权限。
原始资料:Phonic-1 官方发布[1] · Artificial Analysis Speech-to-Speech[2]
02|Deepgram 收购 Daily:语音模型、实时网络和 Pipecat 合到同一平台
发布日期:2026-10-29类型:Industry / Voice Agent Infrastructure / Open Source
Deepgram 宣布收购 Daily。Daily 不仅提供覆盖 75 个 PoP 的实时音视频网络,也是开源 Voice Agent 框架 Pipecat 的开发方。
并购后的组合覆盖三层基础设施:
Deepgram:STT、TTS、Speech-to-Speech 与音频理解模型; Daily:WebRTC、媒体传输和全球实时网络; Pipecat:跨模型、电话系统和传输层的 Agent 编排。
图 2:Deepgram 官方并购公告主视觉。Pipecat 将继续采用 BSD V2 许可证,并计划通过独立基金会维持开源与厂商中立。
Deepgram 同时发布 Real-Time Context Standard(RCS)。它针对级联 Voice Agent 的一个结构性损失:STT 往往只把文字交给 LLM,用户的耳语、讽刺、情绪、说话人身份和背景环境在链路中消失;LLM 生成的文本也很少说明 TTS 应该如何表达。
RCS 定义三类可随对话传递的元数据:
Audio Context:例如耳语、听不清的词、情绪或环境信息; Interpretation Guidance:告诉 LLM 应如何使用这些信号; Delivery Guidance:告诉输出模型回复应以何种方式表达。
协议使用适配器将这些信号映射到不同模型接口,目标是避免把系统绑定到单一 ASR、LLM 或 TTS 供应商。Pipecat 已提供 Alpha 演示实现,展示情绪与讽刺读取、表达标签、停顿、呼吸和后向反馈。
需要区分并购愿景与现有产品状态。官方公告将整合后的 Deepgram Voice Agent Platform 描述为 forthcoming;RCS 也处于开放规范和早期实现阶段。它能否成为跨厂商通用层,取决于模型供应商是否愿意输出、读取并稳定解释同一套语音上下文。
技术意义: Deepgram 的竞争边界从语音模型 API 扩展到媒体网络和 Agent Runtime。RCS 更值得观察的地方,是它试图让级联架构保留原生 Speech-to-Speech 模型天然拥有的副语言信息,同时继续保留模块可替换性。
原始资料:Deepgram 并购与 RCS 公告[3] · RCS Alpha 演示仓库[4]
03|Gemini 3.8 TTS:Flash 负责表演,Flash-Lite 负责吞吐
发布日期:2026-10-28类型:TTS / Voice Design / Cloud API
Google 将 Gemini 3.8 Flash TTS 与 Gemini 3.8 Flash-Lite TTS 推进至 GA。两者使用相同请求 Schema 和 Prompt 格式,开发者可以通过替换 Model ID 切换模型,但产品定位并不相同。
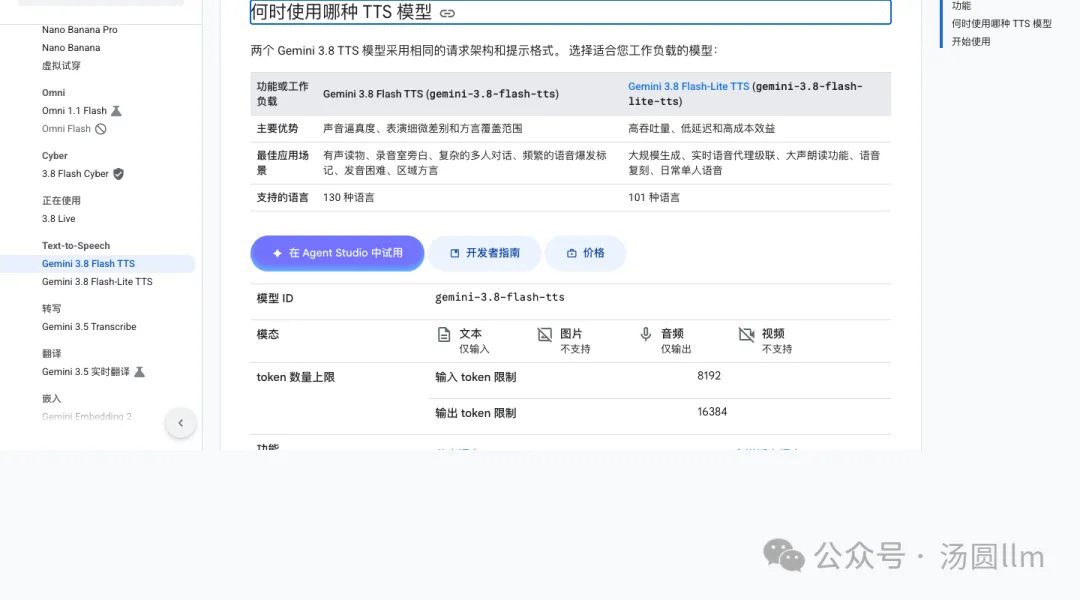
图 3:Google Cloud 官方文档。Flash 强调声音还原度、表演细节和方言覆盖;Flash-Lite 强调高吞吐、低延迟和成本效率。
Flash 对逐轮 style 指令和 <laugh>、<sigh>、<short pause> 等行内事件提供更明确的表演支持,并强调长对话中音色、音量与 Room Tone 的稳定性。Flash-Lite 则面向更高并发和成本敏感任务。
“主模型 GA”不等于全部能力同步 GA。Google 的发布说明明确保留 Voice Design 与 Voice Replication 的 Preview 标记;生产系统仍需分别评估配额、区域、声音授权和版本稳定性。两个型号也都不是 Gemini Live:它们是文本输入、音频输出的 TTS 服务,不提供原生双向实时对话。
技术意义: Google 将 TTS 拆成质量优先和效率优先两个工作点,并保持相同接口。系统可以让主角台词、复杂配音使用 Flash,把通知、朗读和高并发 Agent 回复交给 Flash-Lite,而无需维护两套调用协议。
原始资料:Google Cloud 发布记录[5] · Gemini 3.8 Flash TTS[6] · Gemini 3.8 Flash-Lite TTS[7]
04|Zero-shot TTS:参考音频选对了,WER 可降低约三到四成
论文提交:2026-10-29类型:Zero-shot TTS / Voice Cloning / Prompt Selection
论文 What Makes a Good Audio Prompt for Zero-Shot TTS? 研究一个常被当成数据预处理的问题:同一个人的长录音里,究竟应该截取哪一段作为 Voice Prompt?
作者从 YouTube 录音中构造候选参考片段,使用 Qwen3-TTS 0.6B、Qwen3-TTS 1.7B、Chatterbox 和 F5-TTS 生成数十万条语音。结果显示,同一说话人的不同 Prompt 会同时改变可懂度、自然度和 Speaker Similarity;UTMOS、DNSMOS 等普通音质预测器主要能筛选自然度,却无法可靠找出最有利于内容准确率的片段。
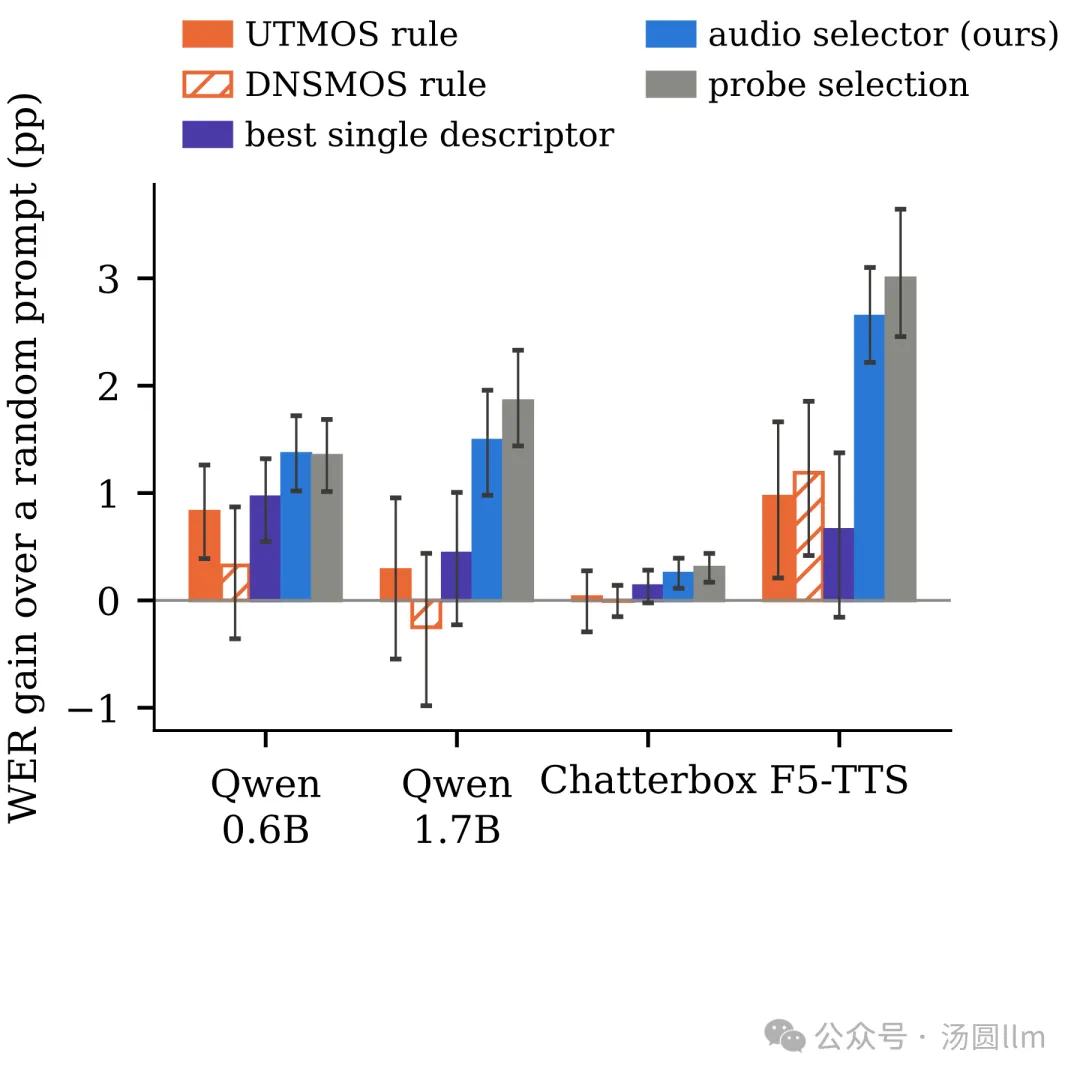
图 4:原论文 Figure 1。纵轴是相对随机 Prompt 的 WER 绝对改善,越高越好。蓝色 Audio Selector 无需在选择阶段执行 TTS,效果接近为每个候选实际合成 12 句话的 Probe Selection。
作者训练了一个小型 Audio Selector:冻结 Whisper-base Encoder 提取候选参考音频特征,再用两层 Transformer 和 Scoring Head 预测候选排序。它的监督信号不是参考音频本身的音质标签,而是该 Prompt 实际驱动 TTS 后得到的 WER、自然度和音色结果。
在 400 个未见录音上:
Qwen3-TTS 0.6B 的 WER 相对随机 Prompt 降低 32%,绝对改善 1.36 个百分点; F5-TTS 的 WER 相对随机 Prompt 降低约 40%,绝对改善 2.64 个百分点; Selector 的效果接近 Probe Selection,但后者每个候选需要合成 12 句话,每条录音合计最多 228 次合成。
这并不意味着一个 Ranker 可以无条件适配所有 TTS。论文发现,各模型对“哪段 Prompt 最能保留音色”的判断较一致,但对“哪段最容易生成正确文字”的判断差异更大;F5-TTS 和 Qwen 的最佳选择规则并不完全相同。
自然度结论也需克制。72 个录音、7 位听众的配对实验没有发现 Selector 相比 UTMOS 规则存在自然度损失,但样本量不足以可靠验证清晰度优势;除这项听测外,大部分结果仍来自自动指标。
技术意义: Voice Cloning 的质量并不只取决于模型、录音时长和信噪比。把“选择哪一段参考音频”建模为可学习的排序任务,可以在不修改 TTS 权重的情况下提高准确率;实际产品还应针对自身模型、语言和录音域训练 Ranker,而不是使用通用音质分数代替。
原始资料:arXiv 摘要[8] · HTML 全文[9]
05|SpeakerTurn:多人环境里,先确认是不是目标用户
论文提交:2026-10-29类型:Turn-taking / Target-speaker ASR / Voice Agent
普通 VAD 只能判断“有没有人说话”,语义完整度模型只能判断“这句话像不像说完了”。在电视声、旁人交谈和多人会议中,Voice Agent 还需要确认当前声音是否属于指定用户。
SpeakerTurn 基于 Xiaomi CocktailASR-1,输入多人混合音频、1–4 秒目标说话人参考语音和任务上下文,联合生成目标用户转写与五类状态:
Complete; Incomplete; Backchannel; Wait; Target Absent。
模型另设打断测试,判断 Agent 说话期间出现的声音是否来自目标用户,以及是否应该停止当前回复。
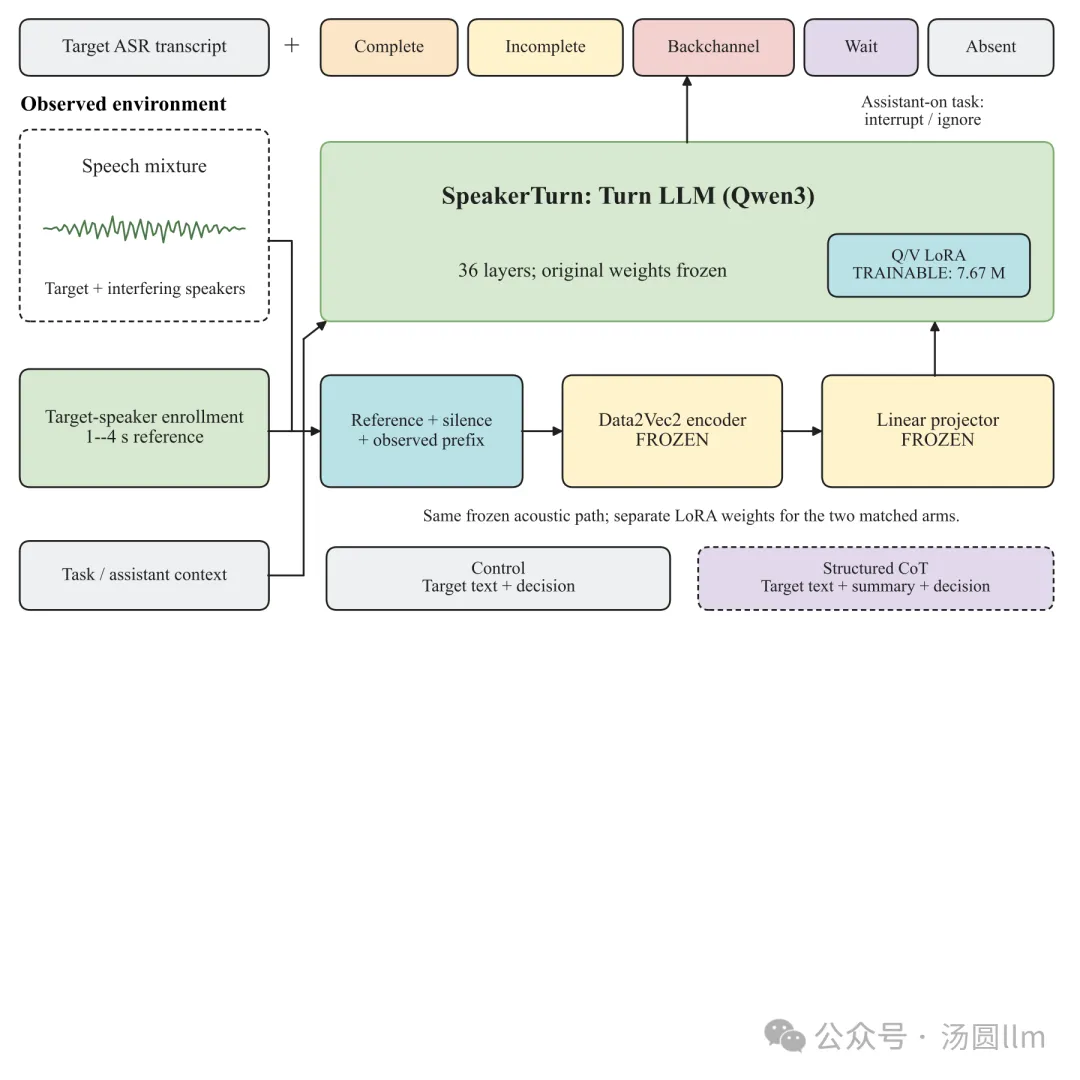
图 5:原论文 Figure 2。冻结的 Data2Vec2 声学路径读取目标声纹参考与混合音频,Qwen3 Turn LLM 通过 7.67M 可训练 LoRA 联合输出目标转写和话轮状态。
原始合成测试集覆盖中文和英文,包含目标用户单独说话、仅干扰者、双人重叠、噪声和三人混音。无结构化 CoT 的 SpeakerTurn 结果为:
| 0.811 | |
| 83.33% | |
| 4.20% | |
结构化 CoT 并没有改善话轮判断。它把目标 CER 从 4.20% 降到 2.56%,却让五状态 Macro-F1 从 0.811 降到 0.764;Backchannel Recall 也从 52% 降到 32%。这说明更好的转写和更好的交互决策不是同一个目标。
当前错误主要集中在过早判定 Complete:60 个 Incomplete 条件中有 25 个被误判,50 个 Backchannel 中有 22 个被误判。论文也明确指出,受控噪声、混响、设备回声、连续 Endpointing 和真实多人录音的泛化尚未建立。
技术意义: 多人环境下的话轮判断应同时建模“谁在说、说了什么、是否交出话轮”。SpeakerTurn 展示了目标声纹条件与语义状态联合训练的可行性,但合成数据上的高分距离真实会议部署仍有明显差距,尤其需要解决简短附和与未完成句的误触发。
原始资料:SpeakerTurn arXiv[10] · HTML 全文[11]
来源索引
Phonic: Introducing Phonic-1 and our $27.5M Series A Deepgram is acquiring Daily, makers of Pipecat Gemini Enterprise Agent Platform Release Notes What Makes a Good Audio Prompt for Zero-Shot TTS? SpeakerTurn: Target-Speaker Semantic Turn Detection in Multi-Speaker Environments
参考资料
模型、演示与融资信息: https://phonic.ai/blog/phonic-1
[2]第三方实时榜单: https://artificialanalysis.ai/speech-to-speech
[3]并购、平台与协议说明: https://deepgram.com/blog/daily-pipecat-deepgram
[4]开放实现与消息格式: https://github.com/pipecat-ai/realtime-context-standard-demo
[5]GA 状态与能力边界: https://docs.cloud.google.com/gemini-enterprise-agent-platform/release-notes
[6]130 种语言与模型能力: https://docs.cloud.google.com/gemini-enterprise-agent-platform/models/gemini/3-8-flash-tts
[7]101 种语言与模型能力: https://docs.cloud.google.com/gemini-enterprise-agent-platform/models/gemini/3-8-flash-lite-tts
[8]论文摘要与 PDF: https://arxiv.org/abs/2610.40372
[9]方法、消融与听测: https://arxiv.org/html/2610.40372v1
[10]摘要与 PDF: https://arxiv.org/abs/2610.39828
[11]数据、架构与完整实验: https://arxiv.org/html/2610.39828v1