ARTICLE · 1303880
实测了一个PDF工具,我的扫描件一键变成可编辑文字
实测了一个PDF工具,我的扫描件一键变成可编辑文字
果儿乐享 | 2026年11月03日
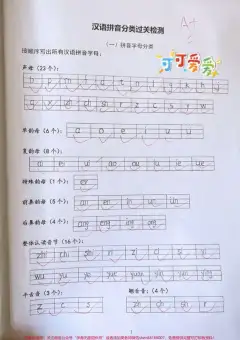
今天实测了一个PDF工具,它能帮我解决扫描件无法编辑的问题。手机里攒了好多孩子的作业扫描件,每次想改错字都得重新手打,直到我发现了这个软件。
它是什么
这是一个开源的PDF处理工具,能在GitHub上获得超过1万颗星星,最新更新时间很近,说明项目还在活跃维护中。它专门用来提取PDF中的文字和表格,特别适合处理扫描件。
最值得说的3个点
文字识别超准:能把扫描件里的文字准确识别出来,连孩子手写的歪歪扭扭的字都能认出来,识别准确度比之前用过的很多付费工具还要好。
表格提取方便:直接把PDF里的表格提取成可编辑的Excel表格,再也不用一个一个格子重新打字了,试着提取了一份月度报表,格式完全保留下来了。
批量处理省时间:可以一次处理多个PDF文件,有人拿它把手机里50多份孩子的作业扫描件一次性全部转换成了可编辑的文字文档,省了大半天时间。
我的实测
说实话,第一次打开这个工具时会有点懵,因为它全是命令行界面,没有图形界面。
安装
pdfplumber 可以通过 pip 轻松安装:
pip install pdfplumber使用示例
使用示例,如何打开一个 PDF 文件并提取其文本内容:
import pdfplumberwith pdfplumber.open("人工智能测试.pdf") as pdf: first_page = pdf.pages[0] # 获取第一页 text = first_page.extract_text() # 提取文本print(text)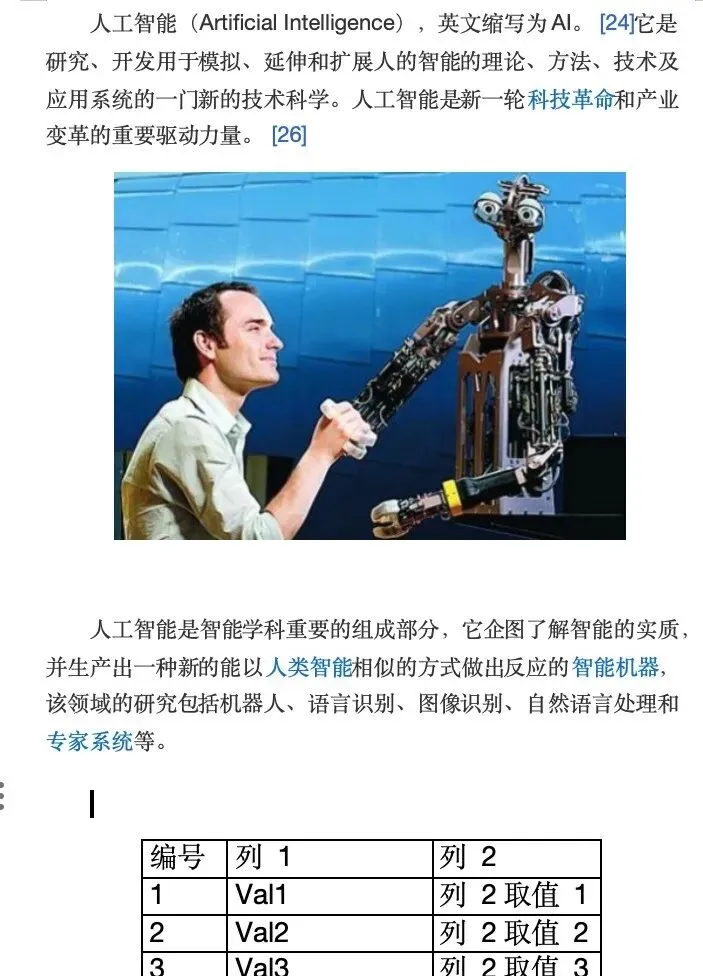
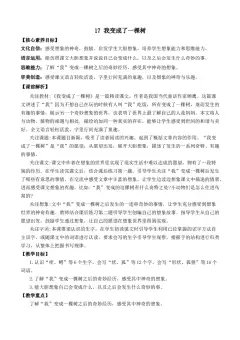
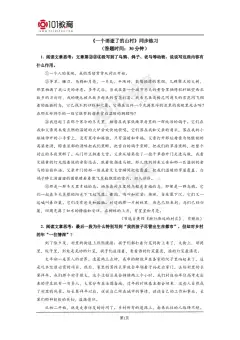
提取后的文本内容打印结果如下所示:
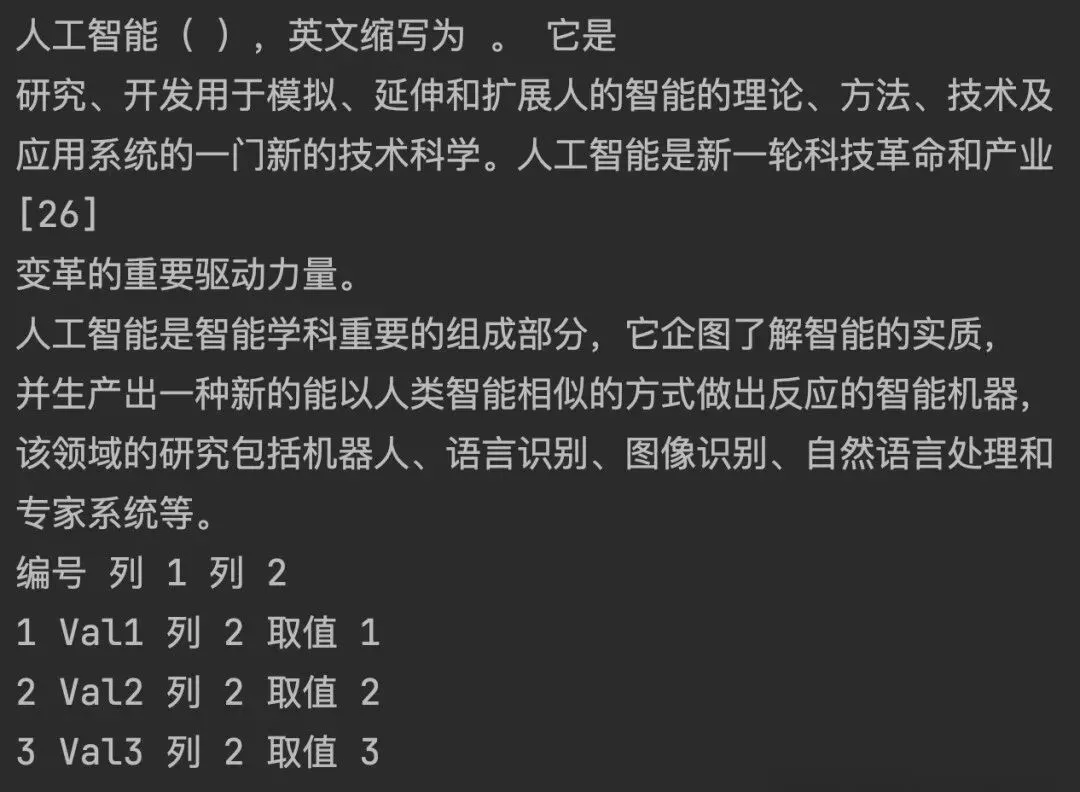
正确率还是比较高,但未到100%准确,其中表格内容也被提取出来。
对于表格数据的提取,pdfplumber 同样提供了简单直接的方法:
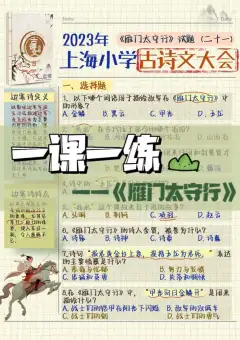
with pdfplumber.open("人工智能测试.pdf") as pdf: page = pdf.pages[0] table = page.extract_table() # 提取表格数据for row in table:print(row)表格内容提取结果如下所示,是完全正确的:
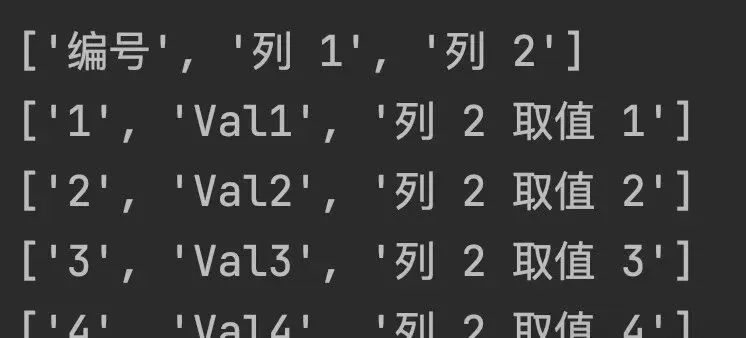
不过也有个小问题,有些扫描件如果图片质量不好,识别效果会打折扣。我试着处理了一张手机拍的模糊作业照片,结果有些地方识别错了,后来发现需要先调整图片清晰度再转换效果更好。
适合谁
经常需要处理扫描文档的学生和老师,可以把教材和作业转换成可编辑的文字。需要从PDF提取表格做数据分析的上班族,省去重新打表格的麻烦。家里有很多纸质文档需要电子化的家长,可以快速整理孩子的作品和资料。
我的看法
这个工具最大的优点是免费开源,而且识别准确度高,特别是对表格的处理能力很强。但它不擅长处理图片质量差的扫描件,而且需要一定的命令行操作基础,对完全不懂技术的人来说可能有点门槛。我觉得它最适合那些经常需要处理PDF文档、愿意花一点时间学习基础操作的学生和上班族。
下载/地址
GitHub地址:https://github.com/jsvine/pdfplumber
📌 访问提示:(注:github.com 为境外站点,国内网络下打开可能不稳定;打不开时稍等再试,也可在微信搜索软件名获取官方渠道)