ARTICLE · 1316375
WeKnora 实战:Excel 查得到,为什么工单总数算不准?
WeKnora 实战:Excel 查得到,为什么工单总数算不准?
把一张售后工单表上传到知识库,问一句:“上个月一共关闭了多少工单?” 这个问题看起来比解释一份制度简单:不用理解复杂条款,数一数就行。 但如果 AI 给出了一个数字,还附上几条工单引用,你敢直接把它填进月报吗? 要确认的第一件事是:它到底统计了整张表,还是只数了找出来的几条记录? 第二件事更容易漏掉:你说的“上个月关闭”,它是不是理解成了“上个月创建,而且已经关闭”? 下面用一份只有 12 行的虚构工单表,把这两个问题拆开。数据和 SQL 已在本地核算;WeKnora 部分给出配置与验收方法,不冒充已完成的部署实测。 查“工单 T002 的状态是什么”,与查“十月关闭了多少工单”,需要的证据范围不同。 前一个问题,可以围绕明确编号找到对应记录。后一个问题,需要检查统计范围内的全部数据,再按条件筛选、去重和计数。 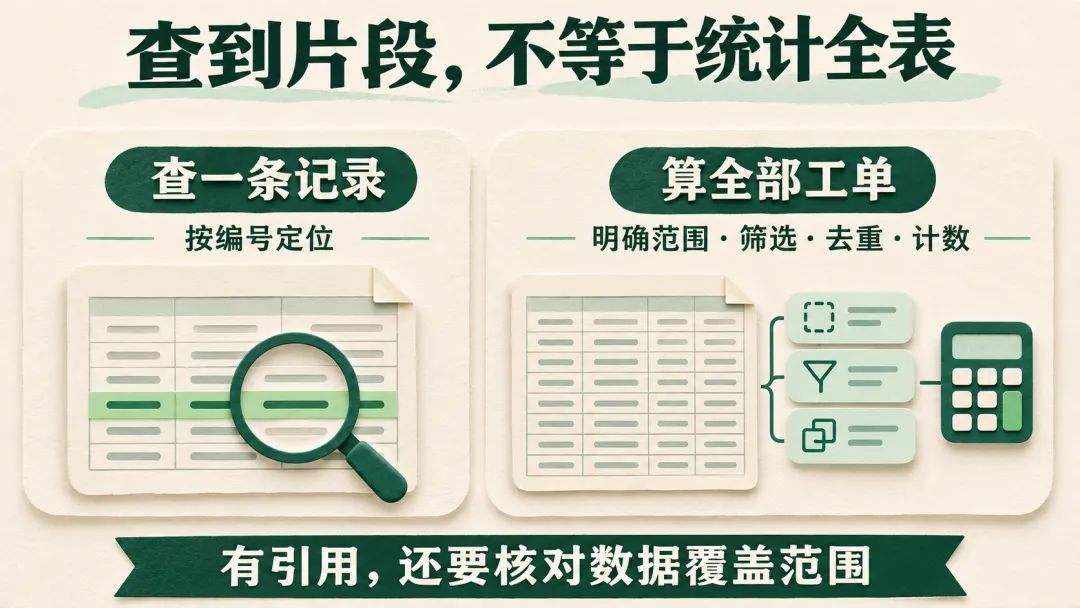
普通 RAG 问答通常先检索相关片段,再交给模型组织回答。WeKnora 官方文档也将快速问答描述为检索后生成的路径。 假设一次问答只拿到了三条已关闭工单,模型把这三条数对了,也不能据此证明全表只有三单。局部计算正确,仍然可能得到错误的总数。 给出引用,只能帮助核对它用了哪些材料,不能自动证明所有符合条件的记录都被检查过。 当然,小表完整进入上下文时,模型也可能直接算对。这里要检查的是实际覆盖范围,不能看见 Excel 就断言 RAG 一定失败。 一旦问题变成“全部、合计、平均、分组、排名”,就应该追问:有没有对完整且正确的数据范围执行相应计算? 下面是完整教学数据。日期均为 2026 年,表内用统一日期格式保存;“—”表示空值。
这份表故意放进了三个容易踩的坑。 T002 完全重复了一行。它仍然是一张工单,不能因为导出重复就算两单。 T001 和 T006 是九月创建、十月关闭。如果问的是十月关闭量,它们应该算进去。 T008 有关闭日期,状态却是“已取消”。本例业务规则明确将取消排除,不能只看日期非空就算成关闭。 因此,先把问题改写成一条可以执行的口径: 答案是6 单:T001、T002、T003、T006、T007、T009。 不去重,会得到 7 条记录;额外要求“十月创建”,则只剩 4 单。 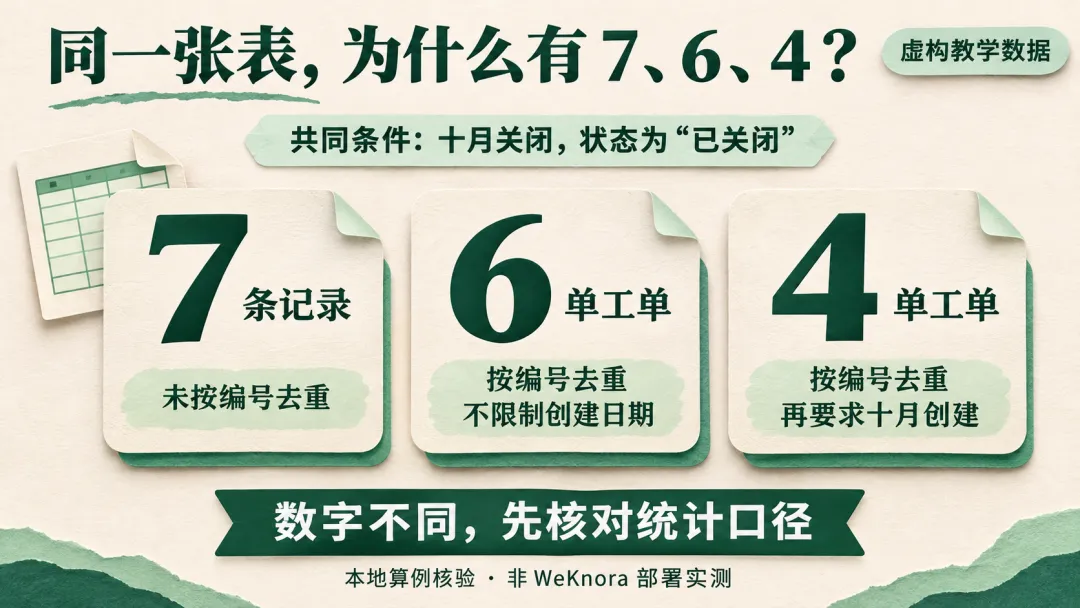
7、6、4 都能算出来,但它们回答的是不同问题。真实业务中,“取消算不算关闭”应由业务负责人确定,本文规则只服务这个演示。 WeKnora 当前官方文档提供面向 CSV、XLSX 的“数据分析师”,使用 data_schema 和 data_analysis 工具。这给了我们一条可检查的处理路径。 先做一个小实验,不急着上传全年所有报表。 第一步,准备一张结构清楚的表。 一行表头、一行一条记录,去掉标题装饰行、合并单元格和底部合计行。本例字段为 ticket_id、created_at、closed_at、status。 日期统一成 2026-10-01 这样的完整格式,编号按文本保存,状态值统一,空日期留空。附带的 CSV 可以用 Excel 打开,也可以作为演示文件上传。 第二步,明确文件和智能体。 在自己的版本中找到数据分析师,将这份文件放在它可访问的范围内,确认文件处理就绪。若界面没有相应入口,先核对部署版本,别假设切到任意智能推理就一定能做表格分析。 第三步,先核对表结构,再统计。 官方源码中,data_schema 用于读取表结构信息;没有相应结构信息时会报错。如果字段识别已经不对,就应先处理导入与解析问题。 可以这样提问: 之后核对实际工具调用和返回值。回答里写了“已分析”,不足以代替执行记录。 按当前官方源码,data_analysis 会把选中的 CSV 或 Excel 载入 DuckDB,并通过 dataset 这个表名执行只读 SQL。 在本例字段和日期格式正确的前提下,核心查询是: 不用会写代码,也可以看懂这里的三个决定。 DISTINCT ticket_id 表示按编号去重;日期条件用的是关闭时间;状态条件把取消排除在外。 右边界写成“小于 11 月 1 日”,可以表达完整十月。如果实际字段含时分秒,也不会因为误写成“截至 10 月 31 日零点”而漏掉最后一天的大部分记录。 本文用这段查询在本地 SQLite 中核验了教学数据,结果为 6。日期使用统一格式的文本;这项核验说明算例一致,不等于已在 WeKnora 的 DuckDB 中执行。 SQL 能严格执行条件,但业务口径仍要由人确认。如果日期列识别成混乱文本,或者把创建日期写进筛选条件,查询照样可能顺利返回一个不合用的数字。 实际数据中的重复也未必像本例这么简单。同编号若分别记录“已关闭”和“重新打开”,需要先判断它是重复导出,还是不同时间的状态事件,不能只加一个去重就算处理好了。 建议保留一组小题,每次换表、调配置或升级后重新检查:
最后一道题专门检查边界。 如果一张表只是当前状态快照,缺少完整状态历史,就未必能还原过去某一天的情况。本例可以讨论已列记录的日期关系,但不能据此证明十月底所有真实工单的状态。 验收时,先拿明细编号与原表核对,再看总数是否一致。一个数字恰好对上,可能只是不同错误抵消;明细与条件同时对上,才更容易发现问题。 先查数据范围:是不是选错文件、漏了月份,或者导入的数据行数与原表不一致? 再查字段结构:表头识别是否正确,日期和编号是否保留了原来的含义? 然后查统计条件:使用哪个日期、包含哪些状态、按什么去重?如果有多个工作表,还要确认数据来自哪些表页。官方工具存在多 Sheet 合并机制,不能默认它只处理你眼前打开的一页。 最后查执行结果:工具是否成功,返回的是计算结果还是错误提示,最终文字有没有把结果转述错? 这样记录,才能分清该修数据、改口径、调整工具配置,还是修改回答要求。 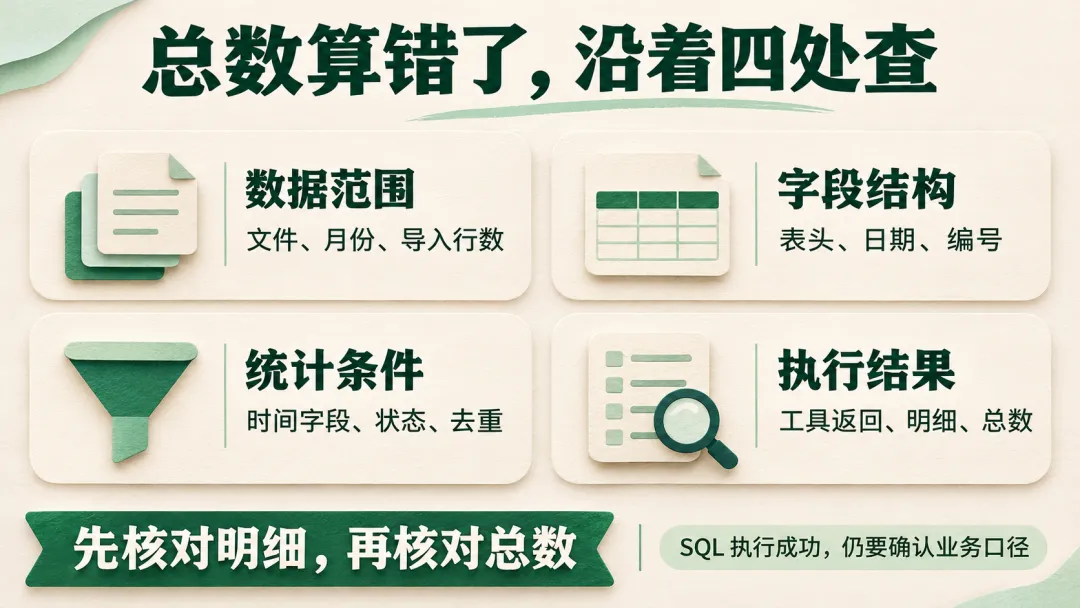
企业知识库里,“帮我找一份资料”和“帮我算一份报表”会出现在同一个聊天窗口,却需要不同的证据。 下次把一个数字填进月报前,先让 AI 说清楚:统计了哪份数据,用了哪些条件,结果能不能和明细对上。
一、能找到相关记录,不代表已经统计了全部记录
二、先别让 AI 算,自己把“总数”定义清楚
统计这份文件中,关闭日期在 2026 年 10 月 1 日至 10 月 31 日、状态为“已关闭”的不同工单编号数量。按工单编号去重,不限制创建日期,不计取消。
三、在 WeKnora 里,让统计走到实际计算那一步
只使用指定的工单教学文件。先检查字段,再按关闭日期统计 2026 年十月状态为“已关闭”的工单,按 ticket_id 去重,不限制创建日期。执行查询,给出去重后的编号清单和总数,并说明过滤条件。工具失败或数据不足时,请明确说明。
四、一段很短的 SQL,暴露了统计里的关键选择
SELECT COUNT(DISTINCT ticket_id) AS closed_ticket_countFROM datasetWHERE status = '已关闭'AND closed_at >= '2026-10-01'AND closed_at < '2026-11-01';
五、别只核对一个数字,至少再问这几道题
六、算错以后,沿着四个位置查