ARTICLE · 1319552
旧安卓手机能当 AI 服务器吗?我拿它和另外两台机器算了笔账
👋 新号开张,点一下蓝底名字,关注就能收到更新
摘要:旧安卓手机跑大模型的教程满地都是,但没人说清它到底能顶什么活。我拿自己 NAS 上每天 142 次模型调用算了笔账:慢根本不是问题,卡住它的是后台存活和模型够不够聪明。附一份 24 小时自测清单和判定表,照着测一晚上就有答案。
前几天刷到一篇文章,标题很抓人:「6GB 旧手机跑大模型,OpenAI 接口随便调」。
我第一反应是翻抽屉。第二反应是——先别翻,算笔账。
因为我家那台 NAS 上正好有个想挪走的东西,而我还有个 99 块一年的小备选。旧手机到底值不值、到底能顶哪个活,光看教程看不出来,得摆一起比。
先说结论:慢从来不是拦路虎。
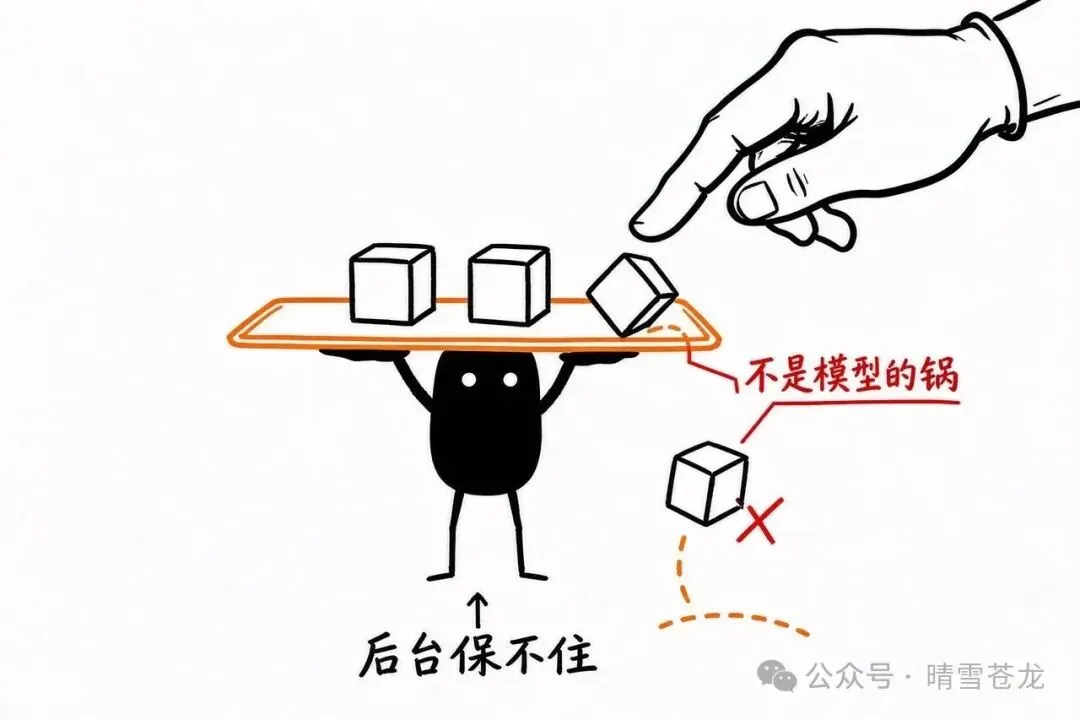
真正卡住旧手机的是三件更麻烦的事:后台会不会把它杀掉、内存门槛被算错了、模型够不够聪明。
而且先交代一句:下面凡是需要真机实测才能得到数字,我都会标出来。我把账算给你看,实验你自己做——这反而更适合你,因为你手上那台旧手机什么脾气,只有你知道。
一、我为什么想挪这件事
先交代背景,不然这账没法算。
我 NAS 上跑着一套「每日信息聚合」,干了半年多了。每天早上 7 点和中午 12 点各跑一轮,把知乎、B 站、微博这些源抓回来,一条一条丢给模型做摘要、分类、打分,然后按分类推给我。
它今天还在跑。首页上写得明明白白:
「上次手动抓取:2026-10-12 16:19:30 · 耗时 1146s · 抓取 71 条 / 分析 71 条 / 推送成功」
71 条抓取,71 条分析。 一天两轮,142 次模型调用。
有意思的是它的模型链——我读了自己的源码(src/analyzer.py):
python
ANALYZE_MODELS = [ "glm-4.7-flash", "glm-4.5-flash", "glm-4-flash", "glm-5.3-flash",]四个模型排着队,前三个免费,第四个才收费。代码里的注释写得很直白:
「💰 免费模型均不可用,切换到收费模型 glm-5.3-flash(会产生费用)」
所以这套活今天几乎不花钱,但它有四个隐患:
1. 免费额度不是永久的,用量策略随时可能变
2. 数据要出门——几百条抓来的内容全发到云上
3. 我 NAS 的盘已经 100% 满(3.6Ti 用了 3.6Ti,只剩个位数 GiB)
4. 哪天这个服务挂了,我得临时找地方接手
这四条,正好是"把活搬到自己机器上"能解决的。 旧手机是候选之一,99 块云服务器是另一个。
二、慢从来不是问题
先把最容易算错的那笔账算清楚,省得后面被带偏。
我用真实数据算的:把库里全部 119 条抓取结果跑了一遍,标题平均 33 字,正文截断到 800 字符后平均 179 字,再加固定模板和一个示例——
单条输入约 288 token,输出约 80~120 token。
于是:
· 一次抓取 71 条 → 输入约 2 万 token、输出约 0.8 万 token
· 一天两轮 142 条 → 输入约 4.1 万 token、输出约 1.6 万 token
每天 142 次调用,输出总量 1.6 万 token。
那手机得多快才够?假设一天只让它跑 6 小时(21600 秒),平均需要:
0.72 token/s。
这个数,小学生做的计算器都嫌慢。任何一部 2015 年后的手机,跑本地小模型的输出速度都在这个数几十倍之上。
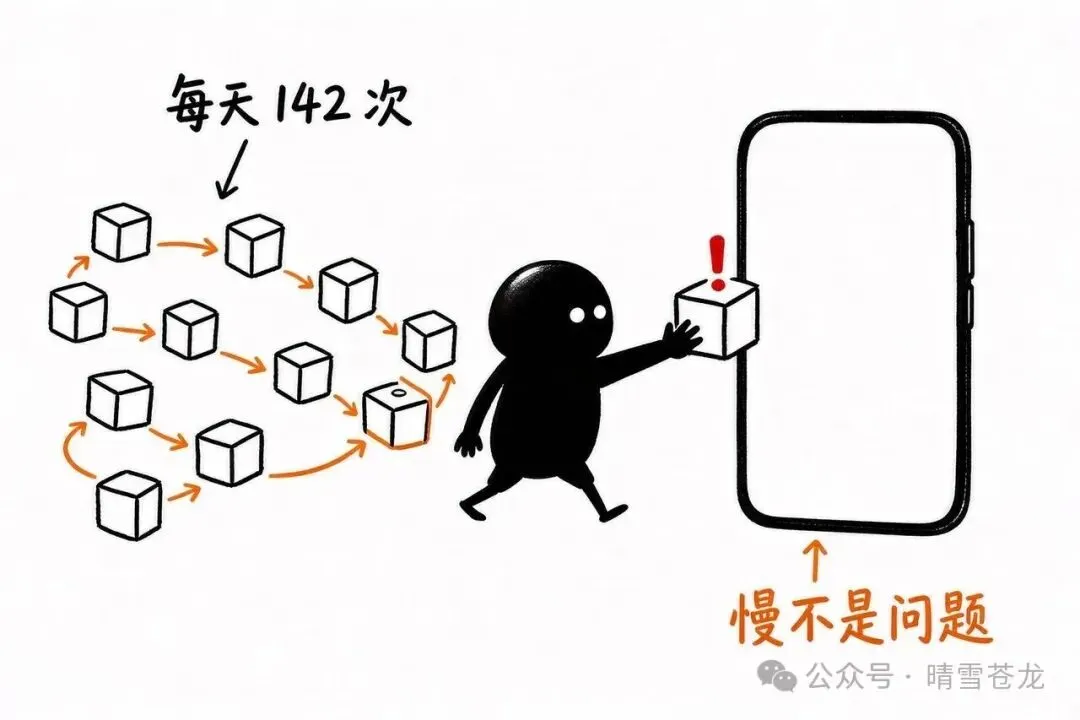
所以「旧手机跑不动大模型」这句话,如果指的是速度,那是错的。
(顺便一个巧合:我上面这个 token 估算法,和我用的那个开源项目的算法一模一样——它没做 tokenizer 接口,只能「用字符数 ÷ 4」来估。我们在用同一套土办法。)
那拦路虎在哪?在下面三条。
三、第一道坎:不是性能,是格式和内存
3.1 它不是"安卓版 Ollama"
现在最火的那个项目叫 OlliteRT(Apache-2.0 开源,GitHub 600 多星)。它自己的 README 第一句是:
Think of it as Ollama for Android. Pick a model, tap Start, and your phone becomes an LLM server — runs LLMs on your mobile GPU/CPU via Google's LiteRT-LM runtime and serves them as a standard OpenAI-compatible HTTP API on your local network.
听起来就是 Ollama 搬到了手机上。但它不是。
README 的 Limitations 里写着:
No GGUF support — only .litertlm models are supported (LiteRT runtime limitation).
它下的是 .litertlm,不是 GGUF。 所以你按 Termux 装 Ollama 的教程走,模型根本下不下来。
它自己列的限制还有几条挺关键:
Single model, single request — one model loaded at a time, requests queue sequentially.
Token counts are estimated — the LiteRT runtime doesn't expose a tokenizer API, so counts are approximated using character length ÷ 4.
还有架构限制:只支持 arm64-v8a(其他架构不支持,模拟器上会崩),默认端口 8000(不是 Ollama 的 11434)。
3.2 "6GB 就能跑"这句话只对了一半
官方写的门槛是:
Requires: Android 12+ · arm64-v8a device · 6 GB RAM minimum · 8 GB+ recommended for multimodal models
官方模型表(我照抄):
| 8GB | ||||
| 12GB | ||||
| Gemma 3 1B | 6GB | |||
| Qwen 2.5 1.5B | 6GB | |||
| DeepSeek-R1 1.5B | 6GB |
看第三行往下就明白了:6GB 只够跑 1B 那一档纯文本模型。 官方主推的 Gemma 4 E2B 要 8GB。
而且 8GB 是整机总内存,不是可用内存。 官方文档 docs/MODELS.md 里这句必须抄下来:
The 'Min RAM' column refers to your device's total RAM, not available RAM.
A device with exactly the minimum RAM may experience slow performance or out-of-memory (OOM) kills — Android forcefully closing apps to free RAM.
翻译:8GB 的手机,系统本身要占掉一大块,你真正能喂给模型的可能只有一半。 踩着最低线买回来,多半是"能启动,一用就被系统杀掉"。
还有两条官方自己标出来的限制:
Tool calling is experimental and may not always be reliable due to model limitations.
工具调用是实验性的,小模型经常不按格式来。你想让它"帮我发个消息",大概率要失望。
以及:它不是装完就能接进家里自动化。 官方专门写了 Home Assistant 需要另装第三方集成(Extended OpenAI Conversation、Local OpenAI LLM、OpenAI STT HASS)。
四、第二道坎:活干得好好的,一夜之间没了
这一条是安卓当服务器的头号敌人,是系统设计问题。这次我找到了一手依据,不用再讲"听说"。
4.1 Android 官方文档:息屏 + 不插电 = 掐网
Google 官方《Optimize for Doze and App Standby》(页面标注 Last updated 2026-10-22)原话:
If a user leaves a device unplugged and stationary for a period of time, with the screen off, the device enters Doze mode. In Doze mode, the system attempts to conserve battery by restricting apps' access to network and CPU-intensive services.
官方那张设备状态表里,「Screen off and doze is active」这一行的网络访问写的是:
Restricted during doze
但同一份文档里还有一句,是整套逻辑的关键:
When the user wakes the device by moving it, turning on the screen, or connecting a charger, the system exits Doze and all apps resume normal activity.
插着充电器,系统就不进 Doze。
所以规则其实是这样的:手机当服务器必须插电 → 插电就不进 Doze → 这一条安卓官方是祝福你的。
4.2 国产 ROM 直接明文杀进程
Android 官方管得住自己,管不住厂商。小米澎湃 OS 的开发者文档《Powerkeeper 对应用的管控说明》里有这么一段(这是官方现在还挂着的现行文档,虽然页面标注更新时间停在 2022-12-07):
在没有不良系统健康行为的证据下,小米不会主动对这些应用做出限制,不过在检测到例如:后台长期持锁,虽然置于后台但是短时间内耗电过多,长时间置于后台不使用……时,我们会对该应用进行限制,包括:释放锁资源,kill 应用进程等
把这句总结一下:
一台手机要连续跑 24 小时推理,必然「后台长期持锁」+「短时间内耗电过多」——这恰好就是小米官方文档里写的、会导致"kill 应用进程"的两个条件。
所以国产 ROM 的省电逻辑和"24 小时推理服务器",在设计上是对立的。不是"记得去设置里开白名单"就能解决的。
4.3 项目方自己承认有三种死法
那个 OlliteRT 的故障排查文档写得比谁都诚实,它列了三种崩法:
Out of memory — Android kills background processes when RAM is low... A large context window on a device with limited RAM can also trigger OOM kills
Thermal shutdown — prolonged heavy use can overheat the phone. In mild cases Android throttles the CPU/GPU (slower responses), in severe cases it shuts down the device entirely to protect the battery
Battery optimization — OlliteRT requests battery optimization exemption during initial setup, but if it was denied or later revoked, Android may kill the server in the background
OOM 被杀、热保护整机关机、电池优化被撤销后后台被杀——三种死法,全是官方文档自己写的。
五、第三道坎:电和温度,以及"600 星"这个数字
5.1 别被 600 星骗了
这个项目现在 GitHub 600 多星。但我更看重另一个数:
它的 APK 累计下载量是 2180 次。
而且——GitHub 上 4 个 Release,全部是 prerelease=true,一个稳定版都没有。 最新那个 v0.9.7-beta.1 发布于 2026 年 9 月 22 日,到今天已经 6 周没更新。商店里也没有(没上 Google Play,也没上 F-Droid)。
600 星是"我 star 一下",2180 次下载才是"我真的装了"。
更要命的是那些流传的速度数字。我查了出处:
· 「9–11 tokens/s」和「30 tokens/s」——这是项目作者本人在 Reddit 上自报的,用的是他自己的 Nothing Phone (1) 和 OnePlus 13R
· 有篇法语评测站写得很客气:「本文基于 GitHub 仓库、README 和版本历史,未主张做过吞吐或耗电实测」
· 唯一一篇设备型号和速度都齐全的第三方实测(5–6 t/s),跑的是 llama.cpp + Termux,不是这个项目
作者自己也在 Reddit 说过一句话,我觉得比什么都实在:
I used vibe coding throughout the development of this app.
一个人 + AI 辅助开发、单人项目、下载 2180 次、零稳定版。 这不代表它不能用,但它决定了:「README 说能跑」和「实际稳定跑住一夜」之间的距离,不能靠项目方的自述来填。
5.2 电和温度
功耗数字,项目方自己给的:
roughly 5-10W (depending on phone model) while the model is generating responses, near-zero when idle with keep-alive unload enabled.
看着很省。但同一个生态里另一个安卓 LLM 服务项目的 README,写得诚实得多:
This app prioritizes performance over battery life:
- Screen stays on (prevents GPU throttling)
- CPU runs at full speed always
- Battery drains 2-5x faster than normal
- Device gets warm/hot during use
Recommendation: Keep device plugged in during use, but disable Fast Charging.
同一批项目,一个说"5-10W,很省",一个老老实实写"掉电快 2-5 倍、机身发烫、屏幕必须常亮、插电还得关快充"。
这说明「5-10W」和「适合 7×24」不是同一件事——你还得算上屏幕常亮和长期插电的额外代价。
顺便把项目自己的警告抄下来(官方 FAQ):
For continuous use: keep the phone plugged in, remove the case for better heat dissipation, and place it on a cool, hard surface. Check the phone periodically for heat or battery swelling — especially older devices. Don't run OlliteRT on a phone that already has battery issues.
还有作者在 README 里写的那句免责声明:
I am not responsible for any swollen batteries, crispy phones, or spontaneous pocket warmers. Please don't run your LLM on your phone while it's under your pillow. You've been warned.
「鼓包电池、烤焦的手机、口袋暖手宝,我不负责。」
一个开源作者主动把电池风险写进 README,这事本身就说明问题。
但这里我必须说清楚一件事:我没有找到任何"手机跑本地大模型导致电池鼓包"的公开实测个案——搜到的鼓包讨论全是笔记本圈。所以别把"很多人跑鼓包了"当结论。我能确认的只有官方这句"请定期检查是否发热或鼓包"。
5.3 真正跑 24 小时的老办法,需要 root
有一份公开的老机器实测方案(设备是 10 年前的 OnePlus 3T),它的做法是:装 Magisk 模块 Advanced Charging Control,把充电设成 75% 停充、70% 恢复。原话:
the battery no longer acted as a heat sink while plugged in, which noticeably reduced sustained temperatures and made 24/7 operation practical
但它需要 root,作者自己也写了风险:voided warranty, potential bricking(失去保修,可能变砖)。
而且这台机器上跑 4B 模型的实测速度是:「only about 2 tokens per second, making it impractical for most uses」。
2 token/s,日常对话基本不可用。
六、算笔账:旧手机 / 我那台 NAS / 99 元云服务器
现在把三台机器摆一起。
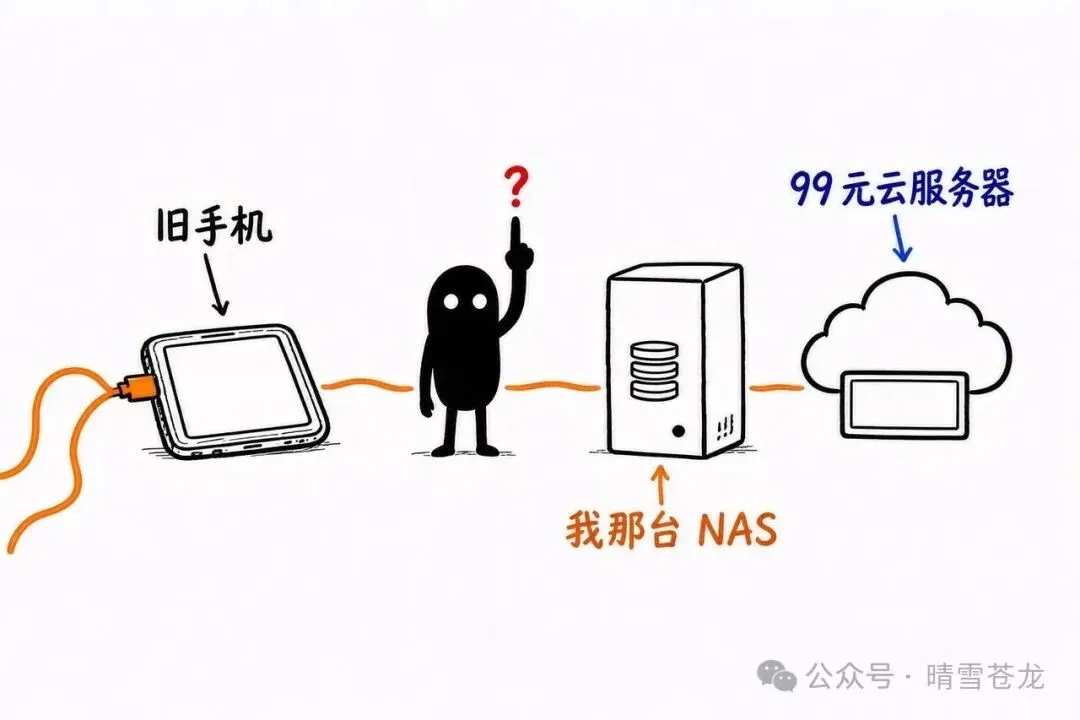
先说我那台 NAS 现在在干什么
它一个模型都不跑。 compose 文件里四个服务(简报 web、简报 cron、RSSHub、wewe-rss),全是抓取和转发的,没有一行推理代码。
模型调用全在云上。也就是说——
我的 NAS 是一个"抓取器 + 路由器",它本身就不适合干推理的活。 它真正的瓶颈是磁盘(满了)和抓取稳定性,不是算力。
所以"把旧手机接进来替 NAS"这个说法本身就不成立:该被替的不是 NAS,是云 API。
顺带说个反常识的数:树莓派已经出局了
很多人推荐"买树莓派代替旧手机"。我查了官方数据,发现情况变了。
Google 官方的 LiteRT-LM 性能表,同一个 Gemma-4-E2B:
| 52 tk/s | 0.3 s | |
| 树莓派 5 16GB(CPU) | 8 tk/s | 7.8 s |
旗舰手机在这个场景下,速度是树莓派的 6 倍多,首字延迟差 26 倍。
而价格那边,树莓派 2026 年一直在涨:
· Pi 5 8GB:从 $80 涨到 $125
·Pi 5 16GB:2026 年 2 月涨到 $205,2026 年 11 月 2 日又涨 $80,到 $385
根因是内存涨价——LPDDR4 产能被 AI 数据中心抢走了。AI 抢走了内存产能,手机因为内存厂产能被挤占而变贵,反过来让"用旧手机做 AI 服务器"这个方案更划算。
99 块那台是什么
阿里云 99 计划,官方页面上写的是:
「2核2G,3M固定带宽不限流量 | 新老同享,续费同价,一口价锁至2029年」
「99元/年一口价,锁到2029年3月31日」
另外还送主机安全和 100GiB 文件备份。
2 核 2G 跑模型?能跑,但只能跑 1B–1.5B 那个档位,跟旧手机是同一个级别。它赢在三件事:不会被系统杀、有公网 IP、坏了换个 IP 就好。它输在数据要出门和99 块一年。
三台机器的账
旧手机
· 成本:0(家里吃灰的)
· 算力:6GB 机型只到 1B–1.5B 级(官方模型表);8GB 才够官方主推的多模态模型,而且这 8GB 是整机总内存
· 接口:并不寒酸——默认 http://手机IP:8000/v1,OpenAI 兼容、/v1/messages 连 Anthropic 格式也兼容,还有 Prometheus /metrics
· 数据:完全不出门,这是它唯一的、也是不可替代的优势
· 稳定性:最差,系统会杀它、ROM 会杀它、热了会整机关机
· 适合:低频、单请求、几秒内完成、离线也能用、不需要高质量输出的活
我那台 NAS
· 成本:电费 + 硬盘折旧
· 算力:它压根不跑模型
· 真实角色:抓取、存储、编排
· 适合:需要大存储、需要 7×24、需要多个服务互相调用
99 元云服务器
· 成本:99 元/年,锁到 2029 年 3 月
· 算力:2 核 2G,1B–1.5B 级,和旧手机同档
· 稳定性:最好,没人杀它
· 数据:要出门,境内机房
· 适合:需要公网访问、需要别人也能访问、不能断
所以,谁干哪个活
按我的这套东西分:
1.抓取、存储、编排 → 继续留在 NAS。 它干这个最合适,磁盘满了要清,但架构不动
2.每天 142 次摘要和打分 → 这是唯一值得讨论要不要挪的活
3.如果挪,我倾向先挪到 99 元那台,不挪旧手机。 因为这活必须 7×24 稳定(早 7 点那轮不能错过),而稳定恰恰是旧手机最不靠谱的地方
4.旧手机真正适合的是另一类活:相册打标签、聊天记录脱敏、RSS 预筛、智能家居指令解析——低频、离线、单请求、能接受弱模型。这些活我 NAS 上还没做,属于"想做但一直没腾出手"的
换句话说:旧手机不是 NAS 的替代品,也不是云服务器的替代品,连树莓派现在也不是它的对手。它是第三类东西——一台不用花钱、断网可用、性能甚至反超树莓派,但你不该指望它 7×24 的小机器。
硬要给它派活,就派那种"跑砸了也没关系"的活。
七、给你一张自测清单
照着测一晚上,你就有答案了。
第一晚(测活)
1. 装上模型服务,连局域网另一台机器访问一次
2. 确认它能返回结果,把延迟记下来
3.关屏,让它自己跑一夜
4. 第二天早上看:进程还在吗?服务还在吗?模型还加载着吗?
第二晚(测电和热)
1. 充满电,插着电,记录开始时的电量百分比
2. 中途每两小时看一眼电量,记一次;用手摸一下机身温度,记一次
3. 早上看总耗电百分比
4.看看电池有没有异常发烫
第三步(测你真正要跑的那个活)
1. 拿 20 条你真的需要处理的活(比如那 71 条简报里的 20 条),让手机做一遍
2.再让云上那个模型做一遍同样的 20 条
3.两个结果摆一起比
第 11 步是整张清单里最重要的。如果旧手机的版本你用得下去,那它就成立;如果用不下去,那前面测再多也没意义。
判定标准我给你三条:
· 睡一觉之后服务还活着 → 过了
· 24 小时耗电没有超过 30% → 过了
·第 11 步的比对结果你接受 → 过了
三条都过,这台旧手机就能上岗。只过两条,就当它是玩具。
八、一张判定表:什么活该给旧手机
最后给个能直接抄走的判断法。同时满足越多,越适合。
适合旧手机的活
· 一天跑不到几十次
· 每次几秒内出结果
· 数据不能出门(这是最硬的一条)
· 输出是标签、分类、过滤、摘要草稿这类"用完就扔"的东西
· 偶尔跑砸了,重跑一次没关系
· 人在家里,手机插着电
不适合的
· 要 7×24 准点(早 7 点的推送错过就是错过)
· 要长上下文、大文档
· 要并发(它一次只服务一个请求,官方原话:requests queue sequentially)
· 输出了要直接给人看(弱模型撑不住)
· 要公网能访问
· 要工具调用(官方标了 experimental)
拿我的活套一下:每天 142 次摘要打分——次数不多、几秒内出结果、输出是分类和草稿,看着像适合。但它有两个硬伤:早 7 点那轮不能错过,而摘要要直接推给我看,弱模型撑不住。
所以我自己的结论是:这套活不挪旧手机,挪 99 元那台;旧手机留给"相册打标签"这种还没做的活。
最后一句
旧安卓手机当 AI 服务器这件事,网上吵了两极:一边说"早就不是新闻了",一边说"新玩具真香"。
两边都缺一个东西——没人告诉你它到底能顶什么活。
教程教的是怎么装,教程不会告诉你装完该派它干什么,更不会告诉你它会在哪个夜里被系统悄悄杀掉。
而这三件事,恰恰是决定一台旧手机有没有用的全部。