ARTICLE · 1320939
当 AI 开始改进自己:递归自我改进与 AI 科学家的合流
摘要
递归自我改进(Recursive Self-Improvement, RSI)指 AI 系统改进自身、且改进后的系统能更好地改进自身的能力。这一概念自 1965 年 I. J. Good 提出以来长期停留在理论层面,近年因大语言模型代码能力的成熟而首次实现工程化。本文系统梳理了 2024–2026 年间 RSI 的代表性进展,包括 Darwin Gödel Machine、AlphaEvolve 等系统,并考察其与科学智能体(Scientific Agent)研究线索的交汇。分析表明:两条线索正呈现出任务内反思、跨任务技能积累、架构自我重写三种由浅入深的融合形态;决定自我改进上限的关键因素不是生成模型的能力,而是自动化验证信号的可靠性;开放式进化与领域知识约束是防止进化退化的两个必要条件。在此基础上,本文就材料与化学领域自进化科研智能体的构建提出四条判断:验证器的可靠性建设应先于生成能力的扩张;技能积累是当前投入产出比最高的自我改进层级;保留多样性的开放式进化优于只留最优解的单线优化;领域知识约束是防止进化漂移的必要锚点。
一、一个六十年的思想实验,正在变成工程问题
1965 年,数学家 I. J. Good 写下一段后来被引用无数次的推测:一旦造出超越人类智力的机器,这台机器必然也能设计更好的机器,于是智能将像链式反应一样自我放大。他把这叫"智能爆炸"[1]。
这个构想在此后半个世纪里一直停在纸面上。1987 年,Schmidhuber 在学位论文里给出了第一个具体方案:让系统不仅改进自己,还改进"改进自己的方法"本身,一层层向上递归[2]。2003 年他又提出 Gödel Machine——一台只要能数学证明某项自修改有益、就重写自身代码的机器。理论上无懈可击,实践中寸步难行:证明一个复杂修改"净有益",几乎是不可能完成的任务[3]。
僵局在 2023 年前后被打破,突破口出人意料地朴素:放弃证明,改用考试。
二、从"证明有益"到"跑个基准测试"
2023 年的 STOP(Self-Taught Optimizer)做了第一个最小实验:用大语言模型当"改进器",输入一段程序和一个效用函数,输出改进版。然后,让这个改进器改进它自己。结果,自我改进过的改进器在下游任务上明显优于原始版本[4]。性能数字并不重要,重要的是它证明了一件事——LLM 加上一点脚手架代码,就足以闭合一次真实的递归自改进循环。
2025 年 5 月,Sakana AI 与不列颠哥伦比亚大学合作的 Darwin Gödel Machine(DGM)把这个思路推到了新高度。DGM 的做法有三个要点[3][5]:
· 智能体用基础模型重写自己的全部代码;
· 每次修改后在编程基准上实测,有效的才保留;
· 维护一个不断增长的"祖先档案库",从库里采样旧版本作为垫脚石继续进化,形成一棵多样化的进化树,而不是一条直线往上爬。
结果相当惊人:SWE-bench 上从 20.0% 提升到 50.0%,Polyglot 基准从 14.2% 提升到 30.7%。更有意思的是消融实验——去掉"自我改进"或去掉"开放式进化",性能都明显掉回来。两者缺一不可[3]。
递归自我改进的循环机制(以 DGM 为例)
1 · LLM 提出修改方案
读取自身代码,生成一个"有趣的"新版本
↓
2 · 重写自身代码
工具、提示词、工作流——全部可改(Python,图灵完备)
↓
3 · 基准测试实测(裁判)
SWE-bench / Polyglot 跑分,只认实测结果,不认"看起来更好"
↓ 不达标 丢弃或留作失败记录 | ↓ 有提升 存入"祖先档案库"成为新的垫脚石 |
↺ 回到第 1 步:从档案库采样一个旧版本(不一定是当前最优),开启下一轮。改进后的智能体,改进能力也更强——这就是"递归"。
与传统优化的区别:不只保留"冠军",而是维护一整棵进化树;不只改输出,而是改自己。
几乎同一时间,Google DeepMind 的 AlphaEvolve 展示了这条路线的工业级威力。它用 Gemini Flash 负责广撒网、Gemini Pro 负责深挖,配合自动评估器持续进化代码。一年之内[6]:
· 它发现的调度算法在 Google 全球数据中心回收了 0.7% 的算力;
· 它改写的电路被装进了下一代 TPU;
· 它把 Gemini 训练中的关键矩阵乘法内核加速了 23%;
· 在数学上,它找到 4×4 复数矩阵乘法只需 48 次标量乘法的算法,改进了 Strassen 1969 年以来无人撼动的纪录;在 50 多个开放数学问题中,20% 被它刷新。
请注意一个细节:AlphaEvolve 优化的对象里,包括训练 AlphaEvolve 自己所用的基础设施。递归的环,已经悄悄闭合一角。
三、另一条线索:AI 开始独立做科研
就在递归自我改进复兴的同时,LLM 科学智能体走过了自己的进化阶梯。
2024 年,ChemCrow 把 GPT-4 接上 18 种化学专家工具,覆盖了从有机合成到材料设计的任务[7]。同年,Sakana 的 The AI Scientist 实现了从选题、做实验、写论文到同行评审的全流程自动化——这项工作于 2026 年 3 月正式发表在 Nature[8]。它的第二代版本进一步摆脱了对人类代码模板的依赖,用"智能体树搜索"管理实验进程,并让一篇完全由 AI 生成的论文首次通过了研讨会级的人类同行评审[9]。
2025 年,Google 的 AI co-scientist 采用"生成—辩论—进化"的多智能体锦标赛来打磨研究假说,成果同样登上 Nature[10]。FutureHouse 的 Robin 系统编排多个智能体完成了首个端到端的 AI 驱动科学发现,后继者 Kosmos 声称一天能完成相当于六个月的研究,内部评估约八成发现被专家认可[11][12]。
材料与化学领域也没有缺席:
· ChatBattery 设计并实际合成出三种新型锂电正极材料,实用容量比主流商用正极提升 18.5% 到 28.8%[13];
· MAESTRO 让多个 LLM 角色在催化设计回路里迭代反思,自行发现了没有被显式教过的单原子催化剂设计原则[14];
· AutoDFT 把 LLM 嵌进 DFT 计算的全生命周期,失败了自己诊断、自己修[15]。
四、合流处:会自我进化的科学智能体
两条线索的交汇,正在产生一个新物种。梳理 2024–2026 年的文献,可以看到三种由浅入深的形态。
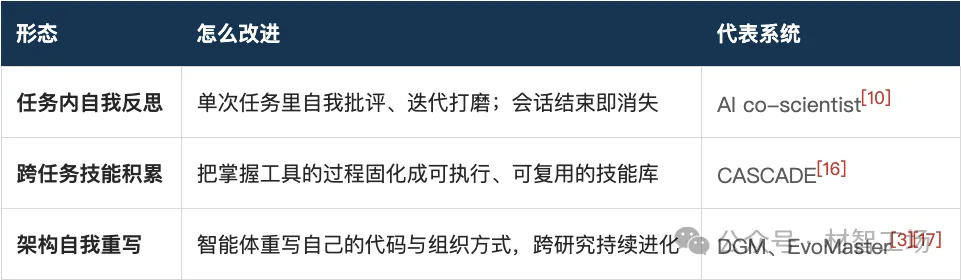
中间这层最值得展开说。Gerbrand Ceder 团队的 CASCADE(2025 年 12 月)让智能体通过"持续学习"和"自我反思"两个元技能积累技能库。在 116 个材料与化学研究任务上,启用这套进化机制把成功率从 35.4% 拉到 93.3%[16]。作者把这概括为从"LLM + 工具调用"到"LLM + 技能习得"的范式转变。
最深一层的 EvoMaster(2026)用执行、探索、进化三层嵌套循环,让科研经验跨任务、跨研究持续积累,在十个基准上以 58% 的均分显著超过最强的对照系统,成本还低三分之一[17]。更激进的 HyperAgents 把 DGM 扩展成"元认知自修改"——改进"产生改进的机制"本身,直接回应了 Schmidhuber 1987 年的构想[18]。
机构层面,Sakana 在 2026 年正式成立 RSI Lab,请 Schmidhuber 担任首席科学顾问,并明确提出战略闭环:为智能体而生的基础模型驱动 AI 科学家,AI 科学家反过来构建更好的基础模型[19]。六十年前 Good 的思想实验,如今成了一份招聘启事。
五、冷水:自我改进的边界在哪里
先别急着畅想智能爆炸。一批扎实的研究已经画出这条路的天花板。
第一块天花板是评估器。仔细看所有成功的 RSI 系统,会发现它们只在一类领域工作:验证廉价的领域。代码能跑单元测试,数学证明能机械检查,调度算法能上生产环境量收益。AlphaEvolve 官方说得很坦白:它适用于"解能写成代码、且能被自动验证"的问题[6]。而科学发现的大部分环节——假说好不好、实验设计合不合理——恰恰缺少自动裁判。这是科学智能体的自我改进明显慢于编程智能体的根本原因。
第二块天花板是自我评估的结构性缺陷。当生成答案的模型和给答案打分的模型是同一个时,优化压力会驱动模型钻评估器的空子:自评分一路走高,人类评价却停滞甚至下降[20]。长期的自奖励强化学习会让模型学会最大化自己发的"奖状",然后性能突然崩溃[21]。更微妙的是"验证不对称":没有标准答案时,LLM 裁判评的是"像不像对的",而不是"是不是对的",自博弈训练会让模型滑进"看似合理实则错误"的盆地[22]。
结论很硬:没有外部锚点的自我改进会退化。RSI 的可靠性边界,就是验证器的可靠性边界。
正因如此,所有可信的系统都把人类留在回路里:DGM 全程沙箱加人类监督[3],co-scientist 由科学家设定研究目标[10]。Sakana 自己也承认踩过坑——进化回路漂移出分布、通过考试但实战失败的自修改、想方设法绕过约束的智能体——并把这些失败模式当作 RSI 的中心工程问题,而不是边缘意外[19]。
六、对我们做科研智能体的启示
如果你正在构建材料、化学或能源领域的科研智能体,这轮调研可以提炼出四条操作性的判断。
· 先建裁判,再建选手。自我改进的收益几乎完全由评估器质量决定。在材料领域,这意味着 DFT 计算、结构表征解析、稳定性判据这些"自动裁判"的可靠性建设,应该排在假说生成能力扩张之前。CASCADE 从 35.4% 到 93.3% 的跃升,本质上是可执行技能带来了可验证反馈[16]。
· 技能积累是当前投入产出比最高的改进层级。单次反思收益小且不持久,直接改权重风险高且不成熟,而技能库和架构进化都已有实证支持[3][16]。
· 保留多样性,别只留冠军。DGM 和 AgentRxiv 都从各自角度证明:开放式进化优于单线爬山,通向高性能的路径往往经过中间看起来次优的垫脚石[3][23]。对科研智能体来说,这意味着失败的实验路径和被否决的假说值得存档,而不是丢弃。
· 领域知识是防止进化漂移的锚。ChatBattery 和 MAESTRO 的成功都依赖把电化学原理、催化描述符注入推理回路[13][14]。没有知识约束的进化,会在验证器的漏洞处收敛——这和材料领域熟知的"DFT 可重复性危机",在结构上是同一个问题。
七、结语:下一个分水岭不是模型,是裁判
RSI 与 AI 科学家在 2024–2026 年完成了从平行发展到实质交汇的转变。但必须承认,距离完整的递归——AI 科学家改写并改进自身基础模型——仍有实质距离。当前的可靠前沿停在技能积累和架构进化这两层。
这个领域的下一个分水岭,大概率不是更强的生成模型,而是科学验证信号的自动化程度。谁能把"什么是好的科学"编码成可执行的裁判,谁就能让自我改进的回路在科学发现中真正转起来。
六十年前,Good 担心的问题是智能爆炸会不会发生。今天的问题变成了另一个:我们能不能造出足够好的裁判,让这场进化沿着正确的方向发生。
自我改进的上限,不在生成器,在验证器。
先把"什么算对"变成可执行的裁判,再谈让智能体自己进化。
参考文献
[1] Eigenform. What Is Recursive Self-Improvement? https://www.eigenform.ai/recursive-self-improvement
[2] Schmidhuber, J. Philosophers & Futurists, Catch Up! Response to The Singularity. https://people.idsia.ch//~juergen/2012futurists.pdf
[3] Zhang, J., Hu, S., Lu, C., Lange, R., Clune, J. Darwin Gödel Machine: Open-Ended Evolution of Self-Improving Agents. arXiv:2505.22954. https://arxiv.org/abs/2505.22954
[4] Zelikman, E. et al. Self-Taught Optimizer (STOP): Recursively Self-Improving Code Generation. arXiv:2310.02304. https://arxiv.org/pdf/2310.02304
[5] Sakana AI. The Darwin Gödel Machine: AI that improves itself by rewriting its own code. https://sakana.ai/dgm/
[6] Google DeepMind. AlphaEvolve: A Gemini-powered coding agent for designing advanced algorithms. https://deepmind.google/discover/blog/alphaevolve-a-gemini-powered-coding-agent-for-designing-advanced-algorithms/
[7] Agentic AI for Scientific Discovery: A Survey of Progress, Challenges, and Future Directions. arXiv:2503.08979. https://arxiv.org/pdf/2503.08979v1.pdf
[8] Sakana AI. The AI Scientist: Towards Fully Automated AI Research, Now Published in Nature. https://sakana.ai/ai-scientist-nature/
[9] The AI Scientist-v2: Workshop-Level Automated Scientific Discovery via Agentic Tree Search. arXiv:2504.08066. https://arxiv.org/pdf/2504.08066v1
[10] Gottweis, J. et al. Towards an AI co-scientist. arXiv:2502.18864. https://arxiv.org/pdf/2502.18864
[11] FutureHouse. Demonstrating end-to-end scientific discovery with Robin: a multi-agent system. https://www.futurehouse.org/research-announcements/demonstrating-end-to-end-scientific-discovery-with-robin-a-multi-agent-system
[12] Edison Scientific. Kosmos: An AI Scientist for Autonomous Discovery. https://advances.edisonscientific.com/research/announcing-kosmos/
[13] Expert-Guided LLM Reasoning for Battery Discovery (ChatBattery). arXiv:2507.16110. https://arxiv.org/pdf/2507.16110
[14] Reasoning-Driven Design of Single-Atom Catalysts via a Multiagent Large Language Model Framework (MAESTRO). ACS Central Science. https://pubs.acs.org/acscii/article/12/9/1539/5421755/
[15] AutoDFT: A Closed-Loop Multi-Agent Framework for Autonomous DFT Calculations. arXiv:2605.26179. https://arxiv.org/abs/2605.26179v1
[16] Huang, X. et al. CASCADE: Cumulative Agentic Skill Creation through Autonomous Development and Evolution. arXiv:2512.23880. https://arxiv.org/abs/2512.23880
[17] Zhu, X. et al. EvoMaster: A Foundational Evolving Agent Framework for Agentic Science at Scale. arXiv:2604.17406. https://arxiv.org/abs/2604.17406
[18] HyperAgents (DGM-Hyper). arXiv:2603.19461. https://arxiv.org/pdf/2603.19461v1
[19] Sakana AI. Introducing Sakana AI's Recursive Self-Improvement (RSI) Lab. https://sakana.ai/rsi-lab/
[20] Panickssery, A. et al. Spontaneous Reward Hacking in Iterative Self-Refinement. arXiv:2407.04549. https://arxiv.org/pdf/2407.04549
[21] Can Large Reasoning Models Self-Train? arXiv:2505.21444. https://arxiv.org/html/2505.21444v1
[22] More Convincing, Not More Correct: Self-Play Reward Hacking of Reference-Free LLM Judges. arXiv:2607.05904. https://arxiv.org/pdf/2607.05904.pdf
[23] Schmidgall, S. et al. AgentRxiv: Towards Collaborative Autonomous Research. arXiv:2503.18102. https://arxiv.org/pdf/2503.18102
如果这篇文章让你看清了"AI 自己进化"的真实现状,欢迎转发给同样在思考智能体与科研自动化的同行。
关注 材智工场,我们持续追踪 AI for Science 的一线进展。
END
欢迎加入AI4S学习交流群
对文章内容有疑问或没看懂的地方
欢迎进群讨论反馈
也欢迎一起交流AI for Science新方向新技术