ARTICLE · 1325122
QwenPaw * Jev|帮助 AI 助手在关键处快速进行判断
想象这样一个场景:明天你要向客户汇报项目进展,会议纪要、进度表和客户反馈却散在好几个文件里。你想让 QwenPaw 帮你把这些资料整理成一份汇报草稿,讲清楚项目进展,也列出还没确认的问题。
助手整理资料、修改文件时,需要判断每次操作是否存在风险;讨论持续一段时间后,它还需要记住交付日期、验收要求等重要信息。QwenPaw 接入的决策模型就用在这两处:工具审批时,评估操作风险,让符合条件的低风险操作自动执行,减少对你的打扰;长对话压缩时,筛选资料,尽量保留后续还要用到的内容。你可以选择以低延迟、低成本为设计目标的 TypeSafe 云端决策模型 Jev,也可以使用在本机运行的 Piccolo。
01
认识决策模型
决策模型擅长回答明确、具体的问题,比如从几个选项中选出一项,或判断某个条件是否成立。应用把相关信息和问题交给它,它会按固定字段返回结果,供程序继续处理。举个例子,在 Jev 的官方邮件示例中,一封邮件包含四个邮箱地址,应用需要判断收据应该发到哪一个。为此,程序把邮件内容、问题和候选地址一起交给 Jev:
决策模型收到的输入
邮件内容(state):
发件人:jane.doe@example.com
收件人:billing@example.com
抄送:orders@example.com
回复地址:jane.personal@example.net
正文:“这次请将收据寄往我的个人邮箱,不要使用账单邮箱。”
判断问题(instructions):发件人希望把收据发到哪个邮箱?
候选项(criteria):
jane.doe@example.com
billing@example.com
orders@example.com
jane.personal@example.net
none:以上皆非。
Jev 返回的结果中包含所选邮箱,以及它对这次选择的把握程度:
决策模型返回的选择结果
所选邮箱(choice):jane.personal@example.net
置信度(confidence):0.97
其中,choice 给出了所选邮箱 jane.personal@example.net,confidence 的值 0.97 表示模型对这次选择的把握程度。决策模型在这里做的事,就是理解邮件中的要求,并从候选地址中选出符合要求的一项。
在刚刚提到的汇报场景中,QwenPaw 的聊天模型负责阅读资料、组织内容,并调用工具读写文件;决策模型负责快速判断一些具体问题,比如某项操作有没有风险、某段资料是否还需要保留。下面以 Jev 为例,看看如何配置和使用这两项功能。
02
在 QwenPaw 中配置 Jev
要在 QwenPaw 中使用 Jev,需要先配置 TypeSafe 的模型提供商信息。
配置 TypeSafe:打开「设置 → 模型」,配置并启用 TypeSafe,填入 API Key(密钥)。基础 URL 保留默认值 https://api.typesafe.ai,测试连接成功后保存配置。
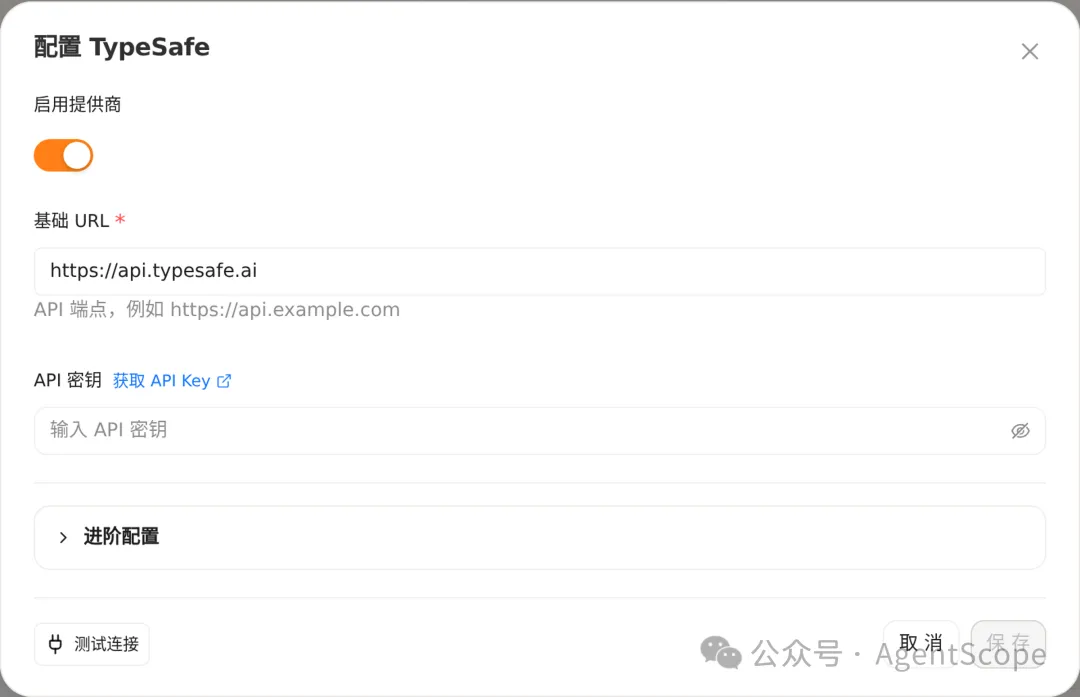
在 TypeSafe 配置窗口填写 API 密钥,并测试连接。
设置默认决策模型:回到同一页面顶部,在「默认模型 → 决策模型」中选择 TypeSafe 下的 Jev Latest(jev-latest)。
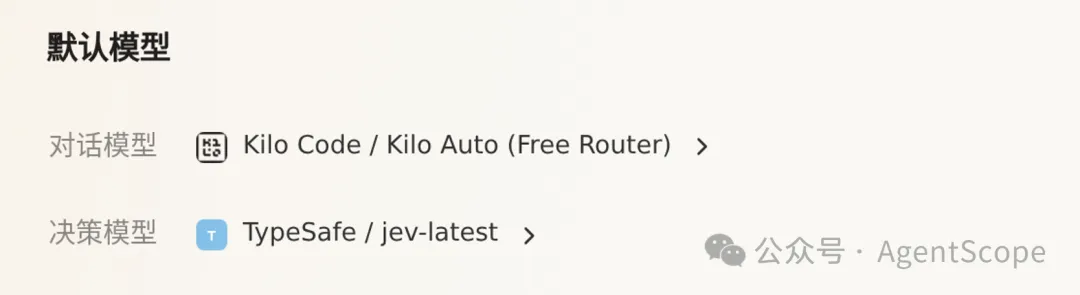
将默认决策模型设为 TypeSafe / jev-latest;对话模型可以单独选择。
选好 Jev 后,还需要分别开启工具审批和资料筛选的对应功能。
03
用决策模型进行工具审批
先设置工具审批。在「运行配置 → 执行方式」中,将「工具审批模式」设为「决策模型模式」。如果你为当前会话单独选择过审批模式,也需要将会话的审批模式切换为「决策模型模式」。
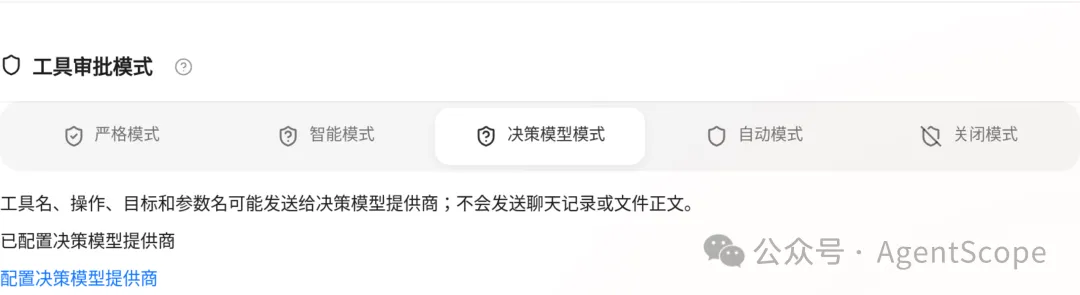
在「运行配置 → 执行方式」中选择「决策模型模式」。
Jev 评估操作风险时,QwenPaw 会向 TypeSafe 发送相关工具信息,可能包括命令、文件路径和待执行的脚本。
设置完成后,就可以开始准备汇报了。你先把会议纪要、进度记录和客户反馈交给助手,让它整理出一份草稿:
请根据这些项目资料,帮我整理一份客户汇报草稿,分成“已完成、进行中、待确认”三部分。涉及交付时间和验收要求的地方,请注明资料来源。把草稿保存为“项目汇报草稿.md”。
拿到草稿后,你想把还没确认的事项集中看一遍,可以接着问:
帮我看看这份草稿里还有哪些待确认、待补充的事项,整理出来。
对于需要风险评估的检索操作,QwenPaw 会先请 Jev 判断风险。如果 Jev 判断这项操作只读取内容,各项风险也满足放行条件,QwenPaw 就会自动执行。你可以直接查看助手整理的待办事项,无需为这次检索额外授权。
哪些操作可以自动放行
每次工具调用都要按具体操作检查风险。一次检索获准执行后,如果助手接下来要修改文件,QwenPaw 还会检查这次修改。你明确设置的审批要求和禁止执行的操作,也仍然有效。
需要 Jev 评估时,QwenPaw 会在一次请求中向它提出四个问题:
判断维度 | 具体内容 |
操作影响 | 属于只读操作、常规变更、高风险操作,还是信息不足 |
数据破坏 | 是否可能删除或覆盖已有用户数据 |
敏感信息暴露 | 是否可能读取凭据,或将敏感信息传到本机之外 |
权限变化 | 是否可能改变权限、提权或削弱安全控制 |
Jev 返回操作类别和各项风险概率,QwenPaw 据此决定是否自动放行。符合条件的低风险操作可以直接执行;如果风险较高、判断不确定,或评估服务暂时不可用,QwenPaw 会请你确认。
04
用决策模型筛选长对话资料
整理出待办之后,你继续和助手补充内容、讨论客户反馈、调整汇报重点和视觉风格。对话越来越长,先前读过的资料也在不断积累。模型每次能处理的内容有上限,QwenPaw 需要在对话过长时压缩历史内容,才能为接下来的讨论留出空间。
压缩通常会把较长的内容概括成摘要,但摘要可能省略一些细节。比如,最初读过的会议纪要里有这样一条约定:
首版于 12 月 18 日 17:00 交付,验收前需提供测试账号。
如果摘要只留下“已确认交付安排”,助手以后核对汇报时,就缺少了具体时间和测试账号这两项信息。Jev 可以在压缩前帮助筛选资料:当你正在核对交付安排时,它会判断先前读过的哪些内容与这项任务有关。QwenPaw 根据判断结果尽量保留相关内容,把暂时用不上的资料缩成短预览,例如此前讨论过的视觉风格方案。
要使用这项功能,先在「运行配置 → 上下文容量」中开启「启用上下文压缩」,再展开「决策模型压缩」,打开「启用决策模型压缩」。QwenPaw 会自动保存设置,其余参数可以先保留默认值。
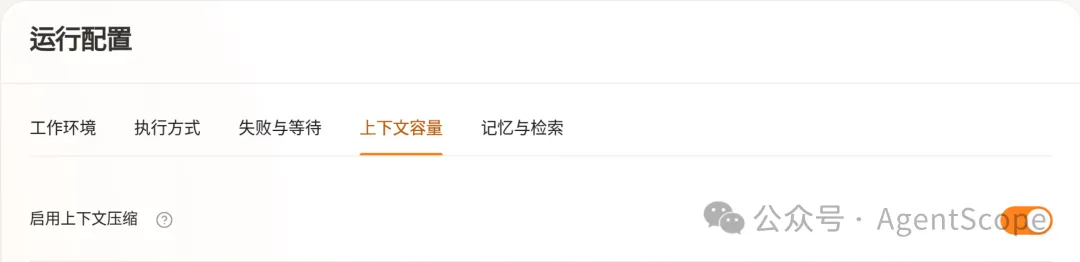
先在「运行配置 → 上下文容量」中开启「启用上下文压缩」。
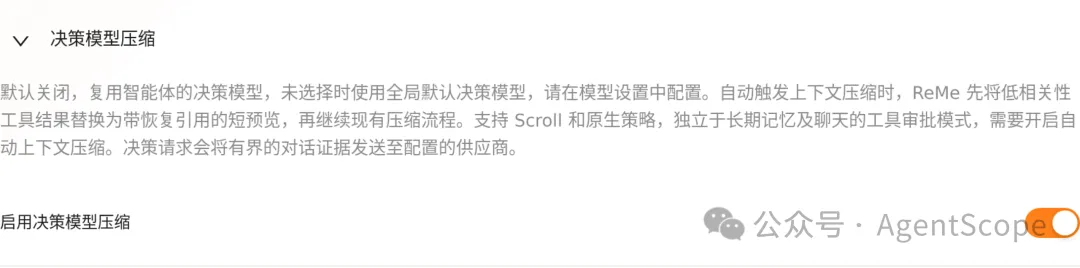
再展开「决策模型压缩」,开启「启用决策模型压缩」。
对话达到设定的压缩条件时,QwenPaw 会将相关对话片段和工具结果摘录发送至 TypeSafe,请 Jev 评估哪些内容还需要保留。
你可以照常和助手修改汇报。当你需要核对交付安排时,直接接着之前的讨论提问:
请核对汇报中的交付安排:首版什么时候交付,验收前还要准备什么?请注明依据的会议纪要。
如果压缩时保留了会议纪要中的交付约定,助手就能参考其中的时间和验收要求回答你,减少重新查找资料或请你再次补充的麻烦。
对于被精简的资料,QwenPaw 会留下短预览和查回原文的引用。以后你又想讨论视觉风格,助手仍可以通过引用找回归档保留期内的原文。如果筛选后的内容依然超过长度限制,QwenPaw 会继续执行原有的上下文压缩。
05
本地决策模型 Piccolo
前面使用的是云端 Jev。如果你希望这些辅助判断在自己的设备上完成,也可以选择本地决策模型 Piccolo。用于判断的操作信息和历史片段可以留在本机处理,减少对远端决策服务的依赖。
换成 Piccolo 后,聊天模型仍负责理解任务、组织内容和调用工具,操作风险和资料相关性则由 Piccolo 在本机判断。它的运行速度取决于设备性能、模型规格和输入长度,选择模型时需要考虑自己的设备条件。
你可以在 QwenPaw Local 中下载并启动 Piccolo,再将它设为决策模型:
下载并启动:打开「设置 → 模型」中的 QwenPaw Local,选择 Hugging Face 或 ModelScope 作为下载来源,再从「决策模型」列表中下载 Piccolo,下载完成后点击「启动」。QwenPaw 会根据设备内存显示推荐模型。你也可以在「自定义模型下载」中填写 GGUF 模型仓库 ID:选择 ModelScope 时可填写 AgentScope/Piccolo-4B-Q4_K_M,选择 Hugging Face 时可填写 agentscope-ai/Piccolo-4B-Q4_K_M。
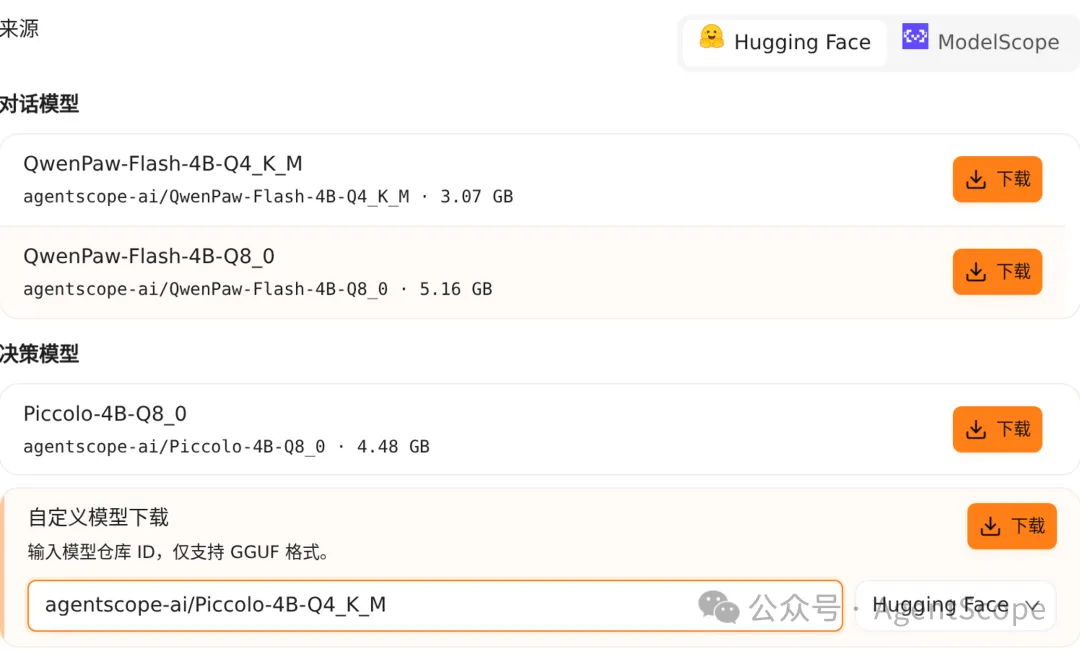
在 QwenPaw Local 中选择下载来源,再下载 Piccolo;也可以填写仓库 ID 自定义下载。推荐列表随设备配置变化。
选择 Piccolo:回到「模型 → 默认模型 → 决策模型」,确认这里选中的是刚启动的 Piccolo。如果你为当前智能体单独指定过决策模型,也需要将它改为 Piccolo。
如果你已经按前文开启了工具审批和资料筛选,切换模型后可以沿用这些设置:工具审批保持「决策模型模式」,资料筛选保持「上下文压缩」和「决策模型压缩」开启。QwenPaw Local 同时只能运行一个模型,启动 Piccolo 会替换其中原先运行的模型;对话模型可以选用其他提供商的服务。
设置好以后,你可以继续和助手整理资料、修改汇报。Jev 或 Piccolo 会在需要时参与风险评估和资料筛选,让符合条件的操作自动执行,也尽量留下后续讨论还要用到的信息。
附录:
Jev 筛选原文对记忆压缩后回答质量的影响
第四章介绍了如何用 Jev 在长对话记忆压缩时筛选资料,尽量保留后续还会用到的内容。下面这组离线实验进一步观察:在压缩后的摘要之外,补入 Jev 选出的相关原文,对回答质量有多大帮助。
我们用 14 个模拟任务做了一组离线对照实验,共评测 1,092 次回答。同一道题使用相同摘要,比较只看摘要和补入 Jev 所选原文后,回答中的关键词是否正确;再以模型能看到完整对话时的成绩作参照。
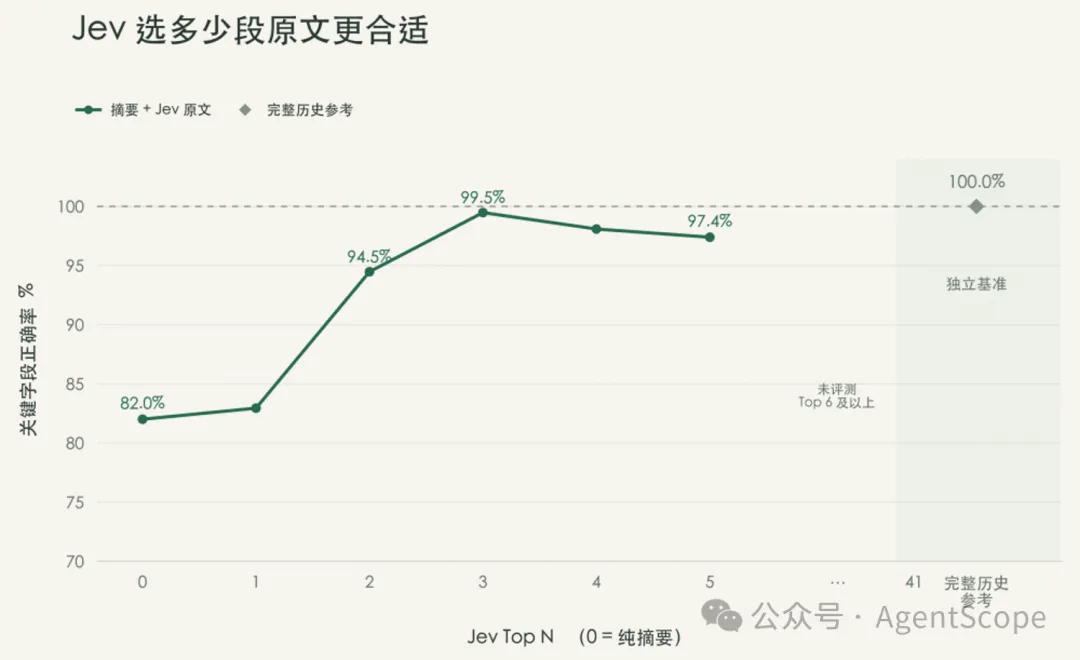
横轴表示补回的原文段数,纵轴表示关键词正确率。最右侧一栏是模型能看到完整对话时的成绩。
只看摘要时,关键词正确率为 82.0%;补入三段原文后,升至 99.5%;补入五段时为 97.4%。这组结果说明,在摘要之外补入 Jev 选出的相关原文,有助于助手继续使用之前的具体信息,回答后续问题。
三段原文的成绩高于五段,也说明补回的内容更多,并不一定更好。实际使用中,QwenPaw 按任务需要筛选工具结果,保留段数并不固定,把有限的上下文空间优先留给相关内容。
QwenPaw,和你一起进化