ARTICLE · 1325145
从软件供应链到 AI 工具链:关于 Agent 安全的原子能力的思考和探索
从应用安全到供应链安全,我们关注的对象越来越多:代码、组件、接口、构建过程、运行环境。沿着这些对象往下看,数据始终处在核心位置。
过去谈信息安全,常常先看系统和业务。随着安全建设和运营不断深入,我们开始区分场景、分析数据流、做威胁建模,再拆到具体的数据对象。颗粒度越分越细,但始终绕不开数据的生产、存储、传输、消费和销毁。
当越来越多的操作交给 Agent,保护数据的方式需要怎样变化?再往下拆,这些防护要求又该落到哪些具体能力上?
一、数据仍在中心,执行任务的角色变了
回看应用安全的发展,我想用三个关注点串起这条线:
- 漏洞扫描和运行时安全:发现可被利用的缺陷,观察运行中的异常。
- 编码安全和 API 安全:把安全要求放进开发过程,约束接口及其访问方式。
- 软件成分分析和供应链安全:进一步追问,应用依赖了什么,这些依赖从哪里来,如何进入交付过程。
这些能力不断叠加,保护范围也从一个应用延伸到支撑它的整条链路。
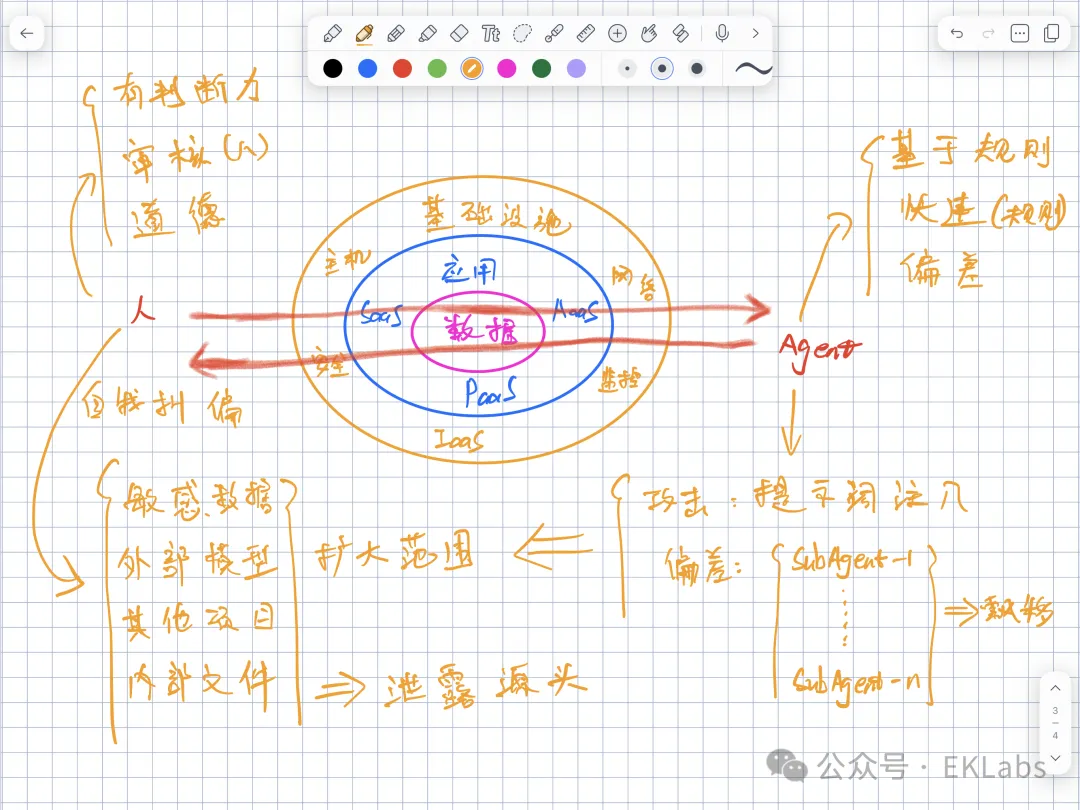
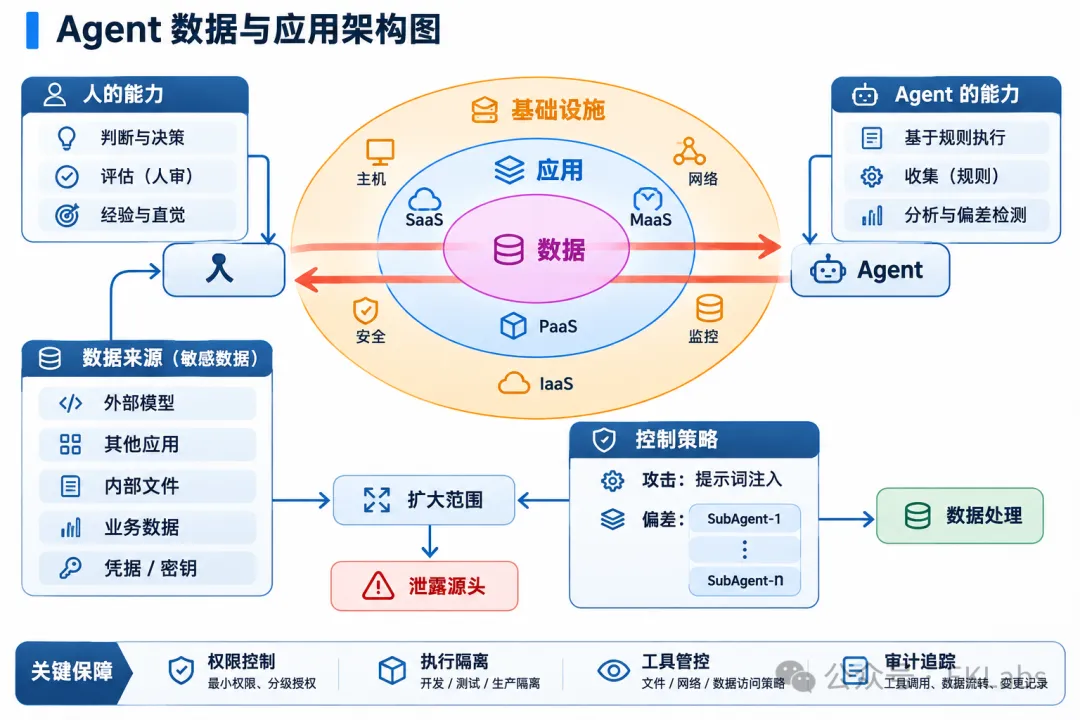
在很多传统应用场景里,是人根据业务目标选择应用、判断结果,再决定下一步。现在,Agent 开始接手其中一部分工作:读资料、选工具、拆任务、调用接口,甚至连续执行一系列操作。
人仍然负责提出目标和授予权限,但从目标到具体动作之间,多了一层 Agent 的理解与决策。安全防护也需要关注这一层。
二、Agent 进入个人电脑,安全问题也跟着进来了
Web、LLM、Agent,每一种技术出现,都会带来相应的安全需求。Agent 可以运行在个人电脑上,也可以部署在服务器或云端,还可以连接云端模型、远程工具和本地执行环境。
以桌面 Agent 为例,它可能同时接触本地文件、开发环境、浏览器、企业账号和外部服务,能做的事情包括:
读取、修改和删除文件。 执行命令、启动进程。 调用 MCP 工具、API 和第三方服务。 使用凭据访问企业系统。 浏览网页,接收外部内容。 更新长期记忆、配置和自动化任务。
文件访问、凭据使用、命令执行、网络通信、配置保护,这些熟悉的安全问题,现在都汇聚到了一个桌面 Agent 的任务过程里。
一次事件可能沿着这样的路径发生:
外部内容 → 模型理解和决策 → 工具调用 → 操作系统或外部服务执行 → 数据或环境发生变化
风险可能出现在每一环:外部数据被当成指令、工具权限过大、凭据可以反复使用,或者 Agent 能修改约束自己的配置。
三、用软件供应链的思路,继续看 AI 工具链
软件供应链安全会追问:我们信任的应用,是否引入了不可信的依赖?沿着这个思路看 Agent,也需要检查它依赖的整条 AI 工具链:
LLM API 是否被滥用,API 密钥是否被盗用。 编码助手是否被攻陷或遭到滥用。 MCP Server 是否被攻陷。 Agent 框架及其依赖是否可信。
比如,一次异常外联究竟是普通程序产生的,还是编码 Agent 通过 MCP 工具访问了某个恶意服务?使用了谁的身份和密钥?之前又读取了哪些文件?孤立地看一条网络告警,很难回答这些问题。
假设一个场景:
员工让编码 Agent 分析一个项目的构建错误。 Agent 受到提示注入,或在自主决策时发生偏差,开始读取与构建无关的大量内部文件。 它继续使用已有权限调用工具,尝试把内容发送到外部服务。
单独看,文件读取和工具调用可能都在已授予的权限范围内;连起来看,整个行为已经偏离了原始任务,还可能把内部文件带到外部。
有权限执行,不代表这次执行符合用户意图。这是 Agent 安全需要进一步处理的问题。
四、从整体架构,拆到具体的防护能力
发现一个防护点的问题,与规划企业整体的安全架构,关注的范围是不一样的。这也是老生常谈的甲方、乙方视角差异。
同样是安全架构师,乙方介绍的一套 WAF 解决方案,放到甲方的整体安全架构里,可能只是其中一个防护点。围绕这个点,还可以沿两个方向展开:
- 纵向拆解:从企业整体安全架构,到一个防护点,再细化到一条具体的 WAF 防护规则。越往下,越要说清楚检查什么、依据什么条件、执行什么动作。
- 横向扩展:同一个防护点,根据实际架构需要,可能由多个实例共同承接,也可能由不同品牌的产品分工协作。这时要看清各自覆盖的范围,以及规则、日志和处置如何衔接。
纵向拆解,帮助我们明确一个防护要求究竟落到哪里;横向扩展,则需要把这些能力放回实际环境里,检查它们如何协同。
Agent 的安全防护,也需要像供应链安全那样,既看整条链路,又能继续拆到具体能力。“Agent 安全的原子能力”,就是把防护要求细化到可以明确执行、单独检查的程度。例如,一次工具调用是否经过权限检查,一次文件读取是否超出目录范围,一次配置修改是否得到了授权。
模型受到误导时,安全边界也仍然要成立。借鉴操作系统安全,即使某个进程行为异常,系统也应限制它能接触的资源。同样,Agent 提出一个动作之后,应由独立于模型决策的机制,在执行前检查权限。模型的安全训练、工具检查、隔离和访问控制,需要共同发挥作用。
继续拆下去,就会遇到更具体的问题:所有相关执行路径是否都经过检查?能否绕过 MCP,直接通过 Shell 或浏览器完成同样的操作?Agent 能否修改自己的权限规则、工具配置或审计配置?
指令与数据如何区分、权限策略如何生成和验证、敏感信息流向哪里,也都需要落实到具体机制,并逐项检验。
五、先把任务意图与实际行为连起来
把这些能力放回任务过程中,要判断 Agent 有没有偏离用户意图,还需要一条可以追溯的证据链:
用户或所有者 → Agent → 所在主机 → 工具调用与资源访问 → 风险事件
这样,安全人员看到“某进程读取了文件”之后,才能继续追问:
这个 Agent 归谁负责,运行在哪台设备上? 用户提出了什么任务,Agent 调用了哪些工具? 访问的文件、身份、云资源和外部服务之间,有什么关系? 这些活动是否改变了对 Agent、所有者或设备风险的判断?
延展到 AgentReins(我在做的 Agent 安全观测工具)的设计思路,就是把“语义事件、工具事件、系统事件”三类事件连接起来:
- 语义事件:用户提出什么任务,Agent 声称准备做什么。Agent 声称“用户允许”,不能直接作为授权依据。
- 工具事件:调用了什么工具,传入什么参数,返回什么结果。工具返回“成功”,仍需要与目标系统的实际状态核对。
- 系统事件:操作系统观察到了哪些进程、文件或网络活动。系统看到了网络连接,也未必知道加密流量里传输了什么。
三类事件各有观察范围,需要彼此佐证。关联时,也应保留依据和缺口,区分已经确认、部分关联和无法关联的环节。
记录任务、记录工具调用、观察系统活动,这些能力可以分别建设和验证;再把它们关联起来,才能支持对整个任务过程的判断。
六、再难一步:把用户意图变成最小权限
用户可能只说一句:“帮我检查这个项目的构建问题。”
要把这句话变成可执行的权限策略,还需要明确:
可以读取哪些目录? 可以运行哪些命令? 是否可以联网或安装依赖? 是否可以修改源代码? 权限持续多久?
理想的流程是:
用户意图 → 明确的权限策略 → 独立组件执行策略
但这里有两个需要分别回答的问题:
- 策略执行是否正确:系统有没有按照规则执行?
- 策略表达是否正确:规则有没有准确表达用户的真实意图?
例如,监控器严格执行了一条“允许读取整个用户目录”的规则,但用户只想让 Agent 检查一个项目目录。执行机制可能没有出错,策略本身却已经授权过宽。
同样,允许读取内部文件,也不等于允许把文件内容发送到任意外部服务。权限策略还需要约束数据的去向。把自然语言转换成一份 JSON 规则,只是生成了规则,仍需要检查它是否符合原始任务。
所以,一条规则执行正确,只能证明这个环节按规则工作。回到整个任务,还要继续核对规则的范围,以及多个防护能力组合后的效果。
七、自动化越热闹,授权越要说清楚
短视频上总能看到一些哗众取宠的娱乐场景:
“它自己打开浏览器,帮我下载了另一个智能体,还同步了所有记忆,优化了全局配置。”
“它帮我干了这个,又自己把那个也搞定了。”
听起来挺热闹。可下载另一个 Agent、同步记忆、修改全局配置,每一件事都涉及新的信任关系、数据范围和权限变化。谁允许的?同步到哪里了?改了哪些配置?出了问题能不能查清楚?
这些都不说,只剩下一句“它自己全做完了”——你咋不说它还能帮你生孩子呢。
玩笑归玩笑,Agent 能替人做的事情越多,我们就越需要弄清楚:用户到底授权了什么,Agent 实际做了什么,系统又在哪里限制了它的行动范围。把这些问题逐个拆清楚,再检查它们能否共同支撑整个任务的安全,这也是我继续探索 Agent 安全原子能力的出发点。
讲解视频如下: