ARTICLE · 1326464
两个模型各做一个APP,谁来判断哪个更好?|产品评测专家招募
两个模型各做一个APP,谁来判断哪个更好?|产品评测专家招募
把同一句需求交给两个模型:「做一个活动报名页」。几十秒后,你得到两个网页。都能打开,都能点,看起来都挺像样,哪个更好? 一个按钮的颜色、一个表单的顺序、一句报错提示,普通人说不出所以然,但做过产品和设计的人一眼就能看出差别:哪个新用户三步之内能报上名,哪个手机上一打开就错位,哪个填错了只会弹一句「提交失败」。 这些差别,跑测试测不出来,模型自己也判断不好。所以越来越多做模型的团队,开始请产品经理和设计师来出题、打分、两两比较。 AI 想真正学会做产品,缺的正是这种判断:什么样的产品算好用,好在哪,差在哪。 Relia Lab 发起「出题人计划 · 产品评测方向」,长期招募产品和设计领域的专家,把你的判断变成评估和训练 AI 的标准。 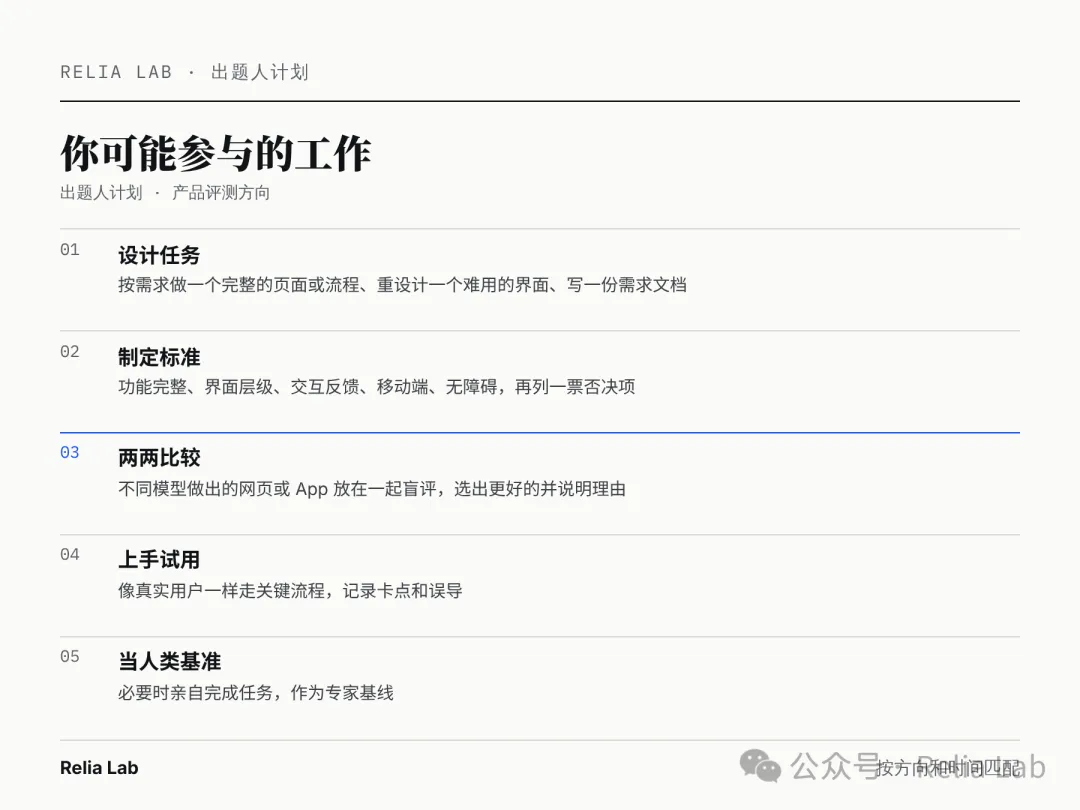
具体做哪一类,按你的方向和时间匹配。 二、我们在找谁,怎么加入? 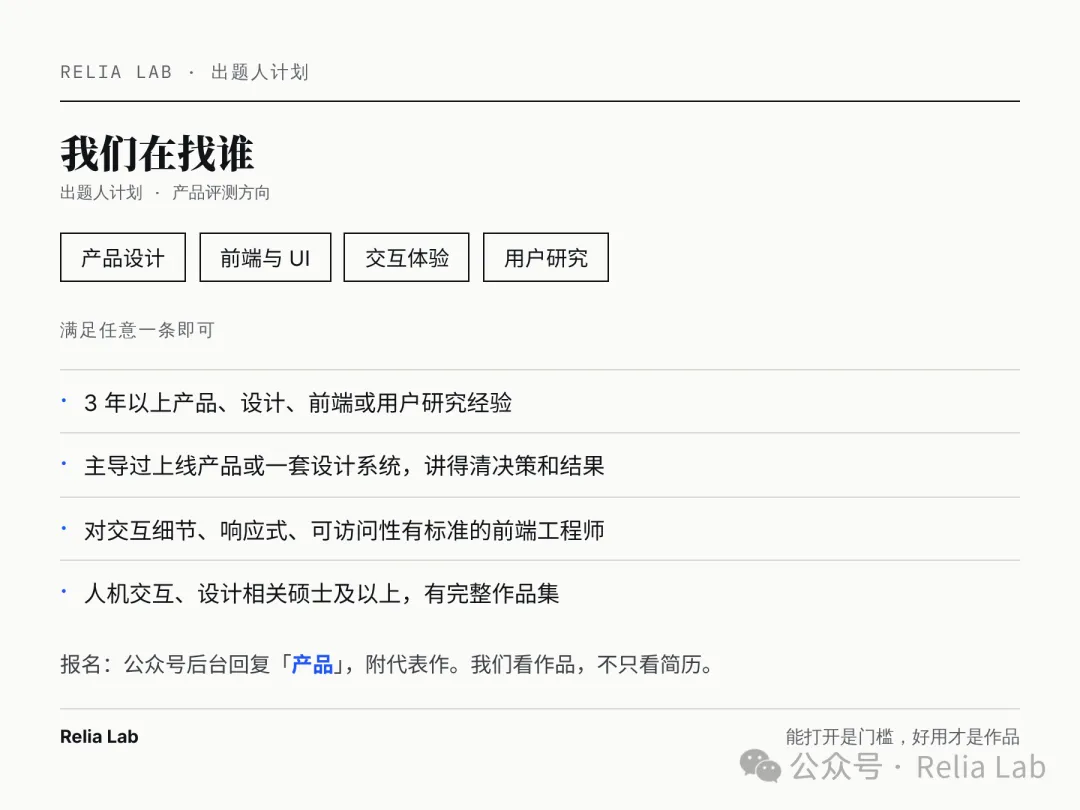
方向包括但不限于:产品设计、前端与 UI、交互体验、用户研究。 满足任意一条即可: 加分项:做过 AI 产品;熟练使用 AI 设计或编程工具;独立开发者或黑客松获奖者,作品有真实用户。 合作方式 怎么加入 Relia Lab|Benchmark and expert data for frontier AI.Relia Lab 是 Relia 的评测与专家数据实验室,我们正在招募出题人的方向: 代码评测:软件工程、系统运维、安全、Agent 开发 科研评测:理工科研究、实验设计、论文与研究想法 3D 评测:3D 生成、建模与渲染、空间理解 产品评测:产品设计、前端与 UI、交互体验、用户研究 工业评测:工业设计、制造工艺、CAD 与仿真 量化评测:因子与策略研究、回测与风险、交易系统 🙋行业专家:后台回复「出题」,了解出题人计划并报名 🏢 AI 团队:后台回复「合作」,定制 Benchmark、专家数据与RL环境
一、你可以参与的工作
设计任务:从真实工作里提炼 AI 还做不好的产品问题,比如按需求做一个完整的页面或流程、重设计一个难用的界面、写一份需求文档,写清背景、约束和交付要求。 制定标准:把「好产品」拆成一条条可检查的评分标准:功能完不完整、界面有没有层级、交互顺不顺、手机上能不能用、有没有照顾到无障碍,再列出一票否决项。 两两比较:把不同模型做出的网页、App 或方案放在一起盲评,选出更好的一个并说明理由。 上手试用:像真实用户一样走一遍关键流程,记录卡点、误导和不合理的设计。 当人类基准:必要时亲自完成任务,作为和 AI 对比的专家基线。
3 年以上产品、设计、前端或用户研究经验 主导过一款上线产品或一套设计系统,能讲清它的决策过程和结果 前端工程师,对交互细节、响应式和可访问性有自己的标准 人机交互、设计相关专业硕士及以上,有完整作品集
【远程兼职,时间灵活】 【按任务计酬,500-1000元/小时,通过质检后每周结算】 有机会提前使用和评测前沿 AI 模型,了解它们在科研任务中的能力边界
提交申请:后台回复「出题」,了解出题人计划并报名 专业评估:我们会根据你的方向安排一次简短的试做或测评 加入专家库:通过后进入 Relia 专家库,有匹配你方向的项目时,我们会优先邀请你参与