ARTICLE · 1329449
在嵌入式软件中,越来越长的if-else,什么时候该改成状态机?
很多嵌入式项目里,通信管理、设备控制这类代码,最早都只是几行 if-else,写起来顺手,读起来也清楚。过了半年,同一个函数嵌套到四五层,旁边多出七八个全局标志位,每次加需求之前,都得先花半小时搞清楚“现在到底走到哪一步了”。
这时候总有人说:该上状态机了。可什么时候该上,上了之后到底改变了什么,很多资料只讲模式本身,不讲判断依据。这篇文章我想把这件事讲得具体一点,把我在模组通信、设备控制几个项目里积累下来的判断方法,一步一步拿出来,和你交流一下。
先把我的立场放在前面:if-else 不是坏东西,状态机也不是银弹。真正的分界线不在于分支多不多,而在于“系统当前处于哪个阶段”这件事,有没有被代码明确地表达出来。
全文围绕一个贯穿示例展开:设备通过通信模组向服务器上报数据,流程里有待机、连接、传输、失败、恢复这几个阶段。我会先给出大家最常见的 if-else 写法,说清它在什么条件下是够用的;再看需求变化之后,它是怎么一步步失控的;最后给出一套可以直接带回项目的状态机骨架,以及一份自检清单。
一、先把场景说清楚
设备通过 4G 模组,把采集到的数据上报到云端。最初的需求只有一句话:有上报任务时先连接服务器,连上之后发数据,收到应答就结束,回到待机。
流程画出来很简单(图里的状态名和事件名保留英文,方便和后面的代码对应):
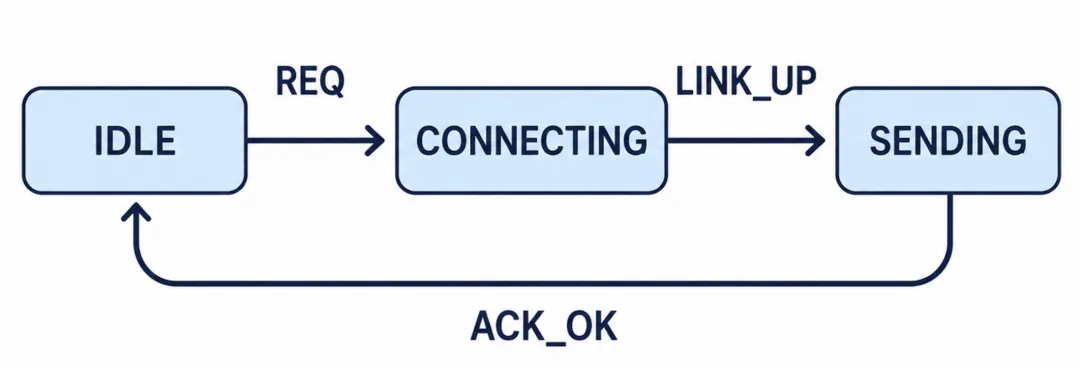
图 1:最初的需求,只有一条正常路径
三个状态,三个事件,没有分叉。
二、最直接的 if-else 写法
拿到这样的需求,大多数人的第一反应,是用两个标志位把它写出来:
static bool s_link_up; /* 链路是否已建立 */static bool s_sending; /* 数据是否已发出,正在等应答 *//* 在独立的通信任务里循环调用,connect 允许阻塞 */void comm_task_step(void){ if (!s_link_up) { if (report_pending()) { s_link_up = modem_connect(5000); /* 最多等 5 秒 */ } } else if (!s_sending) { modem_send(g_buf, g_len); s_sending = true; } else if (modem_ack_ok()) { s_sending = false; s_link_up = false; report_done(); }}这段代码我认为写得没问题,而且在这个阶段,硬要上状态机反而是过度设计。它之所以成立,是因为下面四个条件同时满足:
阶段少。两个 bool 一共四种组合,有效的只有三种,一眼就能数完。 事件来源单一。整个流程只关心“应答来了没有”,没有超时,没有断线,也没有取消。 失败不需要区分阶段。目前根本没有失败处理,所以不存在“在哪个阶段失败”这个问题。 进入和退出某个阶段时,没有额外的资源动作要做。
这里还有一个细节值得记住。s_link_up == false 且 s_sending == true 这个组合是不应该出现的。现在它不会出现,是因为代码结构刚好把它堵住了,并没有靠注释或者口头约定。这个“刚好”,我们在下一节就会看到它是怎么消失的。
下一节,我们给这段代码加上失败处理和恢复,看看会发生什么。
三、需求变了,if-else 开始长胖
这套上报流程上线之后,大概率会陆续收到下面这些追加需求:
连接最多等 5 秒,失败要重试,累计 3 次都不行就上报“连接失败”。 数据发出后 10 秒没收到应答,要重发,最多重发 2 次。 传输途中,模组主动上报“链路已关闭”,要回到连接阶段重新来过。 连续失败之后,给模组断电重启一次,等它就绪后再恢复正常流程。 上层随时可能要求取消上报,比如设备要进低功耗了。
沿着原来的写法,一条一条往里补,补完大概是这个样子:
static bool s_link_up;static bool s_sending;static bool s_failed; /* 连续失败,需要恢复 */static bool s_recovering; /* 模组正在重启 */static bool s_cancel; /* 上层请求取消 */static uint8_t s_conn_retry;static uint8_t s_send_retry;static uint32_t s_tick_start; /* 当前阶段的起始时刻 */void comm_task_step(void){ if (s_cancel) { modem_close(); s_link_up = false; s_sending = false; s_cancel = false; return; } if (s_recovering) { if (modem_ready()) { s_recovering = false; s_failed = false; s_conn_retry = 0; } else if (tick_elapsed(s_tick_start) > 8000) { modem_power_cycle(); s_tick_start = tick_now(); } return; } if (s_failed) { modem_power_cycle(); s_recovering = true; s_tick_start = tick_now(); return; } if (!s_link_up) { if (!report_pending()) { return; } if (modem_connect(5000)) { s_link_up = true; s_conn_retry = 0; } else if (++s_conn_retry >= 3) { s_failed = true; report_fail(ERR_CONNECT); } } else if (!s_sending) { modem_send(g_buf, g_len); s_sending = true; s_send_retry = 0; s_tick_start = tick_now(); } else if (modem_ack_ok()) { s_sending = false; s_link_up = false; report_done(); } else if (modem_link_closed()) { s_link_up = false; /* 链路被模组关闭,回到连接阶段 */ } else if (tick_elapsed(s_tick_start) > 10000) { if (++s_send_retry > 2) { s_failed = true; report_fail(ERR_NO_ACK); } else { modem_send(g_buf, g_len); s_tick_start = tick_now(); } }}这段代码的每一条分支单独看都说得通,也是一个认真干活的工程师顺手就会写出来的样子。问题出在把它们放在一起的时候。
四、问题是怎么暴露的
先说一种很典型的现场现象:设备偶尔会在数据发出去之后,等好几秒才真正把数据送到服务器,日志里还多出一次重发记录。这个现象不稳定,只有传输过程中链路被模组关闭时才会出现,实验室里很难复现。
把时间线拉出来看:
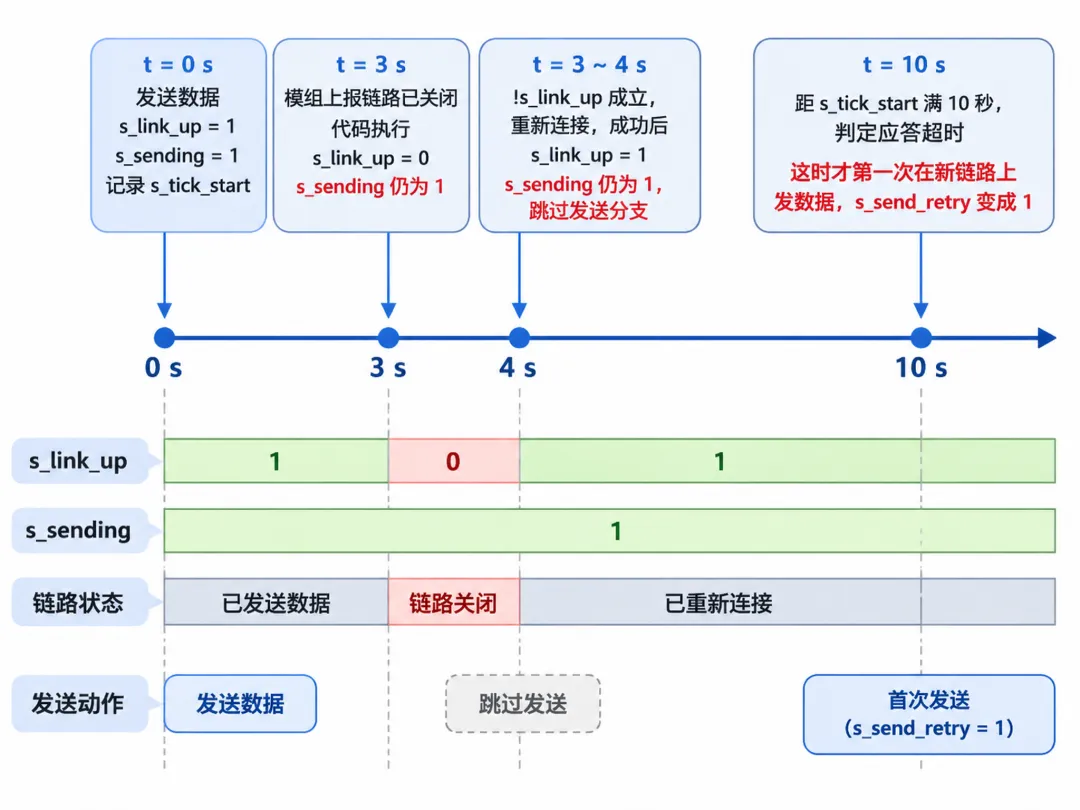
图 2:链路中途关闭时,漏清一个标志位的后果
问题就藏在 modem_link_closed() 那个分支里:它只清了 s_link_up,没有清 s_sending。于是 s_link_up == false 且 s_sending == true 这个“不应该出现”的组合,真的出现了。还记得第二节我说过,这个组合之前是被代码结构“刚好”堵住的吗?需求一加,这个“刚好”就没了。
这里我想强调一点:这不是谁粗心漏写了一行。你看这段代码的结构,“现在处于哪个阶段”这个信息,被摊在 5 个标志位、2 个计数器和 1 个时间戳里。每一种事件的处理分支,都要自己负责把这些变量一个不落地改对。事件有多少种,阶段隐含有多少种,需要保证正确的组合就有多少个,而且每一个都靠人记。
同样的问题,其实还有几处,只是现场暂时没撞上:
传输失败走到恢复阶段时, s_link_up和s_sending没有被清掉。模组重启完成之后,代码仍然认为链路在线、数据已经发出。取消放在函数最开头统一处理,它不区分当前阶段。如果取消恰好发生在模组重启的恢复阶段,这里会对一个正在重启的模组调用 modem_close()。恢复阶段到底应不应该响应取消,代码里没有任何一个地方给出答案。modem_connect(5000)是阻塞调用。取消请求如果在连接阶段到来,最长要等 5 秒才会被处理。 “失败”的处理散在连接分支和传输分支两处,各写各的。以后要加一条“失败时记录日志”,得记得改两处。
5 个 bool 理论上有 32 种组合,真正有意义的大约只有 5 到 6 种。剩下二十多种组合,没有任何一行代码在保护它们。
五、五个信号:什么时候该换状态机
回头看这个例子,再结合我在其他项目里碰到的类似情况,我自己会用下面五个信号来判断。不是说五个都要出现,我的经验是出现三个以上,就应该认真考虑换了。
信号一:标志位之间出现了依赖关系。 比如“只有 s_link_up 为真时,s_sending 才有意义”。一旦你在注释里写下这样的话,或者在代码里反复判断两个标志位的组合,就说明这几个标志位本质上在描述同一个东西:当前处于哪个阶段。
信号二:同一个事件,在不同阶段含义不同。 超时在连接阶段意味着重连,在传输阶段意味着重发,在恢复阶段意味着再重启一次。取消在待机阶段什么都不用做,在传输阶段要关链路,在恢复阶段可能得等模组重启完。事件相同,行为不同,这就是“阶段 + 事件”二维结构的典型特征。
信号三:出错之后“回到哪里”,需要靠人脑推导。 如果要回答“链路关闭之后,应该回到连接阶段还是待机阶段”,得翻三个分支的代码才能确定,说明这个知识没有被写进结构里,只存在于写代码的人脑子里。
信号四:进入或离开某个阶段时,有必须成对完成的动作。 比如进入恢复阶段要断电并启动超时计时,离开时要清失败标志和计数器。这类动作如果分散在各个分支里,早晚会漏掉一次,前面那个漏清的 s_sending 就是这么来的。
信号五:加一条新需求之前,你得先把整个函数读一遍。 而且改完以后,你说不清楚到底有多少条路径需要测。
反过来看第二节的那版代码,这五个信号一个都没出现,所以当时就不该上状态机。
我自己还有一个很朴素的判断办法:拿一张白纸,不看文档,只看代码,试着把状态转移图画出来。如果画的过程中,要不断回到代码里去查“这个标志位到底什么时候被清掉”,说明状态早已经存在于系统里了,只是还没有被代码明确地表达出来。
下一节,我们就把这 5 个标志位收拢成一个明确的状态,看看结构上具体会发生什么变化。
六、把标志位收拢成一个“状态”
前面那版代码的毛病,说到底是同一件事被拆在了好几个变量里。状态机做的第一件事,就是把它们收回来,用一个变量回答“现在处于哪个阶段”。动手写代码之前,我习惯先把五件事想清楚,每一件都对应第四节暴露出来的一类问题。
第一,哪些阶段值得做成状态。 我的判断标准是:系统在这个阶段会停下来,等某个外部事件。按这个标准,示例里有四个:
IDLE(待机):没有任务,只等新的上报请求。 CONNECTING(连接):等模组告诉我链路建好了,或者等超时。 SENDING(传输):数据已经发出,等服务器应答,或者等超时,或者等链路被关闭的通知。 RECOVERING(恢复):模组已经断电重启,等它就绪,或者等超时再重启一次。
你可能会问:前面说的“失败”呢?我没有给它单独的状态。失败发生的那一刻,系统不会停在“失败”里等什么,而是马上去做恢复,所以我把它处理成转移上的一个动作:记录失败原因,然后进入 RECOVERING。反过来,如果你的系统失败之后要停下来等人确认,那它就应该是一个独立的状态。判断是不是状态,看的是“要不要停留并等事件”,和它在业务上叫什么没有关系。
第二,有哪些事件,从哪来。 示例里一共 7 个,来源只有三处:模组驱动的回调(链路建立、链路关闭、收到应答、模组就绪)、定时器(超时)、上层接口(提交任务、取消)。
第三,守卫条件。 同一个状态收到同一个事件,去哪里要看条件。示例里有两处:CONNECTING 收到超时,要看已经连了几次;SENDING 收到超时,要看已经重发了几次。守卫条件的作用,就是在几条候选转移里选出一条。
第四,动作,以及进入动作。 转移时要做的事叫动作。有一类动作和“从哪个状态过来”无关,只要进入某个状态就必须做:进入 CONNECTING 要发起连接并启动 5 秒定时,进入 RECOVERING 要给模组断电并启动 8 秒定时。这类动作我统一放进一个 enter() 函数,第五节信号四说的“成对动作漏掉一次”,就是靠这个收拢的。
第五,状态归谁管,在哪个上下文里改。 原来的 s_cancel 由上层置位,通信任务读取,两边没有任何同步。状态机版本里,状态变量只允许通信任务一个人修改,其他上下文想影响它,只能往事件队列里投事件:
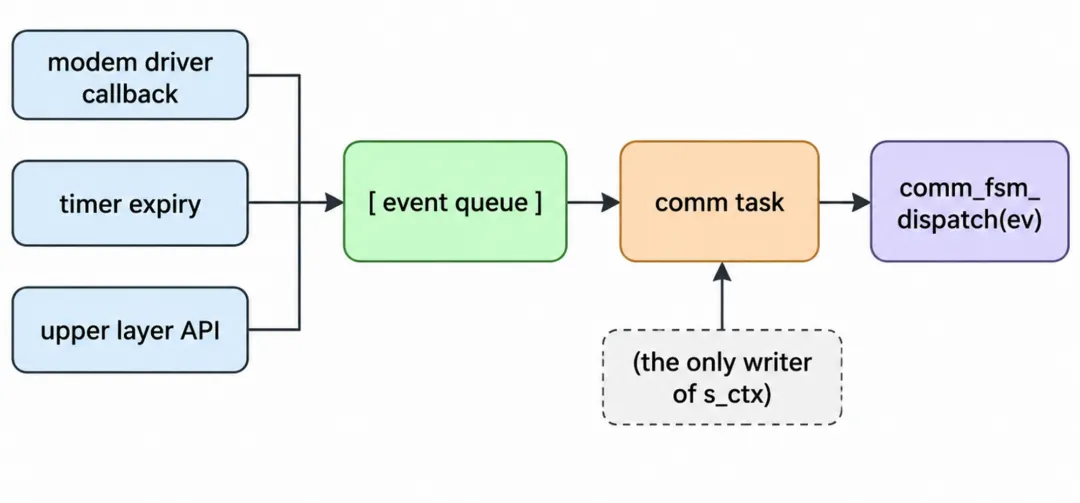
图 3:事件的来源,以及状态的唯一所有者
这样改还有一个附带的收获,是把阻塞的连接改成了非阻塞。原来的 modem_connect(5000) 会把通信任务卡住最多 5 秒,现在改成 modem_connect_async() 只负责发起,结果通过 EV_LINK_UP 或者 EV_TIMEOUT 回来。等连接的这段时间里,通信任务可以正常处理 EV_CANCEL,第四节说的“取消最长要等 5 秒”也就不存在了。
七、转移图和转移表
把上面这些信息画出来,就是图 4。为了让图看得清楚,我没有画 CONNECTING 收到 EV_CANCEL 回 IDLE 的那条线,也没有画两个状态里“超时但重试次数没用完”的自转移,这些都在后面的表里。
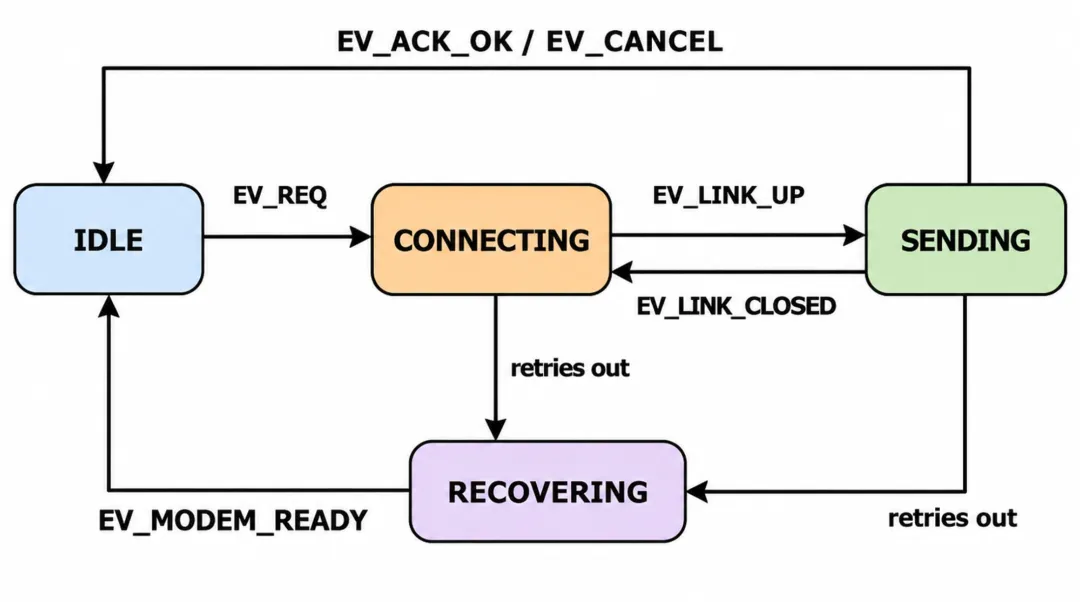
图 4:上报流程的状态转移(省略了取消和自转移)
图适合看整体走向,真正用来核对遗漏的是转移表。每一行就是一条转移:在什么状态、收到什么事件、满足什么守卫条件、做什么动作、去哪个状态。
表 1:状态转移表
数一下就会发现:4 个状态乘 7 个事件,一共 28 个组合,表里只覆盖了 11 个(有两个组合按守卫条件拆成了两行),剩下 17 个没有写。这 17 个,正是 if-else 版本里“没有任何一行代码在保护”的那一批。区别在于,现在你可以逐个过一遍,给每个组合一个明确的态度。我一般把它们分成三类:
迟到但无害的事件,显式忽略。比如 IDLE 收到 EV_LINK_CLOSED:链路本来就已经关了,没有任何事情需要做。 在这个状态下不应该出现的事件,记一条日志再丢弃。比如 CONNECTING 收到 EV_ACK_OK:数据还没发,不可能有应答。它出现了,说明别处有问题,这条日志就是线索。 需要做设计决定的事件。比如 RECOVERING 收到 EV_CANCEL:模组正在重启,这时候去关链路没有意义,我的决定是忽略,等模组就绪回到 IDLE 就行。这个问题在 if-else 版本里根本没有答案,现在表里必须写一个。
所谓合法事件和非法事件,在真实项目里就是这样一个组合一个组合分出来的。
八、核心代码
有了转移表,代码几乎是照着翻译。先是类型和上下文:
#define CONN_TRY_MAX 3#define RESEND_MAX 2#define T_CONNECT_MS 5000#define T_ACK_MS 10000#define T_RECOVER_MS 8000typedef enum { ST_IDLE, ST_CONNECTING, ST_SENDING, ST_RECOVERING} comm_state_t;typedef enum { EV_REQ, /* 上层提交了上报任务 */ EV_LINK_UP, /* 模组报告链路已建立 */ EV_LINK_CLOSED, /* 模组报告链路被关闭 */ EV_ACK_OK, /* 收到服务器应答 */ EV_MODEM_READY, /* 模组重启完成 */ EV_TIMEOUT, /* 当前状态的定时器到期 */ EV_CANCEL /* 上层要求取消 */} comm_event_t;static struct { comm_state_t state; uint8_t conn_try; /* 本轮已尝试连接的次数 */ uint8_t resend; /* 本次传输已重发的次数 */} s_ctx = { ST_IDLE, 0, 0 };然后是几个小的辅助函数。进入动作只出现在 enter() 里,失败的出口只有 fail_and_recover() 一个:
/* 进入动作:每次进入某个状态都必须做的事,只放在这里 */static void enter(comm_state_t next){ s_ctx.state = next; switch (next) { case ST_CONNECTING: modem_connect_async(); timer_start(T_CONNECT_MS); break; case ST_SENDING: s_ctx.resend = 0; modem_send(g_buf, g_len); timer_start(T_ACK_MS); break; case ST_RECOVERING: modem_power_cycle(); timer_start(T_RECOVER_MS); break; default: /* ST_IDLE */ timer_stop(); break; }}static void go_idle(void){ modem_close(); enter(ST_IDLE);}static void fail_and_recover(int err){ report_fail(err); enter(ST_RECOVERING);}static void unexpected(comm_event_t ev){ log_warn("comm: unexpected ev=%d in state=%d", ev, s_ctx.state);}最后是分发函数,每个 case 对应转移表里的几行:
void comm_fsm_dispatch(comm_event_t ev){ switch (s_ctx.state) { case ST_IDLE: switch (ev) { case EV_REQ: s_ctx.conn_try = 0; enter(ST_CONNECTING); break; case EV_LINK_CLOSED: /* 这三个是迟到的事件,状态已经离开,忽略 */ case EV_TIMEOUT: case EV_CANCEL: break; default: unexpected(ev); break; } break; case ST_CONNECTING: switch (ev) { case EV_LINK_UP: enter(ST_SENDING); break; case EV_TIMEOUT: if (++s_ctx.conn_try >= CONN_TRY_MAX) { fail_and_recover(ERR_CONNECT); } else { enter(ST_CONNECTING); /* 再连一次 */ } break; case EV_CANCEL: go_idle(); break; default: unexpected(ev); break; } break; case ST_SENDING: switch (ev) { case EV_ACK_OK: report_done(); go_idle(); break; case EV_LINK_CLOSED: s_ctx.conn_try = 0; enter(ST_CONNECTING); /* 新链路建好后,enter(ST_SENDING) 会重新发送 */ break; case EV_TIMEOUT: if (s_ctx.resend >= RESEND_MAX) { fail_and_recover(ERR_NO_ACK); } else { s_ctx.resend++; /* 同一状态内的自转移,只重发,不重置计数 */ modem_send(g_buf, g_len); timer_start(T_ACK_MS); } break; case EV_CANCEL: go_idle(); break; default: unexpected(ev); break; } break; case ST_RECOVERING: switch (ev) { case EV_MODEM_READY: enter(ST_IDLE); break; case EV_TIMEOUT: enter(ST_RECOVERING); /* 还没起来,再断电一次 */ break; case EV_CANCEL: /* 设计决定:恢复期间不响应取消 */ break; default: unexpected(ev); break; } break; }}有几处我想多说两句。
第一,我用的是嵌套 switch,没有上函数指针表。4 个状态、7 个事件的规模,switch 完全够用,读代码时每一段都能和转移表里的几行一一对上,调试时也可以直接单步。switch 本身就是一种很好的状态机实现,关键不在写法,而在状态和转移是不是明确。表驱动什么时候才值得上,下一节再讲。
第二,只有 comm_fsm_dispatch() 会修改 s_ctx,所有对外的接口都只负责投事件:
void comm_request_report(void) { event_post(EV_REQ); }void comm_cancel(void) { event_post(EV_CANCEL); }通信任务的主循环也随之变得很简单:
void comm_task(void *arg){ comm_event_t ev; for (;;) { if (event_wait(&ev)) { /* 阻塞等事件 */ comm_fsm_dispatch(ev); } }}event_post 和 event_wait 用 RTOS 自带的消息队列实现就行,我不展开。如果模组回调是在中断上下文里执行的,记得用对应的 FromISR 版本。
第三,EV_REQ 只在 IDLE 里有意义。上层在状态机忙的时候又来了新任务,任务应该留在上层自己的队列里,等状态机回到 IDLE 之后再投 EV_REQ,状态机本身不负责排队。
九、回头对照第四节的问题
把第四节列出的问题逐条拿出来,看看结构变了之后各自的下场:
漏清 s_sending 的那个问题,在结构上不可能再出现,因为根本没有 s_sending 这个变量。SENDING 收到 EV_LINK_CLOSED,转移表里写的就是回 CONNECTING,等 EV_LINK_UP 到了,enter(ST_SENDING) 会在新链路上把数据重新发一遍。原来要靠人记住“这里要清三个变量”,现在只是一个枚举值的变化。 5 个 bool 的 32 种组合,变成了 4 个枚举值,不存在“半个状态”。 取消在每个状态下的含义,表里逐个写明了。RECOVERING 里不响应,是一个明确的决定,不是碰巧。 失败只有 fail_and_recover() 一个出口,以后要在失败时多记一条日志,只改一处。 连接不再阻塞通信任务,取消不用再等 5 秒。
到这里,结构上的变化就交代完了。但还有两件事没讲:这套东西要付出什么代价,什么情况下不该用;以及怎么验证它真的比原来可靠。验证这部分里,有一个我没有写进上面代码的细节,下一节会讲到。
十、代价与边界
状态机不是白拿的,用之前要知道自己付出了什么。
RAM 和 ROM。 先说明,这个例子我没有拿编译器实测,下面是按结构估算的量级,准确数字请你用自己的工具链核对。变量本身几乎没有差别:原来是 5 个 bool、2 个 uint8_t 加 1 个 uint32_t,合起来十来个字节;现在 s_ctx 只有 3 个字段,枚举占几个字节取决于编译选项。真正多出来的 RAM 是事件队列和定时器控制块,大小取决于你用的 RTOS 和队列深度,大致是几十到一两百字节。ROM 方面,嵌套 switch 编译出来是一串比较和跳转,这个规模预计在几百字节,想知道准数,编译完看 map 文件最直接。
时延。 事件要经过队列,多了一次入队、出队和任务切换。在 Cortex-M 上这个开销通常是微秒到几十微秒,对秒级的超时没有影响。反过来,取消的响应从最长 5 秒降到了一次任务调度。但如果你的逻辑要求在几微秒内必须反应,比如电机换相,就不要放进队列驱动的状态机,那类逻辑应该在中断里直接处理。
复杂度。 代码量会变多。第二节那版只有十几行,现在加上枚举、辅助函数和分发函数,接近一百行。多出来的这些行,买到的是每个状态、每个事件都被你逐个想过一遍。另外转移表这份文档也要维护,新增一个事件,就得把所有状态过一遍,决定各自的态度。
再说几种我不建议用状态机的情况:
流程固定,顺序走完,中间不等外部事件。比如上电初始化:时钟、外设、自检,一路往下。这种写成顺序代码最清楚,拆成状态反而绕。 就是第二节那个规模:阶段少,事件单一,失败不分阶段。标志位足够,别为了“架构好看”硬上。 你要解决的其实是并发问题。状态机管的是一条流程里的“阶段”,两个任务抢同一个资源,状态机救不了。
还有两种情况,是已经在用状态机、但开始吃力了。
状态数涨到 8 到 10 个以上。 或者好几个实例要共用同一套逻辑,或者你想从表直接生成文档和测试用例,这时候值得把 switch 换成表驱动。每一行是一条转移:
typedef struct { comm_state_t from; comm_event_t ev; bool (*guard)(void); /* 可为 NULL,表示无条件 */ void (*action)(void); comm_state_t to;} trans_t;引擎只负责按表查找,业务都在 guard 和 action 里。好处是表本身可以被检查、被统计、被导出;代价是调试时要多跳一层函数指针,规模小的时候不划算。
状态数在成倍增长。 比如“通信阶段”乘以“低功耗模式”再乘以“是否有升级任务”。这说明几个互相独立的维度被塞进了同一台机器。把它们拆成两三个小状态机,用事件互相通知,每台的状态数是相加的,不再是相乘。
最后提醒一点:状态机只负责收拢“阶段”。如果你发现某个状态内部又长出了一堆新的标志位,说明这个状态还应该再拆,不然只是把 if-else 换了个壳。
代价和边界讲完了,下面讲验证。前面留的那个细节,也在这一节里。
十一、怎么验证
我把验证分成三层,每一层能证明什么、证明不了什么,要分清楚:
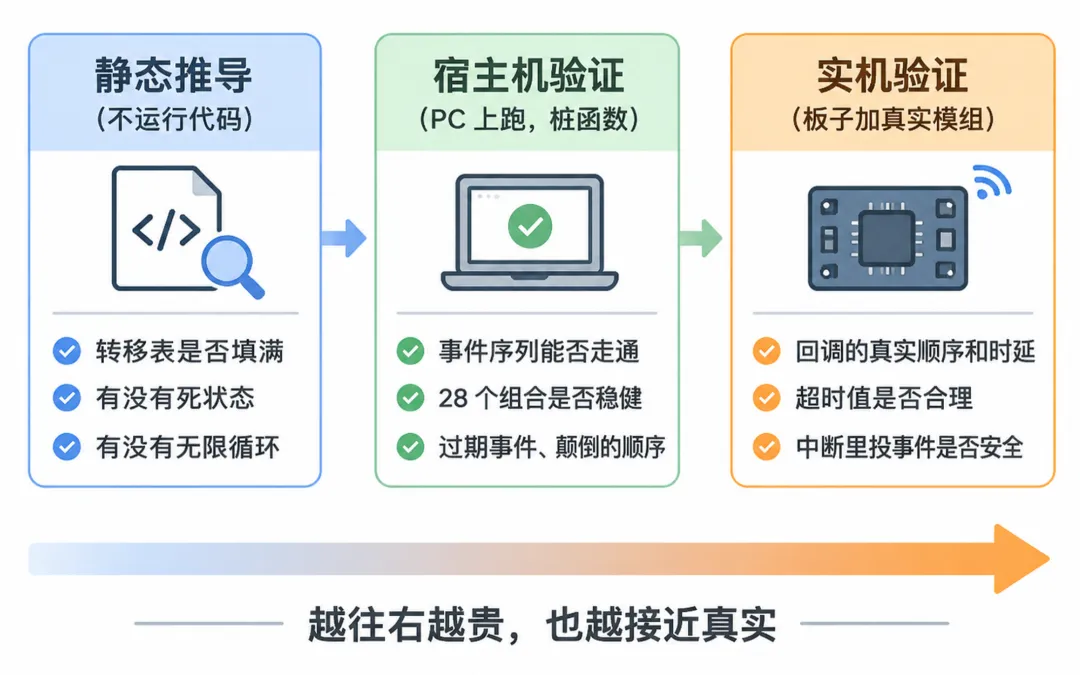
图 5:三层验证各自管什么
第一层,静态推导。 不运行代码,只对着转移表问三件事:28 个组合是不是每一个都有态度(执行、忽略、记日志,三选一);每个状态是不是都有出路;有没有绕不出去的圈。
按这个办法把第七节那张表过一遍,就能发现一个问题:RECOVERING 收到 EV_TIMEOUT,会一直再次断电重启。模组要是真的坏了,设备会永远困在这里。表上每一行单独看都合理,合起来却有一个没有出口的圈。实际项目里,这里要加一个重启次数上限,超限以后不再自己折腾,通知上层,由上层决定是整机复位还是进入故障模式。这种问题看代码很难发现,对着表一行一行问“然后呢”,很快就能看出来。
第二层,宿主机验证。 comm_fsm_dispatch 只依赖 modem_、timer_、report_* 这几组函数。在 PC 上用桩函数把它们换掉,就可以直接往里灌事件序列,再检查状态和桩函数的调用记录。我一般测四类:
正常流程:EV_REQ、EV_LINK_UP、EV_ACK_OK,最后回到 IDLE,report_done 只调用一次。 异常流程:连接连续超时 3 次,进入 RECOVERING,report_fail(ERR_CONNECT) 调用一次。传输阶段是一次首发加两次重发,第三次超时才算失败,一共发送 3 次。这类数字最容易差一,写成测试以后一眼就能核对。 极端顺序:SENDING 里 EV_LINK_CLOSED 后面紧跟 EV_CANCEL;EV_ACK_OK 和 EV_TIMEOUT 同时到,两种先后顺序都要测;RECOVERING 期间上层又投来 EV_REQ。 资源回收:每条路径回到 IDLE 之后,桩里记录的链路是不是都关了,定时器是不是都停了。
再加一个很便宜、但很有用的测试:把 28 个组合全部灌一遍。枚举末尾加上 ST_COUNT 和 EV_COUNT,用 #ifdef 只在测试版本里暴露一个强制设置状态的函数:
for (int s = 0; s < ST_COUNT; s++) { for (int e = 0; e < EV_COUNT; e++) { test_force_state((comm_state_t)s); comm_fsm_dispatch((comm_event_t)e); assert(test_get_state() < ST_COUNT); }}这个测试不判断逻辑对不对,只保证任何组合下都不会跑到非法状态。显式的状态才能这么测,if-else 加标志位的版本想这么测,得先去枚举 32 种标志位组合。
极端顺序里有一个情况,第八节的代码我没有处理,放在这里讲,因为它只有刻意构造事件顺序才会暴露。场景是:连接定时器到期的同时,模组的 EV_LINK_UP 也到了,两个事件都进了队列,LINK_UP 排在前面。
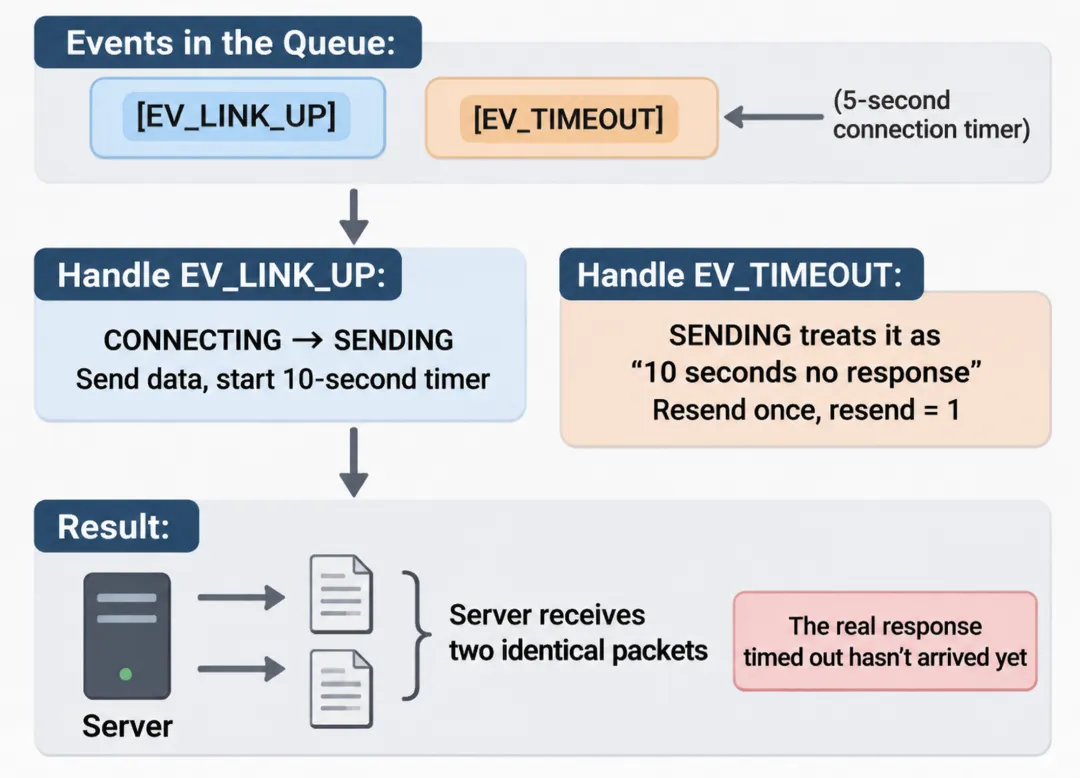
图 6:队列里留下的过期超时事件
问题在于,timer_stop() 和重新 timer_start() 只能管住以后,管不住已经躺在队列里的超时事件。转移表没错,代码逻辑也没错,错的是事件在队列里的时间差。我的做法是给定时器加一个代数号:每次启动或停止定时器,代数号加一;定时器到期时,把启动时的代数号随 EV_TIMEOUT 一起投出;任务取事件时,发现代数号和当前的不一致,直接丢弃。
typedef struct { comm_event_t id; uint8_t gen; /* 只对 EV_TIMEOUT 有意义 */} comm_msg_t;static uint8_t s_timer_gen; /* timer_start 和 timer_stop 里各加一次 */void comm_task(void *arg){ comm_msg_t msg; for (;;) { if (!event_wait(&msg)) { continue; } if (msg.id == EV_TIMEOUT && msg.gen != s_timer_gen) { continue; /* 上一个定时器留下的过期超时,丢弃 */ } comm_fsm_dispatch(msg.id); }}如果你的队列接口支持,也可以在 timer_stop 和 timer_start 时直接把队列里已有的 EV_TIMEOUT 清掉,效果一样,只是要看具体的 RTOS 能不能做到。这类问题静态推导看不出来,所以极端顺序一定要在宿主机上测。
第三层,实机验证。 前两层证明的是“你的逻辑自洽”,证明不了“逻辑和真实模组对得上”。必须上板子看的有这几样:
模组真实的回调顺序和时延。比如链路关闭通知和最后一包应答,谁先到,间隔多少。桩函数里你假设的是一种顺序,真实模组不一定这样。 超时值是否合理。8 秒够不够模组重启完成,5 秒连接在弱信号场景够不够,只能量出来。 中断上下文投事件。回调如果在中断里,要用 FromISR 版本;队列满了怎么办。这些在宿主机上测不出来。 故障注入。拔天线,中途断掉服务器,让网络侧把链路踢掉,每一种都看日志里的转移序列和你预期的是否一致。
现场定位上还有一个顺手的收益:在 dispatch 入口打一行日志,记录“旧状态、事件、新状态”。现场出了问题,拿到这几行,就能把事件序列原样灌回宿主机的测试里复现。if-else 版本想做同样的事,得先决定打印哪几个标志位。
最后交代一句:这篇文章里的示例代码是为了把结构讲清楚写的,没有对着具体的模组驱动在板子上跑过。第一层我对着转移表过了一遍,第二层和第三层需要你在自己的项目里补上。
十二、带回项目的检查清单
回到你自己的代码里,我建议先问这五个问题:
能不能用一个变量,一句话说出“系统现在处于哪个阶段”?如果要靠几个标志位的组合才能说清,状态就是被摊开了。 同一个事件(超时、取消、断线),在不同阶段的处理是不是不一样?不一样,就是“阶段加事件”的结构。 每个阶段进入和离开时,有没有必须成对做的动作?有,就收拢到进入函数里。 谁能改状态?除了一个任务以外,别的上下文是不是只能投事件? 状态和事件的组合里,空着的格子,你有没有给过态度?
如果这五个问题里有三个以上,你回答得不踏实,就该认真考虑换状态机了。如果一个都没有,那就继续用你的 if-else,它没有问题。
写在最后
状态机这一个点,到这里算是讲完了。回头看,这篇文章里其实还埋着几个没有展开的话题:第六节里“事件从哪来、状态归谁改”,是事件驱动和任务模型的问题;report_fail 里那个错误码,背后是日志和故障码该怎么设计;模组驱动和上层业务之间那层接口,是协议和业务怎么解耦。
这些我整理进了新出的合集《嵌入式软件架构实战合集》里。内容从软件分层、模块边界、接口设计,到状态机、事件驱动、RTOS 任务模型,再到日志与故障码、工程结构,最后落到真实项目的重构案例,基本是顺着一个项目逐步演进的路径往下讲。如果你已经有几年开发经验,正好碰到代码越写越乱、模块互相牵扯、现场问题难以定位这类困扰,可以去翻一翻。
如果你的项目里正好有一段越堆越长的 if-else,欢迎在评论区说说它长什么样,我们一起看看是不是该换了。
往期推荐