ARTICLE · 1336938
别再把所有文档塞进一个知识库了:RAG 准确率就是这么被拖垮的
别再把所有文档塞进一个知识库了:RAG 准确率就是这么被拖垮的
「每块业务一个库」还是「所有数据一个库」?这个问题看似是二选一,其实问错了方向。分库是原则,但真正的判断标准只有两个:你的检索边界在哪里,权限边界在哪里。把不同业务的数据全塞进一个大库,在 RAG 里几乎是被实践反复验证过的反模式。 01 为什么「一个大库」是陷阱 文档量一上来,单库检索的噪声会直接淹没准确率。有实践者总结得很直白:「文档数量上去检索准确度就会下来……10W+ 只放在一个库中效果肯定不好的,检索的噪声太多了。」 RAGFlow 的实战指南也强烈建议「一个部门一个库」「一个业务类型一个库」,而不是把所有文档倒进一个大杂烩:除了让检索范围可控,不同业务还能各自适配差异化的解析策略与权限管理。 更底层的原因在于隔离本身。在 RAGFlow 里,每个知识库拥有完全独立的索引和检索范围,内容不应跨库被检索到。一个知识库封装了自己的解析器配置、语言设置、权限与搜索索引,本质上就是一个隔离的检索容器。把业务混在一起,等于主动放弃这层隔离,让一次本该精准的检索,被迫在满是无关文本的语义空间里做匹配。 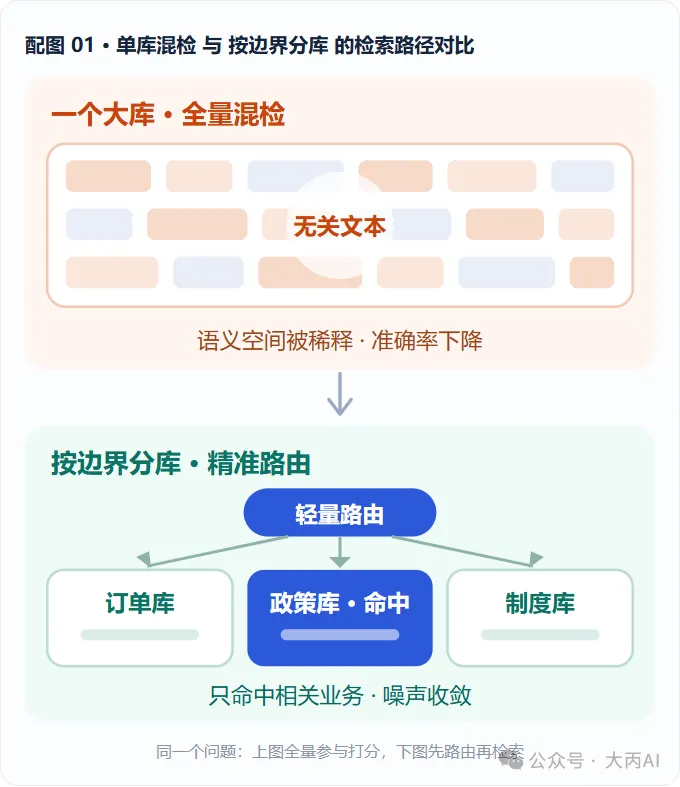
02 分库的粒度:按什么维度切 「每块业务一个库」方向没错,难的是把「每块业务」定义清楚。常见的切分维度有三层,可以叠加使用。 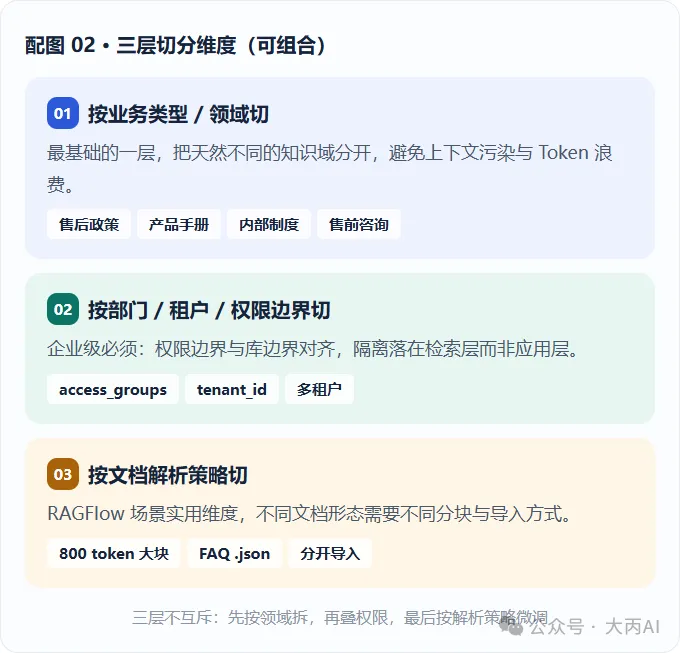
第一层 · 按业务类型 / 领域切(最基础) 售后政策、产品手册、内部制度、售前咨询,本就是天然不同的知识域。OpenClaw 的精细化分库正是这个思路:orders_db(订单)、returns_db(退货政策)、profile_db(用户信息)各自维护独立索引,查询时先用轻量分类器判断输入属于哪个库,只从相关分库取内容,而不是全库扫描。这一步直接避免了「问订单状态,却被塞进退货条款」的上下文污染和 Token 浪费。 第二层 · 按部门 / 租户 / 权限边界切(企业级必须) 只要未来要服务多个客户,或者企业内部不同部门的知识有访问限制,权限边界就必须和知识库边界对齐。Hermes 的做法是在 config/rag.yml 里为每个 collection 指定 access_groups:internal-docs 只允许 group:tech 和 group:hr 访问,customer-support 对全员开放,未配置的 group 默认无权查询任何知识库。RAGFlow 的多租户架构同样把 tenant_id 作为所有用户资源的强制外键,在检索层自动执行租户边界。 反过来看更清楚:如果知识混在一个库里,权限隔离就只能依赖应用层的「过滤条件」——一旦漏写,就是数据泄露。 第三层 · 按文档解析策略切(RAGFlow 场景的实用维度) RAGFlow 的强项是深度文档解析,但不同文档类型需要不同的分块策略。企业制度类适合较大的块(如 800 token)以保留上下文;FAQ 类结构化问答对,则需要完全不同的切分与导入方式。Hermes 的实践也印证了这点:internal 放产品手册、技术白皮书等原始文档,faq 只放 .json 格式的结构化问答对,两者分开建库、分开导入。混在一个库里,你只能选一套分块参数,必然有一类文档的解析质量被牺牲。 把三层放在一起看:业务领域层依据「知识域是否天然不同」,用 orders_db / returns_db / profile_db 加轻量分类器实现,解决上下文污染和 Token 浪费;权限边界层依据「谁能看、属于哪个租户」,用 access_groups 和 tenant_id 强制外键实现,解决越权访问与数据泄露;解析策略层依据「文档形态与分块参数」,把大块制度文档和 .json 结构化 FAQ 分开建库,解决解析质量被单一参数拖累。 03 什么时候可以「合并」 分库不是越细越好。拆得过细会推高路由成本:每次查询都要先判断「该查哪个库」,判断错了,就等于没查到。 实务里更稳的做法是先分后合:初期按业务类型和权限边界拆出必要隔离,再用真实测试问题观察各库的命中差异,最后决定哪些可以合并。 一个务实的收敛信号:如果两个业务的知识,在超过 80% 的真实用户问题里不会被同时需要,就不该合并。反过来,若「售前咨询」和「产品手册」几乎总是结伴出现,强行拆开只会让 Agent 在多个库之间反复跳转。 好消息是,这不是一次性决策。RAGFlow 支持在对话应用里按需挂载多个知识库,你完全不必在「一个库」和「十个库」之间当场押注,而可以在应用层灵活组合。 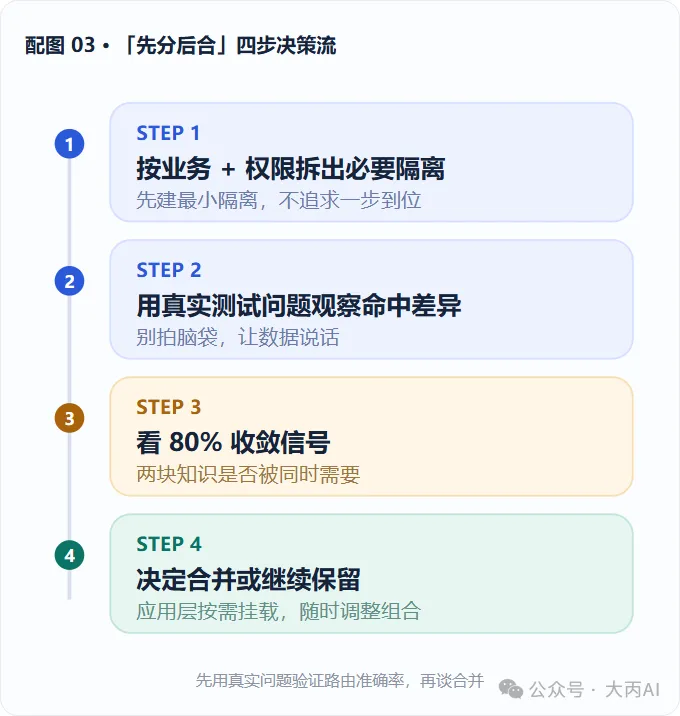
04 落到你的微信客服场景 起步阶段,至少拆两个库:customer-support,面向外部客户的 FAQ、售后政策、产品说明;internal-docs,放内部制度、操作规范、后台流程(若客服 Agent 需要查询)。这两者的受众权限和知识性质截然不同,混在一起是明确的安全与准确率双重风险。 但别一路拆到「每条产品线一个库」的原子级别。如果有多条产品线,先看它们共享的知识占比:售后政策若是统一的,产品差异只体现在规格参数上,那就先用一个 customer-support 承载共享政策,产品参数作为独立文档集放在同库内,用元数据(如 product_line)打标签区分。RAGFlow 和 OpenClaw 都支持检索时结合元数据过滤,这比拆成多个物理库的路由成本低得多。 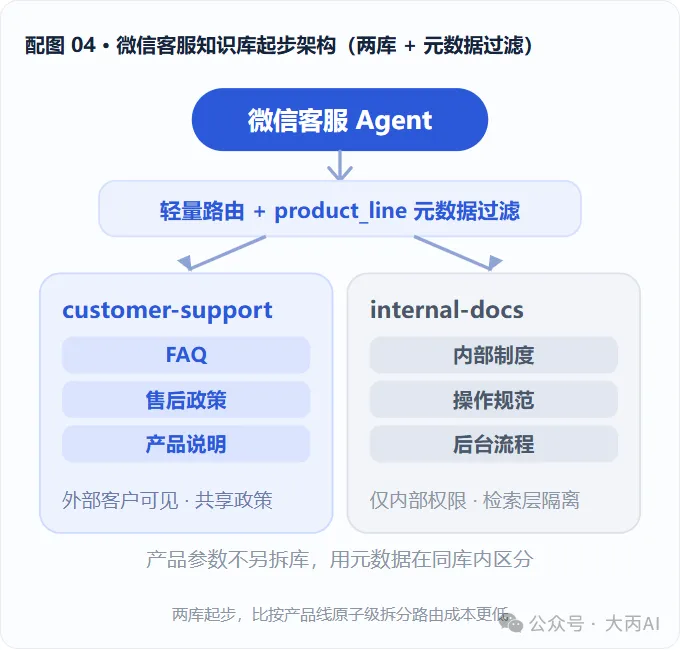
一个容易踩的坑:OpenClaw 的并行融合 OpenClaw 的默认检索是并行融合模式——本地知识库、通用知识、网络检索同时工作,结果进入同一个排序池。这意味着把所有业务塞进一个本地库,融合排序会把所有业务的内容一起拉进来打分,噪声问题比独立检索更突出。利用它的路径敏感特性做分库,再配合一层轻量路由,是在 OpenClaw 上实现「只查相关业务」的关键手段。 一句话收束 企业知识库的库边界,应该跟着权限边界和解析策略边界走,而不是跟着「文档放在哪个文件夹」走。 先按业务类型和权限拆出最小的必要隔离,用真实问题验证路由准确率,再决定哪些库可以合并。一上来就图「一个大库好管理」,代价迟早会在检索准确率和数据安全上,以更高的成本还回来。 注:本文为方法论整理,文中引用的配置项、参数与实践者观点,发布前请以各项目当前版本官方文档为准;涉及内部制度与客户数据的示例均已做泛化处理。