ARTICLE · 1341996
企业知识库 RAG 如何建设?从文档导入到 AI 智能问答,一张图讲清楚
企业知识库 RAG 如何建设?从文档导入到 AI 智能问答,一张图讲清楚让 AI 不只是会聊天,还能真正读懂企业内部的制度、流程、业务文档和专业知识。 现在很多企业都在使用大模型。 但当你问它: 大模型可能会给出一个看似合理、实际上并不符合企业规定的答案。 为什么? 因为通用大模型虽然掌握了大量公开知识,但它并不了解企业内部最新的制度、流程和业务资料。 那么,如何让大模型真正了解企业? 一个重要的技术方案就是:RAG 企业知识库。 今天,我们通过一张图,讲清楚企业知识库 RAG 是什么、如何建设,以及如何实现 AI 智能问答。 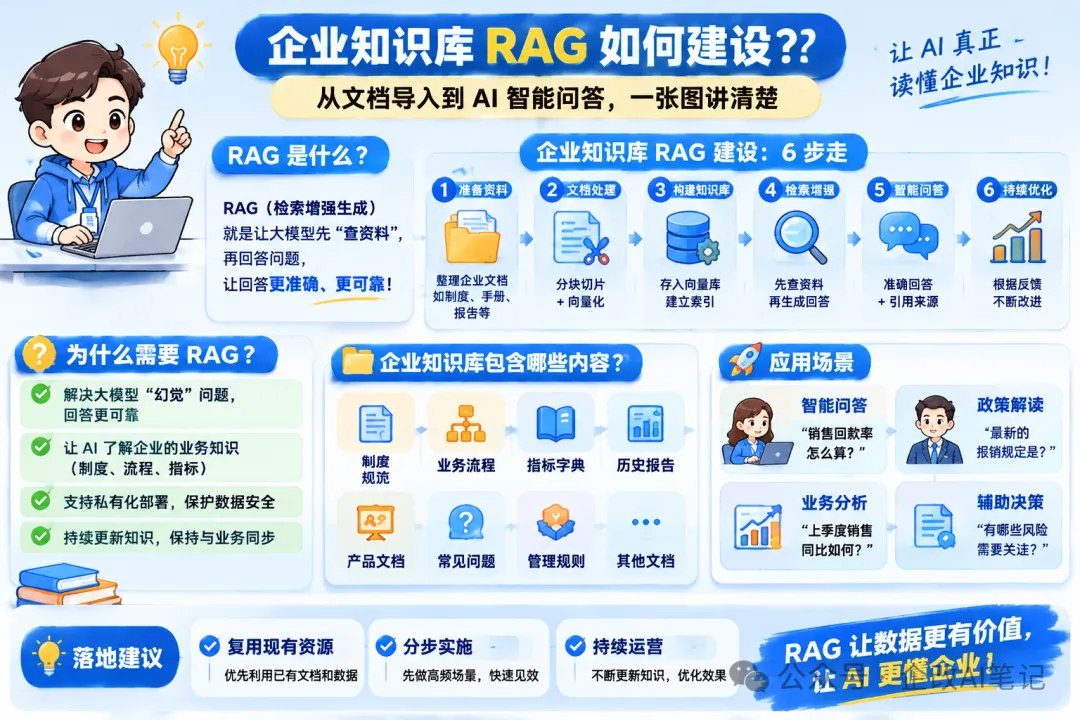
RAG,全称 Retrieval-Augmented Generation,中文叫作检索增强生成。 简单理解: 先让 AI 从企业自己的知识库中查找资料,再结合查到的资料回答问题。 可以把它理解为: 传统大模型:凭借训练时学到的知识回答问题。 RAG 大模型:先查阅企业内部资料,再结合资料回答问题。 举个例子: 员工提问: “公司员工出差住宿标准是多少?” 普通大模型可能根据通用经验回答,但不一定符合企业规定。 接入 RAG 后: 这样,回答就有了企业内部知识作为依据。 RAG 的核心价值:让大模型从通用知识问答,升级为能够使用企业内部知识的智能助手。 需要注意,RAG 并不能彻底消除大模型幻觉,但能够通过检索真实资料、提供引用来源和约束回答范围,提高答案的可靠性。 RAG 可以分成两个阶段: 知识入库:提前把企业资料整理好,让 AI 能够检索。 知识问答:用户提问时,先检索相关资料,再生成答案。 这是知识库建设的基础。 第一步:准备企业资料 收集企业内部已有的知识资源: 需要注意,知识入库之前应先清理过期文件、重复文档和错误内容,并明确资料的归属部门、版本和访问权限。 第二步:文档解析 不同格式的文件需要采用不同的解析方式。 例如: 目标是把不同格式的文件转换成系统能够处理的内容。 第三步:文本分块 Chunk 为什么要分块? 假设一本企业管理制度有 100 页,不能简单地把整本文件一次性塞给大模型。 需要根据标题、段落和语义,将文档切分成适当大小的知识片段。 例如: 分块时要尽量保留上下文、标题和章节关系,避免把一个完整的规则切成无法理解的碎片。 第四步:向量化 Embedding 把文本片段转换成计算机能够进行语义比较的向量。 这样,用户即使没有使用文档中的原始关键词,也可以通过相近的语义找到相关内容。 例如: 文档写的是“差旅住宿标准”。 用户提问的是“出差住酒店可以报销多少钱?” 两种表达不同,但语义接近,系统有机会检索到对应内容。 第五步:存储与建立索引 将处理后的知识片段、向量和相关元数据存入知识库。 可以使用: 实际项目中,可以采用关键词检索与向量检索相结合的混合检索方式。 至此,企业知识库就具备了被 AI 检索的基础能力。 知识入库完成后,用户就可以开始提问。 第六步:用户提问 例如: “公司员工出差住宿标准是多少?” 第七步:检索相关知识 系统将问题转换为检索条件,到知识库中查找相关内容。 可以采用: 通过多种检索方式,提高相关知识片段的召回质量。 第八步:大模型生成答案 将用户问题和检索到的企业资料一起交给大模型。 大模型结合资料组织语言,生成回答。 如果资料不足,应明确告知用户,而不是随意补充答案。 第九步:返回答案与引用来源 最终向用户展示: 问题的回答。 相关制度或文档名称。 对应章节或页码。 原文引用。 必要时提供原文件链接。 这样用户不仅知道答案,还可以找到答案的出处。 如果从技术架构角度来看,可以分为六个模块。 1. 知识来源层 企业 Word、PDF、Excel、PPT、制度文件、业务文档、项目资料等。 2. 文档处理层 文档解析、OCR、文本清洗、分块、元数据提取。 3. 知识存储层 Embedding 向量化、向量数据库、关键词索引、文档存储。 4. 检索增强层 问题理解、向量检索、关键词检索、混合检索、Rerank 重排序。 5. 大模型应用层 LLM 大模型、Prompt 提示词、上下文组装、答案生成、引用来源。 6. 业务应用层 企业智能问答、制度查询、业务助手、项目知识库、技术知识库。 整体链路: 企业文档 → 文档解析 → 文本分块 → 向量化 → 知识库存储 → 检索召回 → 大模型生成 → 返回答案。 RAG 不只是一个技术概念,在企业内部有很多实际应用。 场景一:企业制度智能问答 员工不需要翻阅几十份制度文件,直接询问: “员工请假需要经过哪些审批?” AI 根据企业制度回答,并提供对应文件来源。 场景二:企业业务知识助手 业务人员可以查询业务流程、操作规范、产品资料和工作手册。 降低新人培训和日常咨询成本。 场景三:项目管理知识库 将项目需求文档、实施方案、会议纪要、验收材料等统一纳入知识库。 项目人员可以快速查询历史项目经验、实施规范和交付要求。 场景四:研发技术知识库 将技术规范、接口文档、数据库设计、系统部署手册、故障处理记录等接入知识库。 研发人员可以通过自然语言查询系统架构、接口说明和历史问题解决方案。 RAG 看起来只是把文档放进知识库,但真正落地时,需要关注以下问题。 问题一:文档质量差,AI 检索不到正确内容。 解决思路:做好文档清洗、版本管理、重复内容处理和知识分类。 问题二:文本分块不合理,知识内容不完整。 解决思路:结合文档结构、标题、段落和语义进行分块,保留必要的上下文信息。 问题三:检索结果不准确。 解决思路:采用混合检索、Rerank 重排序,并持续优化检索参数。 问题四:AI 回答看似正确,却没有依据。 解决思路:要求答案基于检索内容生成,提供引用来源;检索不到时明确说明,不允许随意编造。 问题五:企业知识涉及数据安全。 解决思路:按照部门、岗位和用户身份控制知识访问权限,检索阶段就进行权限过滤,而不是仅在最终回答时进行判断。 不要一上来就把企业所有文件全部导入。 建议分四个阶段: 第一阶段:选定业务场景 例如,先从企业制度问答、项目管理知识库或研发技术知识库入手。 第二阶段:整理知识资料 选择 100~500 份高质量文档作为初始语料,具体数量根据文档质量和复杂度调整。 第三阶段:搭建 RAG 原型 完成文档解析、分块、向量化、知识检索和大模型问答。 第四阶段:测试和持续优化 准备一批真实业务问题,测试检索准确性、答案正确性、引用完整性和响应时间,根据反馈持续调整。 建议优先关注: 不要只看 AI 能不能回答问题,更要看它能不能根据企业真实资料回答正确的问题。 过去,企业有大量制度文件、业务文档、项目资料和技术规范。 这些知识分散在不同部门、不同系统和不同人员手中。 员工需要什么知识,就要自己搜索、翻阅文档,甚至找同事询问。 进入 AI 时代,企业可以通过 RAG 技术,把这些分散的知识整理成可检索、可管理、可持续更新的企业知识资产。 大模型负责理解和生成,RAG 负责检索企业知识,知识库负责沉淀企业经验,最终让 AI 真正服务于企业业务。 如果说 Text2SQL 解决的是“如何让 AI 查询企业结构化数据”,那么 RAG 解决的就是“如何让 AI 理解企业非结构化知识”。 两者结合,企业才能逐步构建真正懂数据、懂业务、懂知识的 AI 助手。 下一篇,我们继续聊: 《AI Agent 如何连接企业数据?从工具调用到自动执行业务任务,一张图讲清楚》 #企业知识库#RAG#AI大模型#人工智能#企业数字化转型#知识管理#向量数据库#LangChain#Dify#AI落地
我们公司的最新报销制度是什么? 某个业务流程需要经过哪些审批? 项目验收需要准备哪些材料? 公司某项指标的具体计算口径是什么?
一、什么是 RAG?为什么企业需要建设知识库?
AI 理解员工的问题。 到企业知识库检索差旅管理制度。 找到住宿标准相关内容。 将检索结果交给大模型。 大模型根据制度内容生成回答。 返回答案及对应的制度来源。
二、企业知识库 RAG 是如何工作的?
第一阶段:知识入库——让企业文档变成 AI 能检索的知识
Word、PDF、Excel、PPT。 企业制度、管理规范。 业务流程、操作手册。 项目文档、技术文档。 历史报告、常见问题。 产品资料、培训资料。
Word:提取正文、标题和表格。 PDF:提取文本,必要时使用 OCR 识别扫描件。 Excel:提取工作表、表头和结构化数据。 PPT:提取标题、正文和图表说明。
第一块:请假管理规定。 第二块:出差审批流程。 第三块:差旅费用报销标准。 第四块:费用审批权限。
向量数据库:Milvus、pgvector、Chroma。 关键词检索:Elasticsearch 等。 文档存储:对象存储、文件服务等。
第二阶段:知识问答——让 AI 根据企业资料回答问题
向量检索。 关键词检索。 混合检索。 Rerank 重排序。
三、企业知识库 RAG 整体架构是什么?
四、企业知识库可以应用在哪些场景?
五、企业建设 RAG,最容易遇到哪些问题?
六、企业如何快速落地 RAG?建议从小场景开始
检索命中率。 答案准确率。 引用来源正确率。 无答案问题的拒答能力。 用户使用率。 知识更新及时性。