ARTICLE · 1345688
AI接入应用中的报表查询:表模板 · 命令集 · 问数框
AI接入应用中的报表查询:表模板 · 命令集 · 问数框
AI 只做它擅长的语义理解与步骤规划,真正的执行交给确定性引擎。位置选对了,AI 是产能;位置选错了,AI 是负债。
如果你在软件公司或企业的开发中心做行业应用——ERP、财务、供应链、CRM、政务系统——报表和查询是绕不开的功能。AI编程这么热,一个很自然的问题就是:这些事能不能用 AI 提效,让开发人员从无止境的排期里松一口气?
答案是能,但前提是先分清任务。业务方随口一句"做个报表查个数据",在工程上大概可以分成三种任务:固定报表、自助报表、通用查询。它们的交付物不同、代码重心不同,AI 该接在哪一段也完全不同。
先把结论放在前面:这三种任务都能用 AI 显著提效,但没有一种是"把数据和需求一起丢给大模型"。AI 的输出必须落到一个人能看懂、能改的中间物上——出了问题能定位,上线之后能维护。
本 文 脉 络
01 任务分解:三种功能,三种交付物02 固定报表:把 AI 接在"生成 API 调用程序"这一段03 自助报表:为什么不能把数据和需求直接丢给 AI04 通用查询:一个问数框,替代一堆查询界面05 三条路线的共同原则
01
任务分解:三种功能,三种交付物
"做个报表、查个数据"交给开发,其实是三件不同的事。三类方案共同的结构是:AI 只做语义理解与步骤规划,执行交给确定性引擎。
固定报表 —— 交付一份报表模板
多级表头、合并单元格、斜线格、跨页小计、打印边距。开发者做给系统用,讲究的是形式。它的产物是"给人看、给人改"的模板,而不是只有机器才懂的渲染代码——所以最先能被 AI 改造。
自助报表 —— 交付一个可嵌入的工具
最终用户是业务人员:想按省看、再按年拆、顺手算个占比。要做的不是替客户完成一次分析,而是交付一个业务人员能反复使用的能力。这类功能一旦做成黑盒,支持成本会迅速失控。
通用查询 —— 交付一个框加一套元数据
订单、客户、库存各做一套筛选面板,加个条件就要改前端、调接口、发版本。通用查询把这些分散的查询收敛成一个输入框:用户自然语言提问,开发侧维护元数据、词典和查询服务。
表 1 · 三类功能的工程视角对比
项目 | 固定报表 | 自助报表 | 通用查询 |
交付产物 | 报表模板 | 可嵌入的自助分析页面 | 查询页面 + 元数据与词典 |
工作重心 | 模板布局、取数逻辑 | 命令集与执行引擎对接 | 元数据/词典/权限及接口 |
AI 介入点 | 生成调用 API 的 Java 程序 | 把口语拆成汉语命令 | 把口语转成规范问句 |
验收方式 | IDE 里可视化审模板 | 分步执行、看中间结果 | 用户确认规范问句 |
失败模式 | 模板幻觉、渲染代码不可读 | 黑盒、算力与数据出域 | 关联与口径猜错且不报 |
注:AI 介入点那一行(蓝色)是三列里最关键的差别。
三种任务的差别不只是难度,而是"错在哪里、谁能发现、怎么改"——这决定了 AI 在每一类任务里应该站在什么位置。
02
固定报表:把 AI 接在"生成 API 调用程序"这一段
两条看起来可行的路,为什么都不通
✗ 路 一:让 AI 直接生成报表模板
报表模板是私有格式,公开语料几乎为零;多源混算、嵌套逻辑、像素级排版和打印设置交织在一起,不是一段线性文本能描述清楚的。硬让模型上,结果就是幻觉频发。
✗ 路 二:让 AI 直接写报表渲染程序
看起来更"工程":产出代码,编译运行。但它过不了上线这一关——渲染代码层层嵌套,报表稍复杂些就可能上万行,人读不懂就无法确认;报表需求又大多是临时性的,做完就改,指望测试集守住不现实。出了问题不知道错在哪一段,团队自然不敢用。
两条路的共同问题,是让 AI 直接产出"最终形态"。而最终形态恰恰是最难审、最难改的那一层。
可行方案:AI 写程序,引擎出模板,人在 IDE 里审
润乾报表的做法是把 AI 往后撤一步:不让它画报表,让它写一段调用 API 的 Java 程序,由引擎按 rpx 模板生成报表。链路是这样一条闭环:
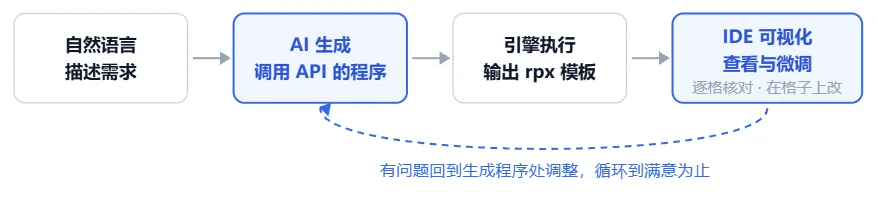
图 1 · 固定报表的 AI 闭环
关键在中间这一层。那段 Java 代码往往很长、结构复杂,但你不需要读懂它——它的职责只是调用 API 把模板造出来。程序员真正要看、要改的,是它生成出来的 rpx 模板:在 IDE 里检查行列结构、分组层级、公式引用和数据源绑定,直接在格子上改。
也就是说,AI 产出的程序是"生成模板的手段",模板才是"可评审的产物"。评审发生在模板层,修改也发生在模板层;哪一格不对,在 IDE 里就能定位,不必回头读代码,也不必把整个生成过程重跑一遍。交付物是看得见的模板,而不是只能整体接受或丢弃的黑盒。
一条真实指令,能细到什么程度
中国式复杂报表的难点,往往不在取数,而在排版:分栏、横向流动、合并、跨页。现在可以先用自然语言把布局讲清楚,让 Agent 生成骨架。比如这条指令:
AGENT 指令示例
连接 demo 数据源,用销售额数据生成数据集并按销售额排序;一页排三组相同的列,序号、产品名称、产品销售额三列为一组,同一行并排显示 3 条记录(第 1 行是记录 1、2、3,第 2 行是 4、5、6);数据按记录顺序"横向流动"——不是一行一条往下扩展,而是从左到右、从上到下依次填充;最后生成指定的 rpx 文件。
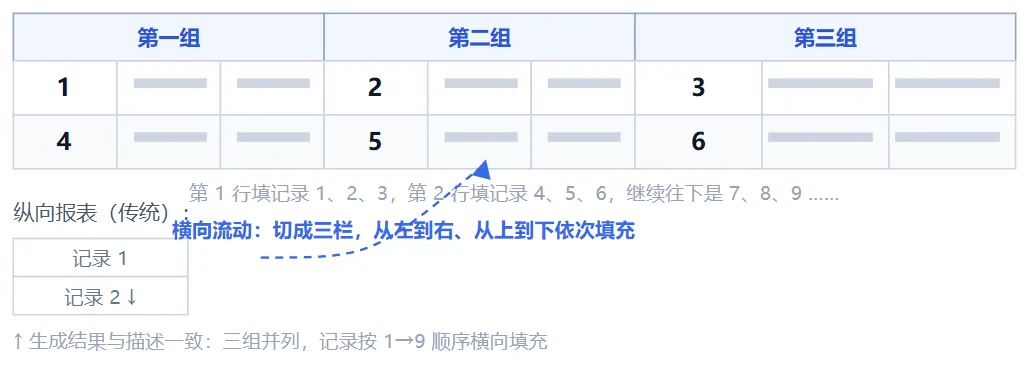
图 2 · 横向流动布局示意(三组并列、按记录顺序填充)
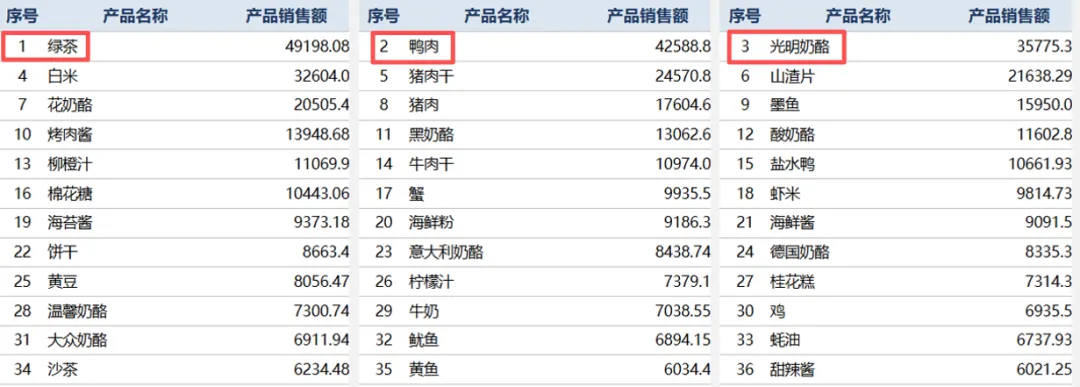
图 3 · 执行结果: 三组并列、按记录顺序横向流动 (真实生成报表)
Copilot:最后一公里,用汉语改模板
Agent 生成的模板通常还差一点:某个单元格要做组内排名、单价要分段显示、颜色要按阈值变化。这些事继续交给 Agent 并不划算——它可能改好了这一处,又在别处搞出新问题。更合适的做法是直接在 IDE 上改:选中单元格,用汉语把需求说清楚。
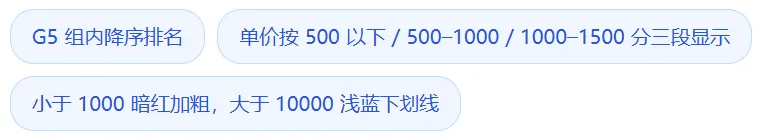
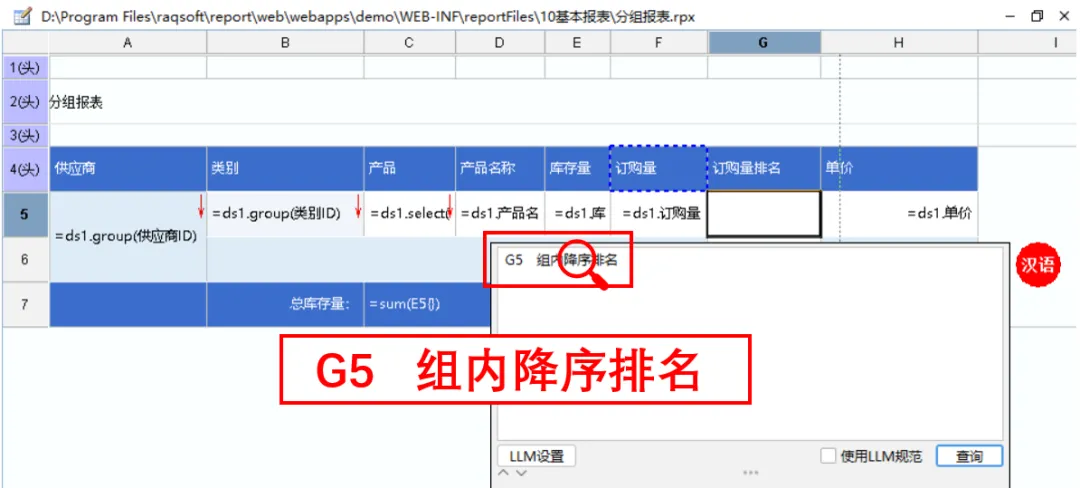
图 4 · 在报表 IDE 中选中单元格,用汉语完成局部修改(实际操作截图)
这就是常说的从 GUI 到 LUI:不用记菜单路径,说一句话就改。但它和纯对话式产品有个重要区别——改动的结果仍然落在可视化模板上,改完立刻看得见,不存在"说完了不知道它改到哪儿去了"的问题。
给开发团队的几条建议
1 先审结构,再看结果。先看行列结构、分组层级、公式引用对不对,再跑数据。结构对了,结果大概率对;结构错了,跑出来再漂亮也是错的。
2 Agent 当骨架生成器,Copilot 做精修。复杂布局、批量相似的模板适合 Agent 一次成型;一次性小改动用 Copilot 更快。两者配合,才是完整的工作流。
3 把需求写成"布局规格"。"横向流动""一页三组"这类词对模型是有效约束;"好看一点""紧凑一些"没有信息量。描述越接近结构,返工越少。
50%+
复杂报表开发从小时级压到分钟级。但对程序员来说,真正省下来的往往不是"第一次做",而是"改"——需求变一次的成本降下来,才是长期的收益。
03
自助报表:为什么不能把数据和需求直接丢给 AI
现在把数据和需求一起交给 AI,它也能直接生成报表页面,那还有必要专门做一个自助报表功能吗?乍一看确实能出东西,但放进产品里用起来,通常会遇到三面墙:
黑盒 结果不对时,用户定位不到哪一步错、也无法只改一处,只能换个说法重来——本来对的地方可能又改错了。
算力 让模型直接吃数据、做推理,开销跟数据量走。企业没有多少算力余量,很难为一个查询功能长期兜账。
安全 频繁把业务数据送进大模型,若模型在公网,数据出域风险直接上桌面,很多行业根本不会讨论。
方案结构:口语进, 汉语命令出, 规则引擎执行
润乾报表的做法,是让 AI 把用户需求拆成一串可执行的汉语命令,再由规则引擎逐步执行。一句"订单金额超过 5000、按省份和年份分组汇总、再算省内金额比例环比、金额按货币格式"的需求,被拆成 7 步:
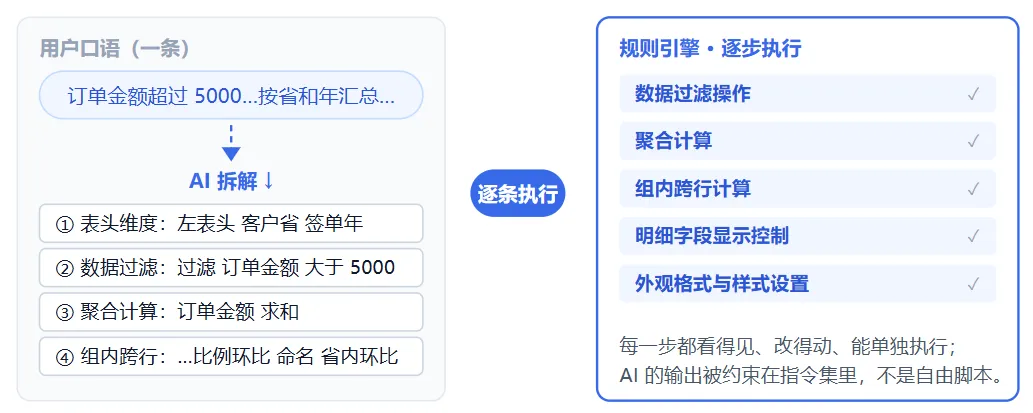
图 5 · 口语拆解为汉语命令序列,规则引擎逐步执行
这张图里最值得程序员注意的,不是界面,而是命令是有限集合、参数是结构化的。指令集越稳定,模型能"飘"的空间越小,你也越敢把它放进产品。
表 2 · 部分典型汉语命令族
命令类别 | 典型写法 | 作用 |
表头与维度 | 左表头 客户省 签单年 | 设定行、列维度的分组字段 |
数据过滤 | 过滤 订单金额 大于 5000 | 按条件筛选记录 |
聚合计算 | 订单金额 求和 | 生成指标值 |
组内跨行计算 | 在客户省 范围内 计算 订单金额 比例环比 命名为 省内金额比例环比 | 分区内的占比、环比、排名、累计 |
明细控制 | 隐藏全部明细 | 控制明细行是否展示 |
排序 | 排序 订购年 升序 | 结果排序 |
外观与格式 | 位置 订单金额 显示为 "#,##0.00" | 数字格式、条件样式 |
注:命令族是有限集合,AI 的输出被约束在其中。
回看三面墙,这套结构正好一一接住:过程不再是黑盒——每一步命令都看得见、改得动,错了只改那一条,还能单独执行看中间结果;算力不再随数据量膨胀——AI 只做翻译和规划,不碰数据,消耗跟需求复杂度走,而不是跟数据规模走;数据不出私域——进模型的只有表样、字段和需求,业务数据始终留在自己的库里。
两种用法:单步执行与整体规划
单步执行
一步一步输入、一步一步执行、一步一步完善。适合调试和精细控制。
整体规划
把一段宏观需求整体交给 AI 拆解,再决定整体执行还是逐步执行。
对用户的价值在于排障粒度:拆错了,改的是某一条命令,不是推翻重来;某一步结果不对,单独执行那一步就能看到中间结果。这相当于给"自然语言做表"装了一个单步调试器——问题定位到步骤,而不是在一整段生成物里试错。
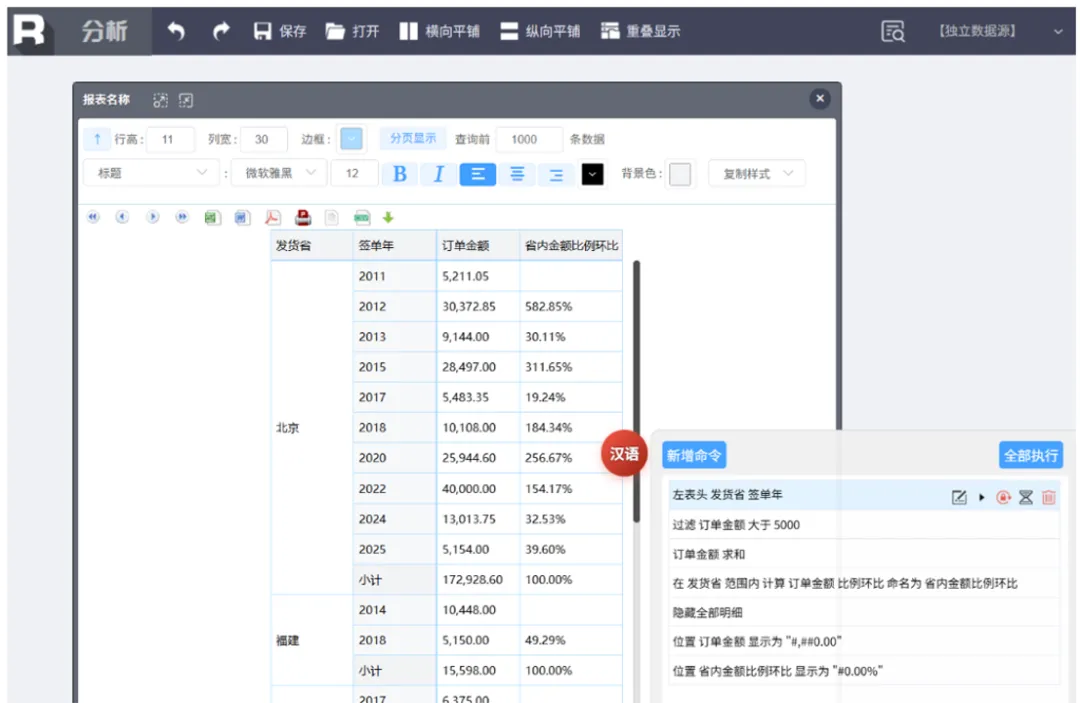
图 6 · 整体规划的执行现场:左侧报表随命令逐步生成,右侧为待执行的新命令(实际截图)
落地时要注意的工程点
1 指令集是你的契约。它连着提示词、连着历史数据、也连着用户的肌肉记忆。改指令集要像改 API 一样谨慎,最好有版本号。
2 数据不进模型。只把表样、字段和需求交给 AI,数据留在自己的库里。token 消耗比"让模型算数"低两个数量级,也自然绕开了数据出域。
3 每一步都要能单独执行。这是给业务用户的"退一步改一步",也是给你自己的排障能力。没有这一步,白盒就只是口号。
04
通用查询:一个问数框,替代一堆查询界面
做查询最贵的从来不是那个筛选框,而是重复:每个模块一套面板、一套接口、一套权限判断;需求一改就要改前端、联调、发版。界面长得都差不多,代码却要写很多遍。
市面上的 ChatBI,为什么大多落不进应用系统
形态重
多是独立的数据分析产品,自带登录、看板、管理后台。要嵌进业务系统,得打通账号、权限、数据、界面风格,工作量不亚于自研一套查询模块。
栈太重
主流方案是"大模型 + 向量库 + RAG 知识库"三件套,需要 GPU 服务器、专人做数据标注和提示词调优。为一个查询功能搭一整套 AI 基建,很难算得过账。
黑箱化
纯大模型生成 SQL 本质是概率猜测:简单查询看着准,一到多表关联、复杂口径就容易翻车;更麻烦的是错了也不报,照样返回一个看似合理的结果。
纯 AI 生成 SQL 的死穴
90% 的准确率,在业务用户这里等于 0
简单查询它确实做得不错——所以各类 Demo 的准确率都很好看。但真实业务查询大多是分组聚合、多表关联、条件组合,一旦涉及口径和关联关系,模型的猜测就开始翻车。业务用户不知道这一次是不是撞上了那 10%,看不懂 SQL,就没有能力核对。于是功能上线了,却没人敢用。这不是"准确率不够高",而是"无法验收"——两条性质不同的红线。
方案:规范问句 + 规则编译
润乾 NLQ 的链路是:业务口语 → AI 转译成一句语义规范问句 → 用户确认 → 规则引擎确定性地编译成 SQL → 执行返回。以"去年谁没开单"为例:
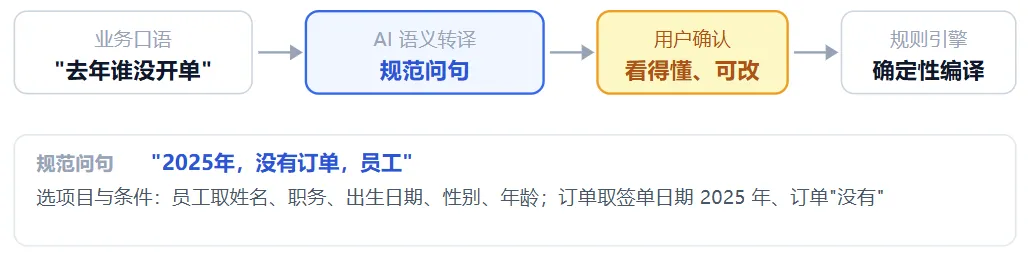
业务用户看不懂 SQL,但
图7 · 规范问句编译链示意 (口语→规范问句 → 确定性编译出SQL)
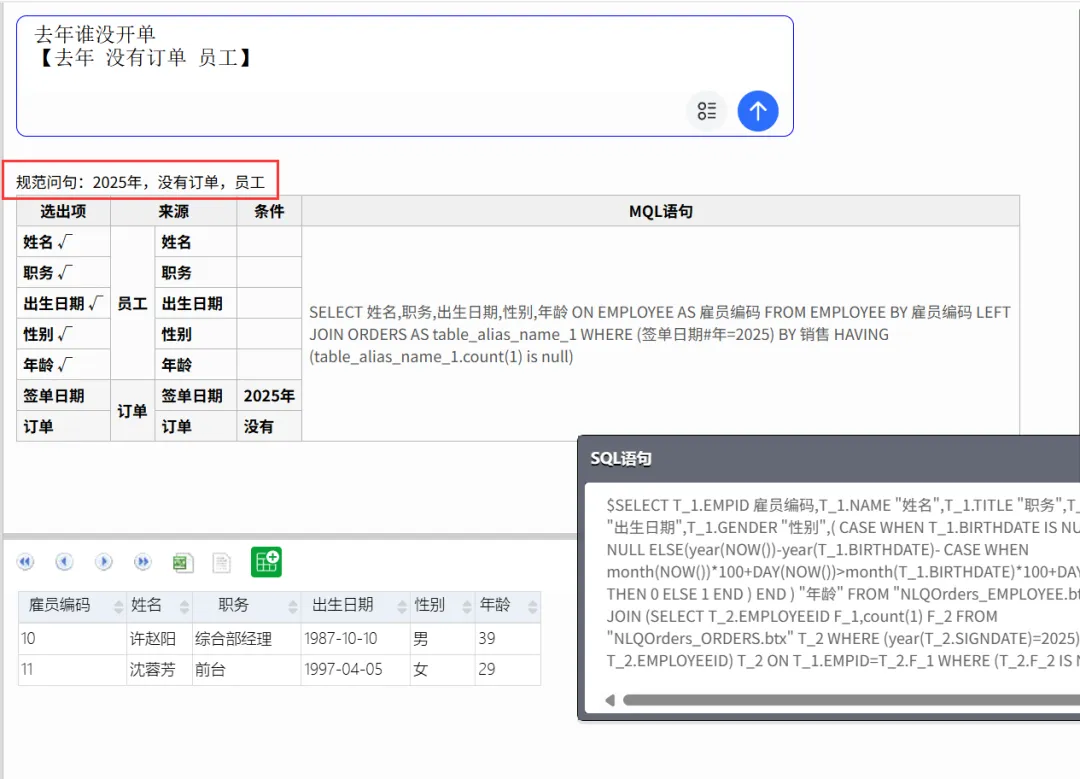
图 8 · 问数框运行现场:口语「去年谁没开单」→ 规范问句 → SQL → 结果(实际截图)
这条链路同时解决了三件事:业务用户能确认——他看不懂 SQL,但看得懂规范问句是不是自己想问的;关联与口径不靠猜——主表子表的存在性判断、JOIN 关系由元数据与规则层决定;结果可复现——确认之后是确定性编译。
AI 在这里的边界被划得很清楚:不懂表结构、不猜外键、不写 SQL、不做口径决策,只做语义转译。它只需要一个通用大模型的 API Key,不需要微调、不需要训练——对开发团队意味着,模型可以换,链路不用动。
从"每页做查询"到"一个组件 + 一套元数据"
表 3 · 传统查询界面与问数框的工作量对比
工作项 | 传统做法:每页一套查询界面 | NLQ 方案:一个通用问数框 |
前端 | 每页一套筛选面板,条件变了改页面 | 一个标准输入框组件 |
后端 | 每页一个查询接口,逐个联调 | 统一查询服务,JDBC 调用 |
口径与关联 | 散落在各接口的 SQL 里 | 元数据与词典集中定义 |
权限 | 各接口分别实现,容易漏 | 继承系统原有权限体系 |
新增需求 | 改前端、调接口、发版本 | 加一条词典配置 |
接入方式按组件的标准来:标准 JDBC 驱动,加载 JAR 包、配置数据源、在代码里调用;前端就是一个输入框。核心是规则引擎,不需要 GPU、不需要向量库,普通 CPU 服务器就能跑。权限也不用另做一套:直接继承系统原有权限体系,不同岗位的人问同一句话,返回各自权限范围内的数据。
覆盖范围:不能只查"北京的订单"
只能处理简单条件筛选的问数,是玩具。通用查询需要覆盖四类查询范式,再加上取数之后的跨行运算,才能覆盖绝大多数常用需求:
表 4 · 通用查询需要覆盖的查询范式
查询范式 | 典型问题 | 技术要点 |
单表明细筛选 | 上周发往华北地区的订单有哪些 | 条件过滤与明细返回 |
单表聚合排名 | 各省订单金额排名 | 分组、聚合、排名 |
主子实体关联过滤 | 上个月没有开单的员工 | 主表与子表的存在性判断 |
多维对齐汇总 | 按省份、年份汇总并计算 | 多维交叉统计 |
跨行运算 | 占比环比排名 | 针对结果集做跨行计算 |
多表 JOIN 不交给 AI 猜,由规则引擎按元数据自动计算。这既是准确率的来源,也是你能向客户解释"为什么这次和上次一样"的依据。
元数据可以交给智能体生成
做问数最重的一块其实不是查询本身,而是元数据:表结构、字段映射、汉语词典、口径定义、提示词。过去靠熟手一点点配,一个主题域动辄一两天。现在可以把这条流水线交给智能体:连库读表结构、生成 DQL 元数据、构建汉语词典、编写提示词、配置数据源、Web 上线、JDBC 真连真查——人只在每一步做确认。
数周 → 几天
原本数周甚至上周的元数据配置工期,现在一两天就能跑通。形态上是 MCP 一体化服务:既能被智能体当工具调用,也能配 SKILL 端到端搭建。维护也轻——新增业务加一条词典配置,普通开发就能做。
落地边界:不是所有查询界面都该删
从实践看,最优组合是"问数框为主、高级筛选为辅":
✓ 可以替代
临时多变的条件筛选、各类分组汇总排名、突发的非标准化查询。这类需求等开发排期最不划算,直接问就出结果。
→ 建议保留
极高频的固定操作(点按钮比打字快)、强引导型的新手场景、极复杂的多步深度分析——还是走原来的功能入口更顺手。
05
三条路线的共同原则
把三种方案放在一起看,会发现结构是同一个:AI 做语义与规划,引擎做执行,只是中间物不同。
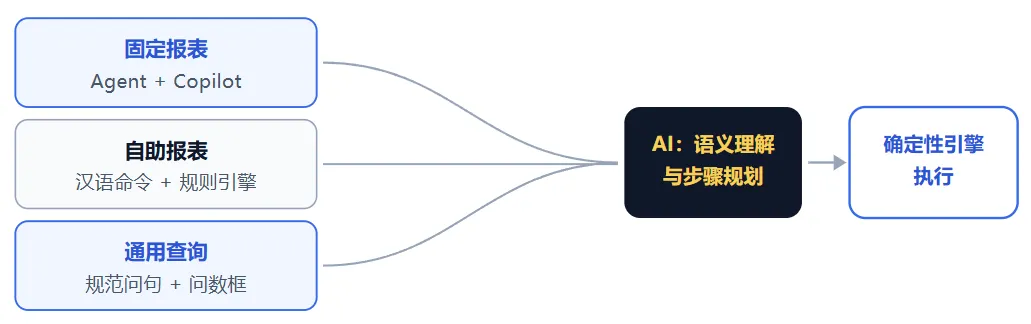
中间物分别是:rpx 模板 · 汉语命令序列 · 规范问句 —— 共同点是人都看得懂、能改
三条路线收敛到同一结构
中间物必须是人能看懂、能改的东西
这不是为了某个理念,而是为了两件很实际的事:出了问题你能定位,上线之后你能维护。凡是 AI 直接产出最终形态的方案,都会在这两件事上付出代价。
成本要算全
算力、token、数据出域、支持人力,四项里任何一项失控,功能都活不长。把模型当翻译器而不是计算器,成本差两个数量级。
形态要组件化
开发商交付的是系统的一部分,用户不该为此跳转到另一个产品;能不能嵌、能不能连、能不能管、能不能养,比功能列表更重要。
结 语
报表行业过去解决过两个问题:能不能做出中国式复杂报表,数据准备能不能从报表里解耦。现在多了新问题:如何利用 AI 提效?AI 生成的东西,怎么才能放心地放进生产?
润乾报表的路线一直没变:把 AI 的输出落到一个确定的、人能改的中间物上。对开发商来说,这意味着三件事可以分开做、按需做——固定报表用 Agent 加 Copilot,自助报表用汉语命令加规则引擎,通用查询用规范问句加一个问数框。
不必等一个"万能方案"。把 AI 放对位置,三类功能都能在自己的应用里先跑起来。