ARTICLE · 1357757
在嵌入式软件中,固件能回滚,配置却回不去了:OTA还缺哪一步?
做过几年 OTA 的同学,对 A/B 分区、镜像签名校验、启动计数、自动回滚这一套应该都不陌生。现在主流的方案,不管是 MCUboot、自研 bootloader,还是 Linux 上的 RAUC、SWUpdate,在“固件能不能退回去”这件事上都已经做得相当成熟了。
但有一类问题,我在不同项目里反复遇到:固件确实回滚成功了,旧版本也正常跑起来了,可设备的配置、校准参数、配网信息却没了;或者旧固件读到一堆它不认识的数据,直接走了恢复出厂默认。从用户的角度看,设备“升级失败之后变成了一台新机器”,有时候这比彻底变砖还麻烦,因为它看起来是好的,问题要过很久才暴露。
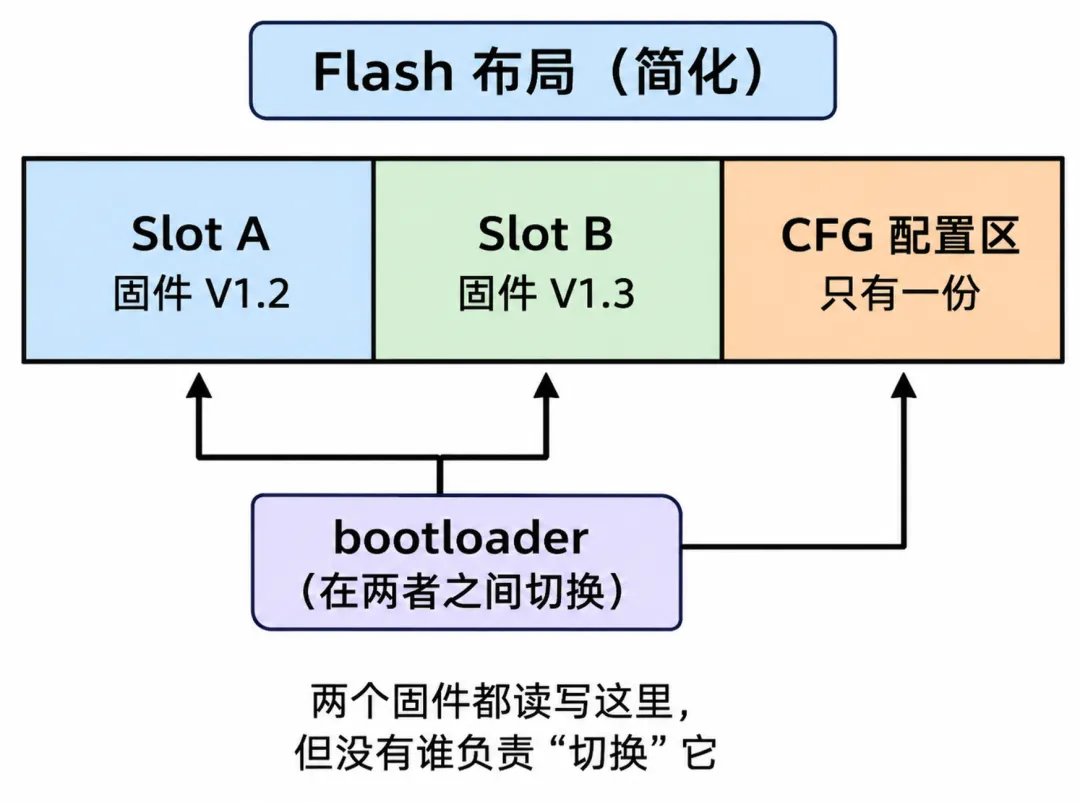
原因说起来并不复杂:固件有两份,数据只有一份。 固件回滚是把程序换回去,而持久化数据一旦被新固件改写,就没有谁负责把它换回去。
完整的 OTA 流程和通信协议的版本兼容,之前已经单独聊过,这篇不再重复。今天只盯一个很窄、但很容易出事的窗口:新固件改了持久化数据的格式,随后固件又被回滚,这段时间里数据该怎么管。
一、先把问题摆清楚
举一个很典型的例子。
某款设备的 V1.2 固件,配置区存的是一个定长结构体,我们叫它格式 v3。里面有设备 ID、服务器地址、Wi-Fi 凭据,以及几个传感器的校准系数。
V1.3 要支持多服务器,顺便把校准系数从 float 改成定点数,于是配置格式升级为 v4:结构体变了,字段顺序变了,长度也变了。
V1.3 的开发同学做得也挺规矩:首次启动时检测到 v3,就把它转换成 v4 写回配置区,后面统一按 v4 读写。
先看一下 Flash 的大致布局:
再看出问题的那条时间线:
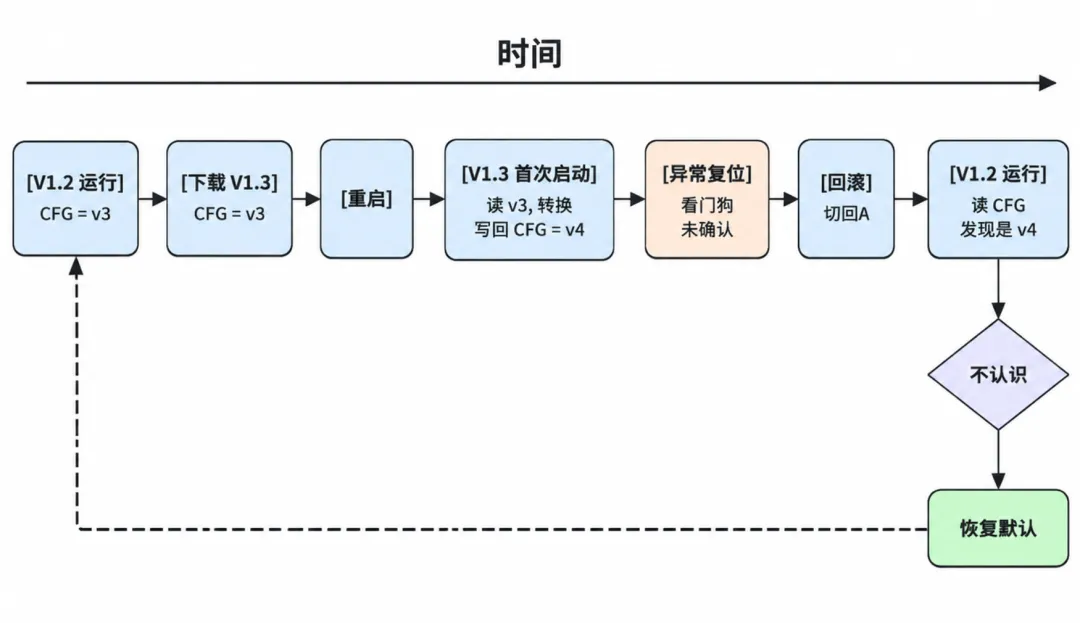
V1.3 在确认之前出了问题,可能是某个外设驱动在新硬件批次上初始化卡死,也可能是网络模块握手异常导致看门狗复位。bootloader 按设计回滚到 V1.2,这一步本身完全正确。
麻烦在 V1.2 去读配置区的时候。magic 对不上、CRC 校验失败、长度不符,好一点的代码会判定“配置损坏”,加载默认值;差一点的代码会直接按 v3 的结构体去解释 v4 的数据,读出一个错误的服务器地址,或者一个离谱的校准系数,然后带着错误参数继续工作。
后一种更危险。前一种至少还能被发现,后一种可能会让设备在现场“看起来正常地”输出错误数据。
二、根因:一个版本号背了三份职责
很多项目里,配置区只有一个“版本号”,而且这个版本号经常直接写的是固件版本。这样做隐含了一个假设:数据格式跟着固件走,固件升到哪,数据就升到哪。
这个假设在“只升不降”的世界里是成立的。一旦引入回滚,它就不成立了:回滚时固件版本倒退了,数据却没有倒退。
我的习惯是把它拆成三个独立的东西:
这三者的变化节奏完全不同。固件可能连发五个版本,数据格式一次都不变;也可能某个小版本就改了格式。迁移状态则只在格式变化的那几次启动里才有意义。
把它们揉在一起,就会出现“看到版本号变了,但不知道该不该迁移,迁移了也不知道能不能退”的局面。后面所有的设计,都是建立在把这三件事分开的基础上。
三、让数据能够“自我描述”
拆开之后,第一件事是让持久化数据带上足够的信息,使任何一个版本的固件拿到它,都能判断三件事:这是什么格式、我能不能读、我能不能写。
我常用的配置头大致是这样:
typedefstruct {uint32_t magic; /* 固定魔数, 区分"空 Flash"和"有数据" */uint16_t schema_ver; /* 这份数据的格式版本 */uint16_t min_read_ver; /* 读懂这份数据, 读者至少要支持到哪个格式 */uint16_t min_write_ver; /* 改写这份数据, 写者至少要支持到哪个格式 */uint16_t flags;uint32_t seq; /* 写入序号, 每写一次递增 */uint32_t src_seq; /* 若是迁移产物, 记录源数据的 seq */uint32_t payload_len;uint32_t crc32; /* 覆盖头部(除自身)和 payload */} cfg_hdr_t;固件这边,每个版本在代码里声明自己的能力:
#define CFG_SCHEMA_CUR 4 /* 本固件写出的格式 */#define CFG_SCHEMA_SUPPORT 4 /* 本固件能完整理解的最高格式 */启动时的访问判断:
cfg_access_tcfg_check_access(constcfg_hdr_t *h){if (h->magic != CFG_MAGIC || !cfg_crc_ok(h))return CFG_INVALID;if (h->min_read_ver > CFG_SCHEMA_SUPPORT)return CFG_UNREADABLE; /* 看不懂, 绝不能拿默认值覆盖它 */if (h->min_write_ver > CFG_SCHEMA_SUPPORT)return CFG_READ_ONLY; /* 能读, 但写回会丢掉不认识的字段 */return CFG_READ_WRITE;}min_read_ver 和 min_write_ver 的意思是:如果 v4 只是在 v3 后面追加了几个字段,旧字段含义没变,那 v4 数据可以把 min_read_ver 设为 3,告诉 v3 的读者“你可以读,忽略后面的就行”;如果 v4 改了旧字段的语义,就必须把 min_read_ver 设为 4,让旧固件明确知道自己读不懂。
这个思路不是我发明的。Linux ext4 文件系统的超级块里有 compat、ro_compat、incompat 三组特性标志,含义几乎一样:不认识 compat 特性,照常挂载;不认识 ro_compat 特性,只能只读挂载;不认识 incompat 特性,拒绝挂载。嵌入式配置区借用这套语义非常合适,判断逻辑只有几行,却能把“读错”变成“明确知道读不懂”。
这里有一个特别容易被忽略的细节:旧固件判定“读不懂”之后,绝对不能顺手把默认配置写回 Flash。
很多代码的写法是“校验失败,加载默认,保存”。这一保存,就把新格式的数据彻底抹掉了,就算之后再升级回新固件,也找不回来了。正确的做法是:读不懂就在 RAM 里用默认值降级运行,Flash 上的数据原样保留,同时上报一个明确的故障码,让后台知道这台设备处于“数据不可读”的降级状态。
但请注意,这个前提是旧固件本身就有这段逻辑。如果 V1.2 发布时没写,那 V1.3 再怎么设计也改变不了 V1.2 的行为。这也是为什么我一直说,数据兼容要“提前埋”,在第一版就把头部结构和降级策略定下来,哪怕当时根本用不上。
四、前进/回退兼容矩阵
讨论兼容性时,我建议团队把矩阵画出来,而不是口头说一句“应该兼容吧”。
先分清两个方向:
- 向后兼容
:新固件读旧数据,比如 V1.3 读 v3。这个相对容易,迁移代码干的就是这件事。 - 向前兼容
:旧固件读新数据,比如 V1.2 读 v4。这个难,因为 V1.2 已经发出去了,你改不了它。而回滚恰恰需要的就是这个方向。
以 V1.2 和 V1.3 为例,数据分三种情况:
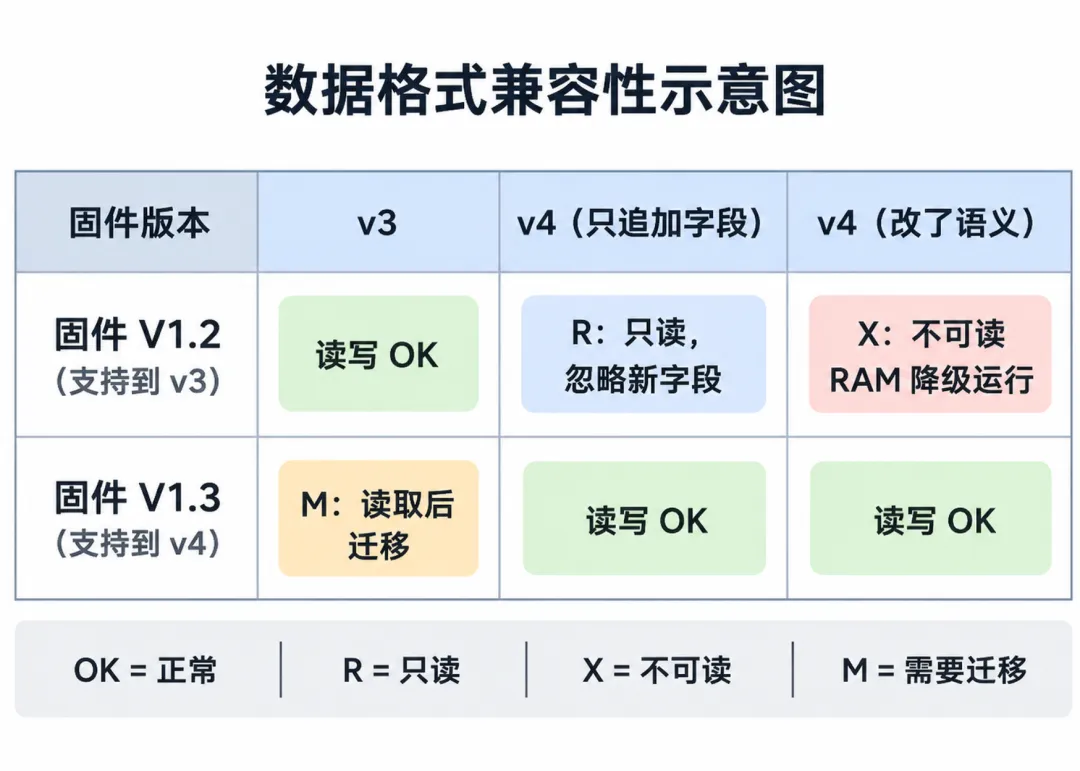
判断一个方案是否“回滚安全”,看的就是:回滚之后,旧固件面对的那份数据,是否落在它的 OK 格子里,至少也要落在 R 格子里。 一旦落进 X,就必须有其他手段兜底,否则数据层面的回滚就是失败的。
如果你的产品允许跨多个版本降级,比如从 V1.5 直接退到 V1.2,那矩阵要按所有允许的版本对来画。格子数量增长得很快,这本身就是一个信号:降级范围越大,数据设计的负担越重,后面讲边界时会再回到这一点。
五、四种做法,各有各的账
知道了问题在哪,接下来是怎么做。我把实际项目里用过的做法归成四类,每一类都有代价,没有哪个是白送的。
1. 兼容读取:格式只追加,不改语义
做法是用 TLV,或者“定长头 + 版本化追加段”的结构。新字段只往后追加,旧字段的含义永远不变。如果确实要改语义,就新增一个字段,旧字段继续维护。比如校准系数从 float 改定点,就保留原来的 float 字段,再新增一个 Q16 定点字段,新固件写入时两份都写。
优点很明显:不需要额外 Flash,回滚几乎零成本。如果旧固件写回时能原样保留它不认识的 TLV,那旧固件连“只读”都不用,照常读写。
代价也很明显:
格式会越来越臃肿,新旧字段并存需要约定冲突规则。比如回滚后 V1.2 只改了旧字段,再次升级到 V1.3 时,新字段已经过时,要能识别出“以谁为准”。 旧固件必须本来就具备“跳过未知字段”甚至“保留未知字段”的能力,这又回到了“提前埋”的问题。 有些变化根本做不到兼容:存储布局从单扇区改成多扇区日志、加密方式变化、字段之间出现新的约束关系等。
2. 暂存新格式:迁移结果写到另一块区域
做法是 V1.3 把 v4 写到一块新的区域 CFG_B,原来 CFG_A 里的 v3 原封不动。确认之前两份并存,V1.3 只用 CFG_B,V1.2 只认 CFG_A,互不干扰。
这是我在“旧固件已经发出去、当初也没埋兼容逻辑”的情况下最常用的方案,因为它完全不依赖旧固件的任何配合。
代价是:
多占一块 Flash,而且通常是一个完整的擦除扇区。 确认之前,用户在 V1.3 上做的配置修改只存在于 CFG_B,回滚后会丢。如果要保留,就得把能表达的部分同步写回 CFG_A 的 v3 格式,也就是双写,擦写次数和代码复杂度都会上升。 回滚后 CFG_B 会成为残留数据,再次升级时必须判断它是否已经过期。前面头部里的 src_seq就是干这个的。
3. 延后不可逆迁移:把迁移拆成两段
所有会破坏旧格式的动作,包括擦除旧区、复用旧区存放新数据、改变旧字段语义,都推迟到固件确认之后,甚至推迟到“稳定运行若干次启动”或“下一次升级之前”再做。
它的价值在于把迁移明确地分成“可逆段”和“不可逆段”,回滚窗口内只发生可逆操作。它通常不单独使用,而是和方案 2 组合。
代价是需要一个持久化的迁移状态机,代码要处理各种“做到一半”的中间状态;而且不可逆动作一旦执行,回滚保护就失效了,之后的降级必须靠别的策略。
4. 保留旧副本:迁移前做快照
迁移前把 CFG_A 整块拷到 BACKUP 区,然后原地迁移。回滚时,由某个角色把 BACKUP 恢复回来。
这里的关键问题是:谁来恢复? V1.2 不知道 BACKUP 的存在,因为它发布在这个机制之前;V1.3 在被动回滚时根本没机会运行。剩下的只有 bootloader。所以这个方案通常要求 bootloader 理解配置区,而 bootloader 往往是不可升级的,等于要在第一版 bootloader 里就规划好。
另外,快照只是一个时间点,快照之后的所有修改,回滚后都会丢失。它更适合作为“Flash 实在没有空间给第二份配置、只能原地迁移”时的退路。
四种方案放在一起比较
顺带说一下“反向迁移”
还有一个经常被提出来的想法:让新固件在回滚前把数据转回旧格式。
这只适用于主动降级,也就是云端下发降级指令,新固件还活着,可以从容地执行反向转换。而 OTA 里最需要保护的恰恰是被动回滚:新固件启动卡死、看门狗复位、确认超时。这时新固件根本没机会执行任何代码。所以反向迁移只能作为主动降级路径的补充,不能当成回滚保护的主方案。
我在实际项目里最常用的组合是:兼容读取打底,暂存新格式兜底,延后不可逆迁移控制时机。 能兼容的字段尽量兼容,兼容不了的走影子区,所有破坏性动作统一放到确认之后。
六、首次启动确认点:数据迁移该挂在哪
方案选好之后,还有一个决定成败的问题:迁移的每一步,和固件的确认点是什么先后关系。
以 MCUboot 为例,新镜像以 test 模式启动,应用需要主动把镜像标记为已确认(Zephyr 里对应 boot_write_img_confirmed())。如果确认之前发生了复位,下一次启动时 bootloader 会自动换回旧镜像。自研 bootloader 大多也是这个思路,用试用标志或启动计数来实现。
确认点打在哪里很关键。我见过不少项目在 main() 一开头就确认,这样回滚保护基本形同虚设。比较合理的做法是关键链路自检通过之后再确认,例如:
配置读取或迁移成功,且关键参数通过合法性检查; 关键外设初始化成功; 联网设备与服务器完成一次完整的心跳或业务交互; 稳定运行一段时间,没有异常复位。
落到数据上,原则只有一句话:固件确认之前,只允许做可逆的数据操作;不可逆的操作,必须放在固件确认之后。
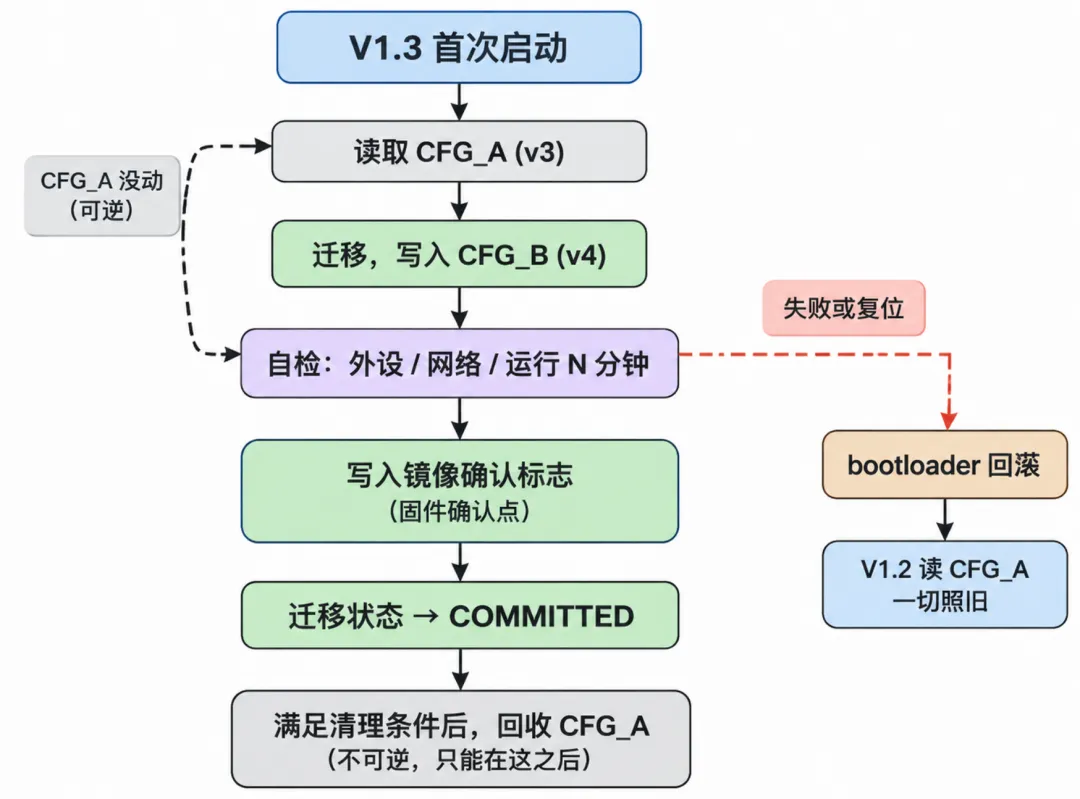
这里还有一个顺序上的细节:先确认固件,再提交数据状态,并且启动时要能根据“镜像是否已确认”修正迁移状态。
如果反过来,先写 COMMITTED 再确认固件,中间恰好断电,设备会回滚到 V1.2,而迁移状态却显示“已提交”。等下次再升级到 V1.3,它可能直接信任残留的 CFG_B,而忽略 V1.2 运行期间对 CFG_A 的修改。按正确的顺序,最坏情况只是“固件已确认、数据状态还没提交”,下次启动补写一次就好,这是一个可以自愈的中间态。
七、贯穿案例:从旧配置到回滚的一条完整流程
把前面的东西串起来,看一条完整的路径。迁移状态单独存放在一个很小的区域,状态机如下:
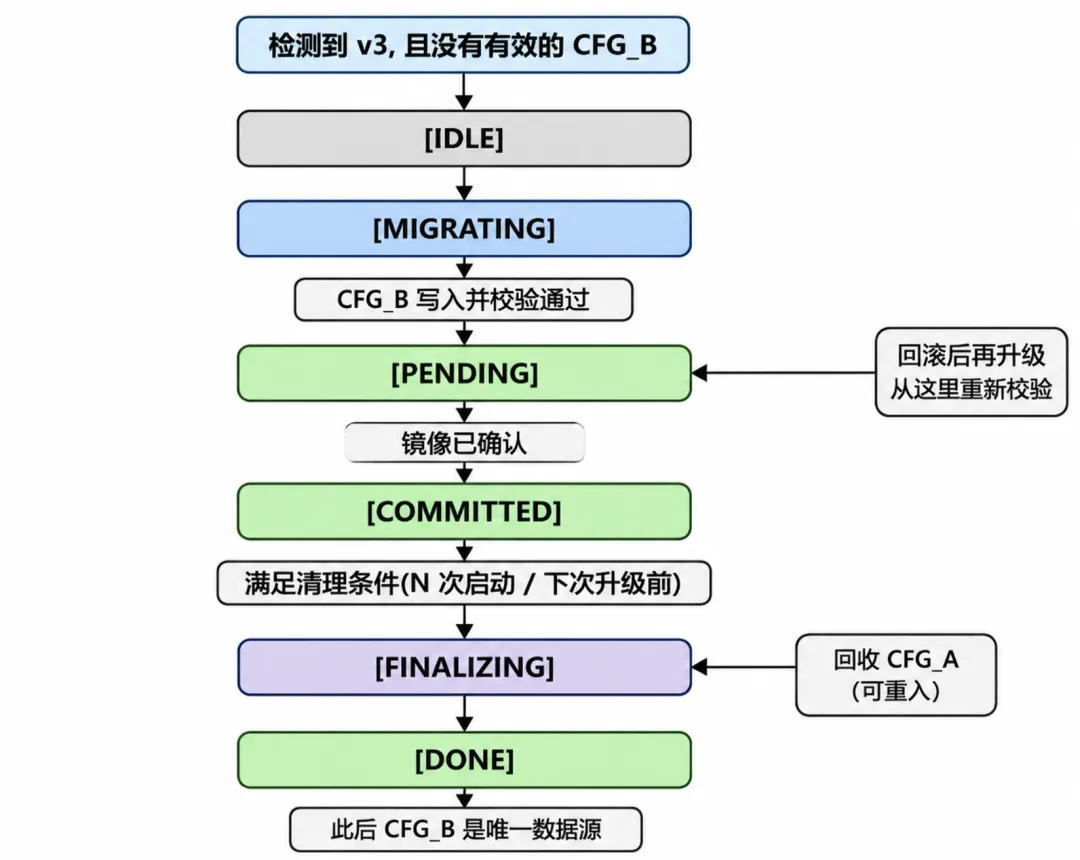
对应的启动逻辑,简化后大致如下:
voidcfg_boot_init(void){mig_state_t st = mig_state_load();switch (st) {case MIG_IDLE:case MIG_MIGRATING: /* 上次没做完就重做, 迁移必须幂等 */if (cfg_a_valid_v3()) { mig_state_save(MIG_MIGRATING); cfg_migrate_a_to_b(); /* 只写 CFG_B, 不碰 CFG_A */ mig_state_save(MIG_PENDING); }break;case MIG_PENDING:/* CFG_B 不是由当前 CFG_A 迁移来的: 回滚期间 CFG_A 被改过, 重做 */if (!cfg_b_derived_from(cfg_a_seq())) cfg_migrate_a_to_b();if (boot_is_img_confirmed()) /* 修正"已确认但未提交"的中间态 */ mig_state_save(MIG_COMMITTED);break;case MIG_COMMITTED:if (cleanup_condition_met()) mig_state_save(MIG_FINALIZING);break;case MIG_FINALIZING: cfg_a_reclaim(); /* 断电后重启会继续执行 */ mig_state_save(MIG_DONE);break;default:break; } cfg_select(CFG_B);}/* 自检全部通过后调用 */void app_confirm_update(void){ boot_write_img_confirmed(); /* 先确认固件 */ mig_state_save(MIG_COMMITTED); /* 再提交数据状态 */}cfg_b_derived_from() 做的事情,就是比较 CFG_B 头部的 src_seq 和 CFG_A 当前的 seq。只要 V1.2 在回滚期间改过哪怕一次配置,seq 就会变化,残留的 CFG_B 也就被判定为过期,需要重新迁移。这一步看起来不起眼,却是“回滚后再升级”这条路径不出错的关键。
至于“已经 DONE 之后又要降级”的情况,这时 CFG_A 已经被回收,回滚保护已经结束。这条路径要么在产品层面明确禁止,要么由 V1.3 在降级前主动导出一份 v3 格式,属于主动降级的范畴,和前面说的被动回滚要分开设计。
八、每个阶段都要真正断一次电
设计写在纸上永远是完美的,能不能经得住现场,要靠断电测试。下面是我按这条流程整理的用例,每一项都对应流程中的一个具体时刻:
测试手段上,我一般在关键位置埋故障注入点:
#ifdef CFG_FAULT_INJECT#define FAULT_POINT(id) fault_point_hit(id) /* 命中配置的 id 时立即复位 */#else#define FAULT_POINT(id) ((void)0)#endif光有软件复位还不够。软件复位通常不会打断一次正在进行的 Flash 编程,而真实掉电会,留下写了一半的字甚至半擦除的扇区。所以还需要用可编程电源或继电器做真实断电,在随机时刻切掉供电,整套“升级、断电、恢复、校验”的循环挂一晚上,跑几千次,再看日志里有没有任何一次数据异常。
九、边界:不是加一个版本字段就算完成
最后想专门聊一下边界,因为我见过太多“在配置头里加了个版本号,就宣布 OTA 回滚问题解决了”的情况。
版本字段解决的只是识别,不解决保留。旧固件识别出“我读不懂”之后,数据还在不在、谁来保住它、用户的设置还能不能用,这些都需要存储布局、迁移状态、确认时机和测试用例一起配合。而真正能落地哪种方案,又受到下面三个条件的约束。
第一是 Flash 容量。 内部 Flash 的擦除粒度往往很粗,比如 STM32F4 的扇区从 16KB 到 128KB 不等。配置可能只有几百字节,但影子区至少要占一个独立扇区。如果最初分区时没有留余量,方案 2 就无从谈起,只能退回方案 1 或方案 4。所以我建议在项目初期规划分区时,就给配置区留出“新格式暂存”的空间。
第二是写入寿命。 内部 Flash 常见的标称擦写次数在 1 万次左右,外部 SPI NOR 通常在 10 万次量级。一次迁移带来的擦写可以忽略,但双写会让之后每一次配置修改的擦写量翻倍。计数器、累计运行时长这类高频写入的数据,不要纳入双写,应该单独放进带磨损均衡的日志区,用兼容读取的方式处理。
第三是回滚需求本身。 先和产品确认清楚,要的是哪一种:
只保障被动回滚,即新固件试用失败后自动退回; 支持确认后主动降级到上一个版本; 支持任意版本之间的降级。
越往下,成本越高,兼容矩阵越大。很多产品比较合理的选择是:保障被动回滚,确认之后通过防回滚版本号禁止跨越数据格式变化的降级。这是一个产品决策,不应该由开发在代码里默默决定。
另外,不是所有数据都值得同样的保护力度,分级处理能省下很多成本:
写在最后
回头看这个问题,它表面上是 OTA 的问题,本质上却是一个架构问题:持久化数据归谁管,格式由谁定义,版本和迁移状态放在哪一层,启动流程里谁有权决定“现在可以做不可逆操作了”。
如果配置的读写散落在各个业务模块里,每个模块自己把结构体 memcpy 到 Flash,那上面这些设计基本无从落地,因为根本找不到一个统一的地方去做版本判断和迁移。只有当配置、参数、状态被收拢到一个职责清晰的存储服务里,兼容判断、迁移状态机、确认联动和故障上报才有了落脚点。
这类“功能本身不难,难在系统怎么组织”的问题,我最近系统整理成了一套 《嵌入式软件架构实战合集》,一共二十篇,从分层、模块边界、接口设计、依赖解耦,一路讲到状态机、事件驱动、RTOS 任务模型、协议与业务解耦、日志与故障码设计,最后用一个真实项目的重构案例把这些串起来。和今天这篇关系最近的几篇,比如《配置、参数、状态、数据流应该放在哪里?》《协议版本兼容:如何避免升级后新旧设备互相不认?》《错误码、故障码、运行状态如何统一设计?》,都可以看作是这篇文章背后的“地基”。
如果你已经写过几个项目,开始被模块耦合、全局变量、功能难扩展、现场问题难定位这些事情困扰,希望不只是把功能写出来,而是想弄明白一个嵌入式项目应该怎么组织、怎么演进、怎么长期维护,可以去公众号的合集里看一看,相信会对你有所帮助。
有任何问题,也欢迎在评论区一起交流。
往期推荐