ARTICLE · 1358204
把PDF交给AI前,先保留能核对的版面
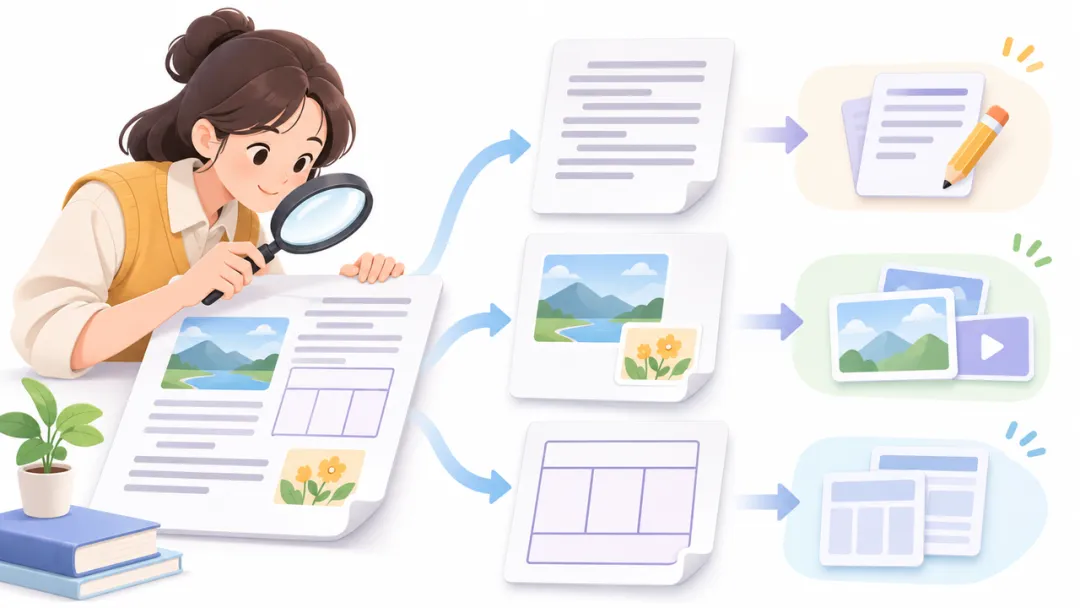
一份双栏报告转成文字后,句子都在,却可能很难辨认哪段属于哪一栏;表格里的数字也还在,但标题、单位和脚注的位置不再直观。接下来让AI写摘要,问题就可能从“识别了多少字”,变成“这些字原本怎样组合”。处理这类文件,值得一起保存可读文字和原始版面依据。
智谱当前的同步解析文档,提供了一个具体例子:Prime-sync既能返回纯文本,也能提供包含图片、Markdown及布局JSON的解析结果下载链接。本文11月15日查阅该文档,讨论如何接收和核对解析产物,不把它说成当天新上线,也没有做识别准确率实测。
纯文本适合读,版面资料帮助定位
纯文本的好处很直接:便于搜索、摘取和送入后续问答。若原文是一份简单通知,主要信息就是连续段落,这样的结果可能已满足初步阅读需要。但材料一旦包含多栏、表格、插图和脚注,只保留一串文字,会丢掉一部分供人检查的线索。
官方介绍的结果包中,Markdown是一种便于阅读的文本组织形式;图片保留图像内容;布局JSON提供版面信息。它们能为后续程序和人工复核提供不同入口,但“有布局信息”不等于每张表格、每个图注都已无误恢复。识别结果仍需要与原文件对照。
例如要整理一份公开年度报告,可以先让应用从解析文本中提取某项指标,同时要求记录原文件名、对应页和所用表格。若结果无法定位,就回到原页检查,再补齐出处。这里的定位要求是工作建议,并非声称接口天然会给每一条结论附完整证据。
接到结果,先打开真正的产物
官方响应示例包含状态、文本内容、任务标识和解析结果链接。接入者需要分别处理这些内容:状态是否成功、文本是否存在、结果包是否能够取回,以及文件能否正常打开。看到请求返回,或看到一个链接字符串,都不能直接替代内容验收。
第一次接入时,可以选一份获准使用、自己熟悉的小文件。先核第一页和末页有没有遗漏,再挑最容易出问题的双栏处、表格处、脚注处检查。检查重点应随用途变化:要写新闻摘要,时间和限定语很重要;要摘取财务或业务指标,单位、列标题和统计范围就必须对应清楚。
文件命名也有帮助。保留原始文件,不用解析结果覆盖它;把结果包与原文件放在可对应的位置,并记录此次处理时间。资料更新后重新解析,要能分清两次版本。这样回头发现摘要有疑问时,才能查清究竟读的是哪一份材料。
同步返回,也有文件和任务范围
官方页面将同步方式描述为一次请求返回结果,适合文件不太大、复杂度适中、需要及时预览或问答的场景。页面列出的大小上限按格式区分:WPS、PDF、DOC、DOCX、PPT、PPTX不超过100MB,MD、TXT、XLS、XLSX、CSV不超过10MB,其他列出的类型不超过20MB。接近上限前先核文件格式,不能只记住最大的那个数字。
超大文件、极复杂版面以及可在后台处理的高并发批量任务,官方建议考虑异步解析。异步方式需要保存任务标识并查询结果,适合让任务在后台继续,而不是要求用户一直等在当前页面。选择时应结合业务等待方式和材料情况,不把“同步”理解成任何大小都能立即处理完。
官方同步页的通用操作文字还出现了轮询描述,与页面产品介绍及同步调用示例不完全一致。因此本文不据此编写逐行接入教程;实际开发要同时核对对应接口参考,遇到行为不一致时确认当前接口契约。对普通使用者,先明确自己需要哪些产物、怎样验收,已经能避免不少交接误会。
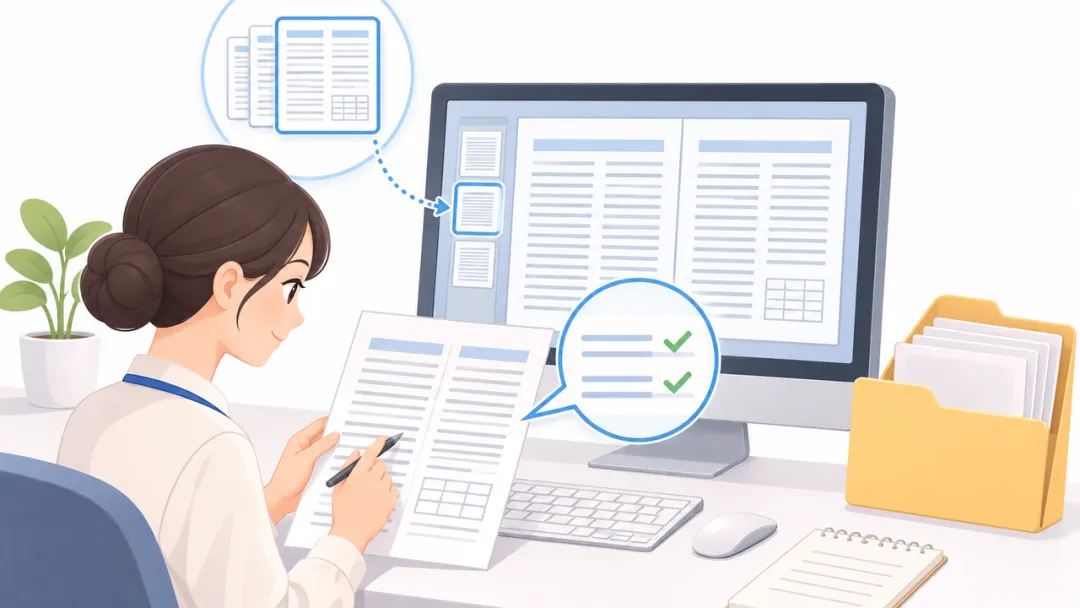
文件解析的交付,可以是一份能读的文字,也可以是一套能继续加工并核对的资料。用途越依赖原来的表格和图文位置,就越值得保留原文件、结果包及两者的对应关系。AI写出的摘要如果回答不了“这句话来自哪里”,就回到原页查清,再把它交给下一位读者。
来源:智谱官方《同步解析》,2026年11月15日查阅。支持格式、产物和容量来自当前文档;本文不引用厂商准确率、速度优势或优惠价格作实测结论,接口文字差异已明确说明。
一起把 AI 用起来
欢迎加入 AI 小毛交流群,交流工具用法,分享实践心得。
微信扫描或长按识别二维码,加入「毛总和他的小伙伴们」,入群以微信页面提示为准。