ARTICLE · 1368488
大模型开发 TLM:文档变语料,训练数据批量产
一、做模型的第一道坎:数据从哪来
做过大模型微调的人都懂:算法和算力往往不是最先卡住你的,数据才是。想微调一个垂直领域模型,手头可能只有几份散乱的文档;想构造指令数据,一条条手写写到怀疑人生;想扩规模,预算和时间都不允许。
更现实的情况是:大量有价值的语料其实早就在公司内部躺着——技术文档、知识库、历史问答,只是它们被锁在 PDF 和 Word 里,从未变成模型能吃进去的格式。
360AI 平台大模型开发 TLM 的「数据合成」模块,就是为这两个问题准备的答案:把存量文档抽出来,把增量数据造出来。
二、一个模块,两条造数路径
在 TLM 的「数据管理」菜单下,「数据合成」页面提供了两个并列的能力入口:数据抽取与数据合成。前者解决「存量激活」,后者解决「增量生产」。
抽取是把已有的文档变成可训练的数据;合成是让模型按你的规则批量生成新数据。一进一出,训练语料的来源问题在平台内闭环解决。
这两个入口与数据广场、我的数据、数据清洗、数据增强、数据回流并列,共同组成 TLM 数据管理的完整工具链。
三、数据抽取:让沉睡的文档开口说话
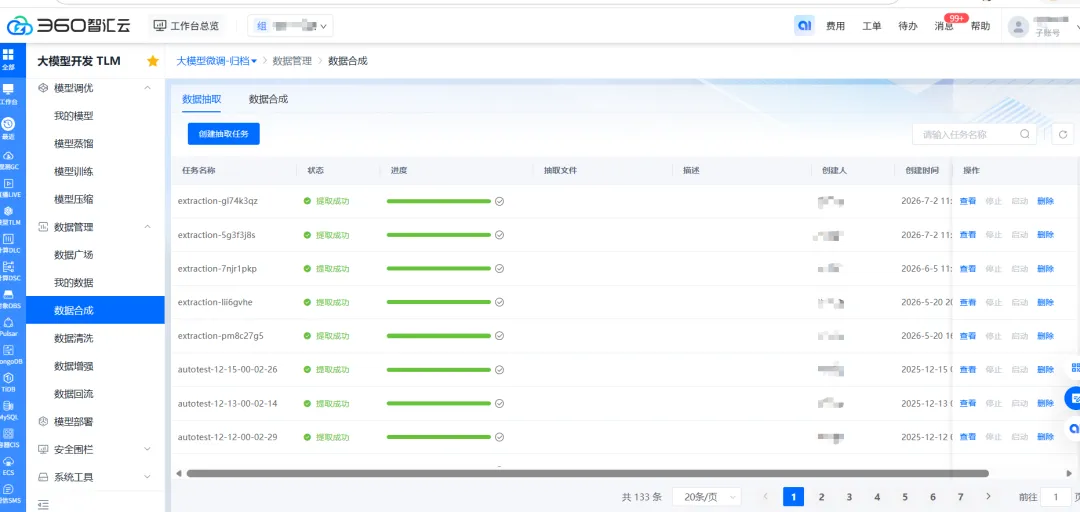
点击「创建抽取任务」,提交待处理的文档文件,平台就会自动完成解析与抽取,把非结构化的文档内容整理成结构化的语料数据。任务列表里,每个任务都清晰记录着任务名称、状态、进度、抽取文件、描述、创建人、创建时间。
状态设计很务实:提取成功与提取失败一目了然,成功的结果可查看,失败的任务可重跑。批量处理几十上百份文档时,你不需要盯屏幕——任务在后台跑,跑完了回来收数据就行。对团队来说,这意味着一条稳定的「文档到语料」流水线已经跑通,你要做的只是把文档丢进去。
四、数据合成:从「一条条写」到「批量产」
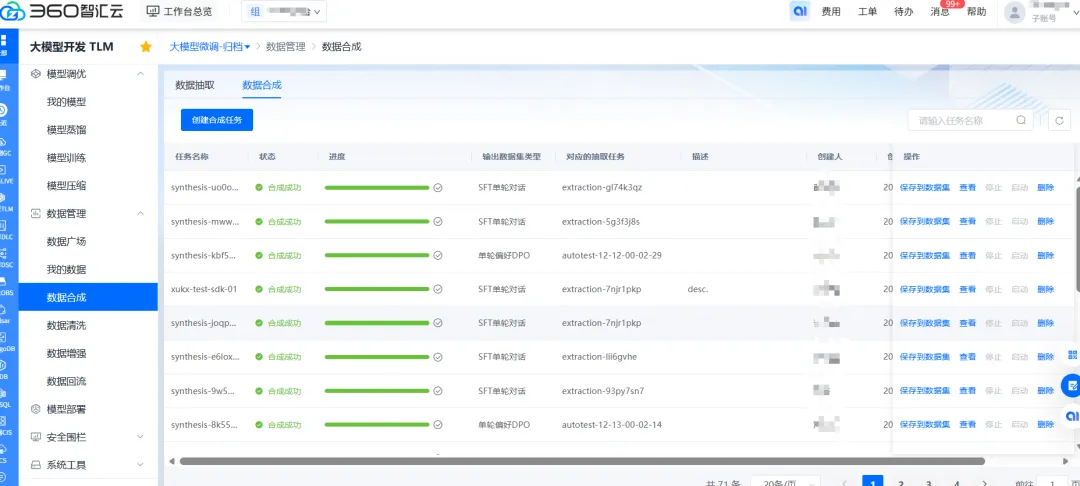
如果说抽取是盘活存量,合成就是创造增量。通过数据合成能力,你可以基于种子数据或指定规则,批量生成符合训练格式要求的语料——指令对、问答对、对话样本,都不再依赖纯手工。
五、任务化管理,造数也有工程范儿
无论是抽取还是合成,平台都用同一套任务化管理思路:每个任务有独立的名称、状态与进度,支持查看、停止、启动、删除全套操作。跑错了可以停,参数变了可以重新启动,历史任务随时回看。
这看似只是管理细节,实际解决的是造数协作中最头疼的问题:谁提的、处理到哪一步、结果在哪里——所有信息都在列表里,团队成员各管各的任务,互不干扰,进度可查。
六、造出来的数据,不落地等于白造
数据合成模块真正的价值,在于它不是一座孤岛。抽取和合成的产出可以直接保存到「我的数据」,进入数据清洗和数据增强环节继续加工,最终供模型训练与模型评测调用:

配合数据回流,线上跑出来的新需求又能变成下一轮合成与抽取的输入。数据飞轮从「造」这个字开始转起来——这才是把造数能力内置进大模型开发平台的意义。
🚀 想体验大模型开发 TLM 的数据合成与抽取能力?
产品使用地址:https://zyun.360.cn/product/tlm
360智汇云是企业智数云底座,以"智-数-云"三大核心底座为支柱,以贯穿全程的 "观测与管控" 为神经中枢,全链路赋能企业数智基建在 "用、运、管、看、维" 五维生命周期中实现价值闭环。提供数据库、中间件、存储、大数据、人工智能、计算等多种产品服务以及一站式解决方案,让每一份IT投入都转化为智能生产力。
官网:https://zyun.360.cn
👇 添加工作人员企业微信,获取更快审核通道 + 产品免费试用包