ARTICLE · 1368627
ChatGPT 在医院软件里起草【全球热点 11.17】
八里奇点 · 全球热点 · 11月17日早间
OpenAI 没有在这一窗发布新的旗舰通用模型,却把电脑操作智能体接到医院已经在用的软件里:它起草医嘱和给患者的回复,官方自己把人工审核和 BAA 写成前提。同一天,8192 颗 Ironwood 在 MLPerf 训练基准上用 1.70 分钟达到 DeepSeek-V3 的目标质量;Vercel 和 Hugging Face 则让私有或开源权重模型走同一套网关与路由。读者该带走的,不是「AI 已经在看病」,而是「谁可以调用、在哪套系统里调用、出了错谁复核」正在被写成可执行的产品条款。
今日目录
要闻
#1ChatGPT 在医院软件里起草,官方把人工审核写成前提
#2学术研究者计划:11 月 23 日开放 5 万份 Plus,目标 20 万
#3Ironwood:8192 颗芯片 1.70 分钟达到 DeepSeek-V3 目标质量
#4嵌入式评估:四家机构获准看内部对象,结论还没出来
开源与开发者
#5Vercel AI Gateway 上线 Private Inference
#6Hugging Face 语言模型推理改走 OpenRouter 路由
#7vLLM v0.34.0 发布,新增 Mistral Large 4 等模型
#8Bedrock:Agentic Retrieve 可接入记忆,让检索记得用户
产品与创业
#9Gemini Notebook 可把资料生成可交互网站
#10Ask Maps 增加行程与预约能力,并扩展到欧洲 30 多国
#11Google Pics 升级到 Nano Banana 2.1
其余信号
#12TOP500 11 月榜:LineShine 以 2.198 Exaflop/s 蝉联第一
OpenAI《More ways to move care forward with ChatGPT for Healthcare》官网分享图(来源 openai.com)
#1ChatGPT 在医院软件里起草,官方把人工审核写成前提
OpenAI 于 11 月 16 日更新既有的 ChatGPT for Healthcare,而不是新发布一个医疗大模型。官网写明三项进展:更强的电脑操作智能体、改进的「可信临床检索」(查找、评估并引用医学证据),以及超过 20 个新的医疗插件。电脑操作智能体被写成在医院已有软件里阅读屏幕、点击、输入,并在应用间跳转,用来处理转诊、在系统间搬运文档、汇总医护所需信息。
演示是医师用语音请助手跟进 MRI 申请,智能体查看病历后起草医嘱和给患者的回复,交人审核。官网点名 Abridge、Ambience、Cigna Healthcare、CVS Health 等机构,已在预授权等流程里使用这类能力。组织需要自行设定可访问的应用,以及哪些步骤必须人工复核。涉及受保护健康信息的 HIPAA 工作流,官网要求使用其 BAA 覆盖的合格服务;官方还写明,通过 ChatGPT for Healthcare 分享的内容不会用于训练模型。中文二手帖里的「325 项评测 / 99% 安全」未在这篇官网正文中核到,不采用。不要写成「AI 已经在自主给病人看病」。
https://openai.com/index/more-ways-to-move-care-forward-with-chatgpt-for-healthcare
https://x.com/OpenAI/status/2122465625109090646
#2学术研究者计划:11 月 23 日开放 5 万份 Plus,目标 20 万
同一天,OpenAI 宣布扩大 ChatGPT for Academic Researchers。该计划 7 月以试点起步;下一轮申请于周一 11 月 23 日开放,将按先到先得向符合条件的研究者发放 5 万份新资助。每份资助覆盖申请人及最多两名合作者的 ChatGPT Plus(不是试点时的 Pro),因此这一轮最多覆盖 15 万人;整个计划的目标是 20 万人。官网写:试点以来已有 33 个国家的 2 万名研究者加入;已在等候名单且符合条件的人,会在申请开放前收到启用说明。默认情况下,该计划中分享的数据不会用于训练模型。
配套研究 *Science at the Frontier: How Scientists Use ChatGPT* 看的是夏季试点中 1800 多名研究者的使用情况。官网表述是:「受访参与者估计,如果没有 AI、要达到同样质量,同样的研究工作会花将近两倍时间。」这是调查里的自评,不要写成对照试验已经证明生产力翻倍。
https://openai.com/index/expanding-chatgpt-for-academic-researchers/
https://x.com/OpenAI/status/2122377585523126615
#3Ironwood:8192 颗芯片 1.70 分钟达到 DeepSeek-V3 目标质量
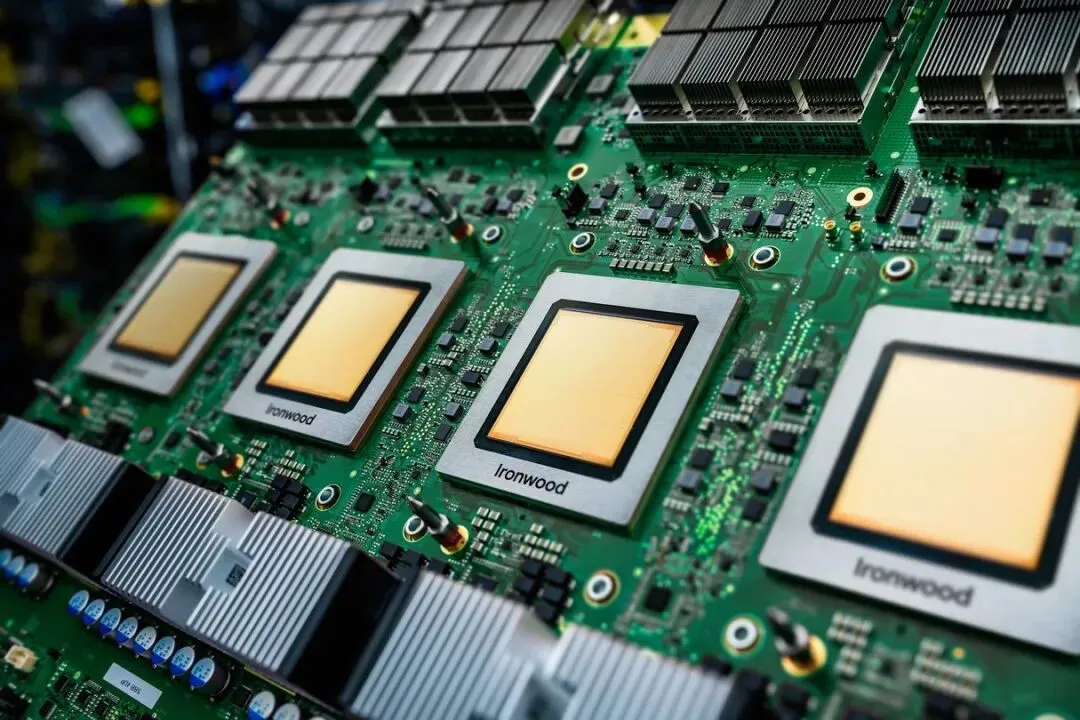
Google Cloud 官方博文中的第七代 Ironwood TPU 板卡照片(来源 blog.google)
Google 于 11 月 16 日发布 MLPerf Training v6.1 成绩博文。文中写明:在 DeepSeek-V3 预训练基准上,8192 颗第七代 Ironwood TPU 用 1.70 分钟达到目标质量(结果编号 6.1-0020;1.70 分钟约合 102 秒)。同一篇文章还写,扩展至 4096 颗芯片时效率为 96%(结果 6.1-0019)。这是闭式分区从官方参考检查点训练到目标收敛标准的耗时,不是某家实验室自己的内部测速,也不能外推成「任意任务都能在两分钟内训完」。
同轮还有智能体强化学习基准:640 颗 Ironwood 用 18.02 分钟达到编码基准的目标精度(0.765,目标为 0.69),官网称训练芯片等待时间低于 3%。Google Cloud 的 A4X Max 实例上,256 颗 NVIDIA GB300 GPU 的预训练基准耗时为 31.96 分钟。数字一律以这篇官方博文和脚注中的结果编号为准。
https://blog.google/innovation-and-ai/infrastructure-and-cloud/google-cloud/training-performance-benchmarks-tpus/
#4嵌入式评估:四家机构获准看内部对象,结论还没出来
OpenAI 11 月 16 日宣布,已与 Apollo Research、METR、Transluce、Goodfire 签署第一阶段嵌入式评估协议。按评估需要,评估方可使用与内部研究者类似的部分资源,包括模型检查点、源代码、训练与评估数据、监控系统、技术文档,以及与相关研究者、工程师的讨论。这是准入深度,不是已经公布的评估结论,也不能写成「已经证明安全」。
官网对四家的分工写得很具体:Apollo 评估模型是否会暗中违背开发者意图、防护能否发现;METR 调查其迄今最大规模强化学习训练中的不对齐行为,并初步同意做更广的监控评估(范围待双方确认);Transluce 评估训练后对齐评测的质量与覆盖,并打算在 2027 年扩大试点;Goodfire 派可解释性研究者进驻,重点是训练过程监控、调试与对齐。外界关于「收购 Goodfire」的传闻与这条合作不是同一件事,本稿不采用。
https://openai.com/index/our-first-phase-of-embedded-assessments
https://x.com/OpenAI/status/2122359930628063248
#5Vercel AI Gateway 上线 Private Inference
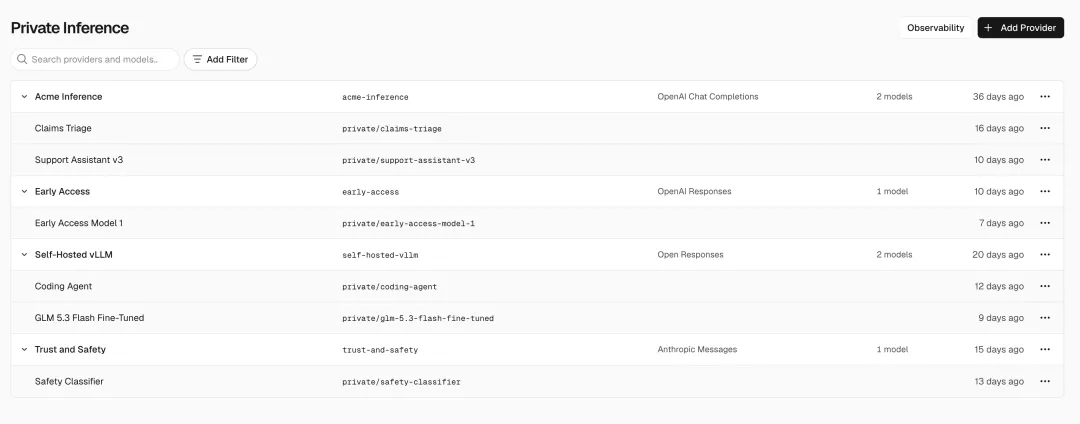
Vercel changelog 中的 Private Inference 界面截图(来源 vercel.com/changelog)
Vercel 于 11 月 16 日在 changelog 宣布,AI Gateway 现在支持 Private Inference:企业可以把微调或自托管模型,和目录里的模型放在同一套 API 密钥下调用。关键标识是 private/<slug>,模型在团队内可见;官网还写了可选的零数据保留(ZDR),以及在私有模型不可用时回退到目录模型。这不是一次新模型发布,开发者要问的是鉴权、日志、回退和数据是否留存。
https://vercel.com/changelog/ai-gateway-now-supports-private-inference
https://x.com/vercel/status/2122457875364864347
#6Hugging Face 语言模型推理改走 OpenRouter 路由
Hugging Face 与 OpenRouter 于 11 月 16 日同时发文:Inference Providers 里的语言模型请求改走 OpenRouter 的路由,按实时价格、速度和可靠性选择提供方,失败则在同一次调用里改试下一家。现有 Hugging Face token 与代码不用改。路由支持 OpenAI Chat Completions / Responses 与 Anthropic Messages。OpenRouter 一文还写,可选择把请求痕迹广播到自己的 Hugging Face Storage Bucket(该功能标为 beta)。文中关于开源权重占比、用量与价格对比的数字,是博文自己的统计,本次未做交叉核对,只作博文口径。
https://huggingface.co/blog/openrouter
https://openrouter.ai/blog/announcements/hugging-face-inference-providers/
https://x.com/huggingface/status/2122393775314264519
#7vLLM v0.34.0 发布,新增 Mistral Large 4 等模型
GitHub 上的 vLLM v0.34.0 发布页标注时间为 2026-11-16T23:22:00Z(新加坡时间 11 月 17 日 07:22)。页上列出的新模型包括 Mistral Large 4、MiniMax-M3.1-Flash、NVIDIA Nemotron-3.5-Transcribe 等。官方账号 @vllm_project 在本窗检索中没有发这条版本公告,因此本稿只按发布页已核对到的模型名单来写;二手帖提到的「可扩展 KV cache 改为默认」「移除 Model Runner V1」等变更,本次未从发布说明开头逐条核对,不写入硬事实。
https://github.com/vllm-project/vllm/releases/tag/v0.34.0
#8Bedrock:Agentic Retrieve 可接入记忆,让检索记得用户
AWS 于 11 月 16 日在机器学习博客发文,介绍如何在 Amazon Bedrock Managed Knowledge Base 的 Agentic Retrieve 上构建「记得用户」的智能体。关键步骤是给 AgenticRetrieveStream 请求加上 memoryConfiguration,让 AgentCore memory 成为与知识库并列的检索来源:同一次调用里恢复会话、在需要时检索长期事实、生成后再把本轮写回记忆;请求还携带 userContext,知识库只返回该用户访问控制列表允许的文档。官网写明这是可选、向后兼容的集成,应用仍需自己完成用户鉴权并传入身份。这是官方技术说明,不是一次新模型发布。
https://aws.amazon.com/blogs/machine-learning/build-memory-aware-ai-agents-with-agentic-retrieve-on-amazon-bedrock-managed-knowledge-base/
#9Gemini Notebook 可把资料生成可交互网站
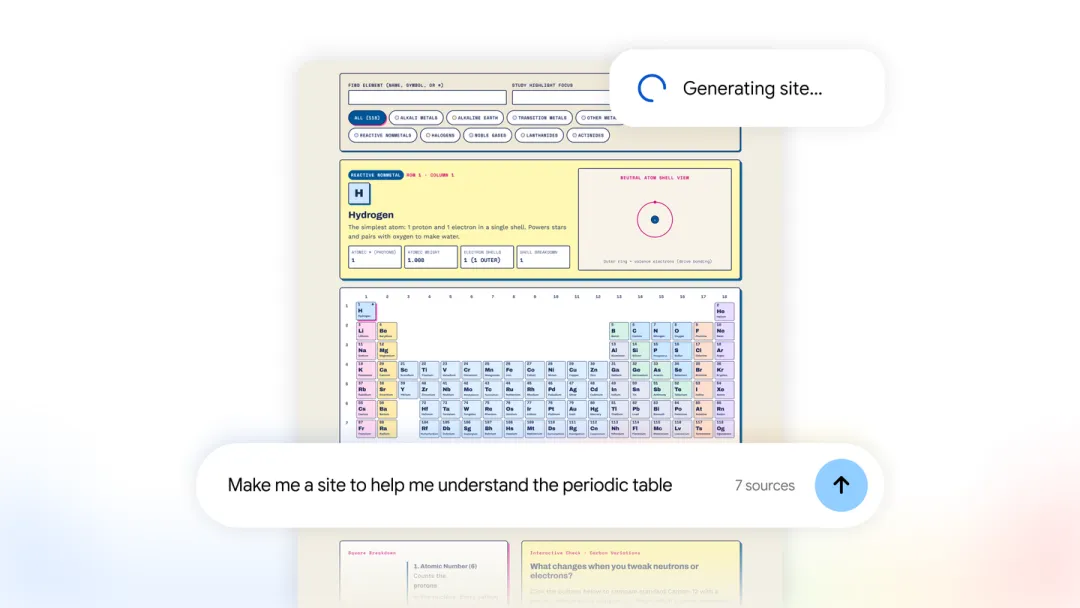
Gemini Notebook 官方博文配图:用一句话把资料生成可交互的元素周期表网站(来源 blog.google)
Google 11 月 16 日宣布,Gemini Notebook 现在可以把资料变成仪表盘、可视化讲解一类的可交互网站;在对话里输入 “make me a site” 加描述,再选择在新标签页打开。官网写明:即日起在 Web 向全球推送,面向 18 岁以上的 Gemini Notebook 用户(含 Google Workspace 订阅者),移动应用即将推出。举例包括交互元素周期表、历史时间线、销售仪表盘和项目进度板。这不是 Gemini 4 Hydrogen 或 Carbon 的首发,只是 Notebook 产品的一项新能力。
https://blog.google/innovation-and-ai/products/gemini-notebook/interactive-sites/
https://x.com/Google/status/2122449668613579018
#10Ask Maps 增加行程与预约能力,并扩展到欧洲 30 多国
同一天,Google 为 Ask Maps 增加假期出行功能,并宣布扩展到欧洲 30 多个国家。官方线程写到的能力包括:自定义多日行程并可导出到 Google Docs;行程中查看路况与营业状态;在已保存列表里搜索并查看空位。其中「出发前提示」(停车、充电、天气、延误、过路费)以及查找美容、宠物、汽车和家庭维修预约、并可代为致电商家,官方标明先在美国提供,不要写成全部功能全球同步上线。「全球覆盖超过 200 个国家与地区」出现在官方原帖,欧洲博文只明确写了「扩展到欧洲 30 多个国家」。
https://blog.google/products-and-platforms/products/maps/ask-maps-holiday-travel-features-2026/
https://blog.google/products-and-platforms/products/maps/ask-maps-is-coming-to-europe/
https://x.com/Google/status/2122430988223451276
#11Google Pics 升级到 Nano Banana 2.1
Google Workspace Updates 于 11 月 16 日宣布,Google Pics 升级到 Nano Banana 2.1,官方列举的变化是更高的视觉质量与真实感、更稳的编辑保真度(更少改动未要求修改的主体、背景或品牌元素),以及更清晰的文字渲染,速度与上一版相当。无论是在 Pics 应用里从零生成,还是在 Docs、Slides 里直接改图,都由这一模型驱动。Rapid Release 与 Scheduled Release 域从 11 月 16 日起全面推送,功能可见需 1 至 3 天。适用范围包括 Business Standard / Plus、Enterprise Standard / Plus,以及消费者侧的 Google AI Plus、Pro 和 Ultra 等,以公告名单为准。这是一次模型升级,不是新应用首发。
https://workspaceupdates.googleblog.com/2026/11/google-pics-upgrades-to-nano-banana-21-for-higher-quality-image-generation-and-editing.html
#12TOP500 11 月榜:LineShine 以 2.198 Exaflop/s 蝉联第一
第 68 期 TOP500 名单于 11 月 16 日在芝加哥 SC26 公布。官方新闻稿写明:自 6 月一版以来,前十名名次完全没有变化。LineShine(国内报道多写「灵晟」)仍以 High Performance Linpack 2.198 Exaflop/s 排在第一,安装地点为深圳国家超级计算中心。榜单页给出的规格是 13,789,440 个核心,Rmax 2,198.40 PFlop/s,Rpeak 2,735.82 PFlop/s。本轮只有 27 套新系统进入 TOP500,占 5.4%,官方称为有记录以来最低的新系统更替比例。这是公开科学排名的一次例行更新,不是新的硬件发布会。
https://www.top500.org/news/top500-leadership-holds-steady-new-system-turnover-falls-historic-low/
https://top500.org/lists/top500/list/2026/11/
机会观察
标题用的是「ChatGPT 在医院软件里起草」的点击钩子,更深的一条线是:模型发布可以暂歇,但「谁可以调用、在哪套系统里调用、出了错谁复核」正在被写成产品条款。
1. 先写下「起草」和「人工审核」。 OpenAI 把电脑操作智能体接到 EHR 和支付方门户,同时把 BAA、访问范围和复核步骤写成前提。做医疗、客服或任何受监管工作流的人,可以把「能在已有软件里走完下一步」写成能力,不要写成「已经替人签字」。
2. 网关开始正式接纳「自己的模型」。 Vercel 的 private/<slug>、Hugging Face 把路由交给 OpenRouter,问的都是同一套问题:鉴权、日志、故障转移、数据是否留存。Bedrock 把记忆写成检索来源之一,也是在既有接口上加可选项,而不是换一个聊天演示。
3. 店铺后台有一个具体日历。 Shopify 要求所有调用 Admin API 的公开应用,在 2026 年 11 月 20 日 23:59 ET 前打开 IP 白名单,否则将从 App Store 下架并阻止新安装;既有安装仍可用,补上白名单后会自动重新上架。对应 changelog 日期是 11 月 14 日,本窗是官方开发者账号的截止提醒,不是今天新宣布的政策。另:微软 Ignite 主题演讲于新加坡时间 11 月 18 日 02:00 开始,本窗还没有主题演讲里的产品结论。跨境支付与拒付主题本窗没有新的平台 API 公告,Halro / DisputeDesk 品牌名本次也未取到。
八里奇点 · 全球热点 · 早间速览只收录科技 / AI / 开发者工具 / 供应链与跨境电商 · 草稿箱待发布全球早间简报本窗尚未落盘;依据 09:26 X 简报,并自行补采、核对 OpenAI、Google Cloud / Maps / Notebook / Pics、Vercel、Hugging Face、OpenRouter、AWS Bedrock、vLLM 发布页、TOP500、Shopify changelog;截稿约 2026-11-17 10:25(Asia/Singapore)