ARTICLE · 1377780
Vectorless RAG:长文档里的答案怎么找?
Vectorless RAG:长文档里的答案怎么找?
检索增强生成(RAG)先从资料里找出相关内容,再把它交给大语言模型(LLM)生成答案。常见的向量检索做法是把文档切成文本块,用嵌入模型把每个块转换为向量,并存入向量数据库。
提问时,系统也会把问题转换成向量,找出最相似的前 k 个文本块(top-k),将这些文本作为上下文交给LLM。但是在时间线和交叉引用场景下的准确率会下降,这是为什么呢,该如何解决?
相似的段落,可能来自错误的年份
一家公司的年报往往沿用同一套模板,措辞接近,数据却随年份变化。如果你问的是 2022 财年,2025 财年的相关段落也可能排在前面。模型一旦用错资料,就可能给出主题正确、年份错误的答案。
找到了交叉引用,却漏掉了附录
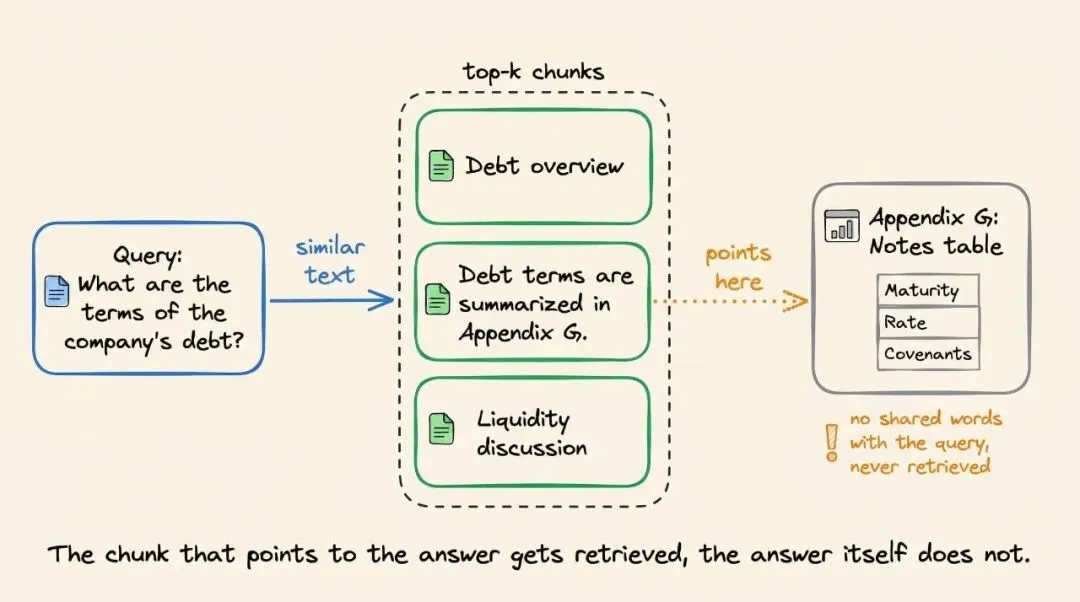
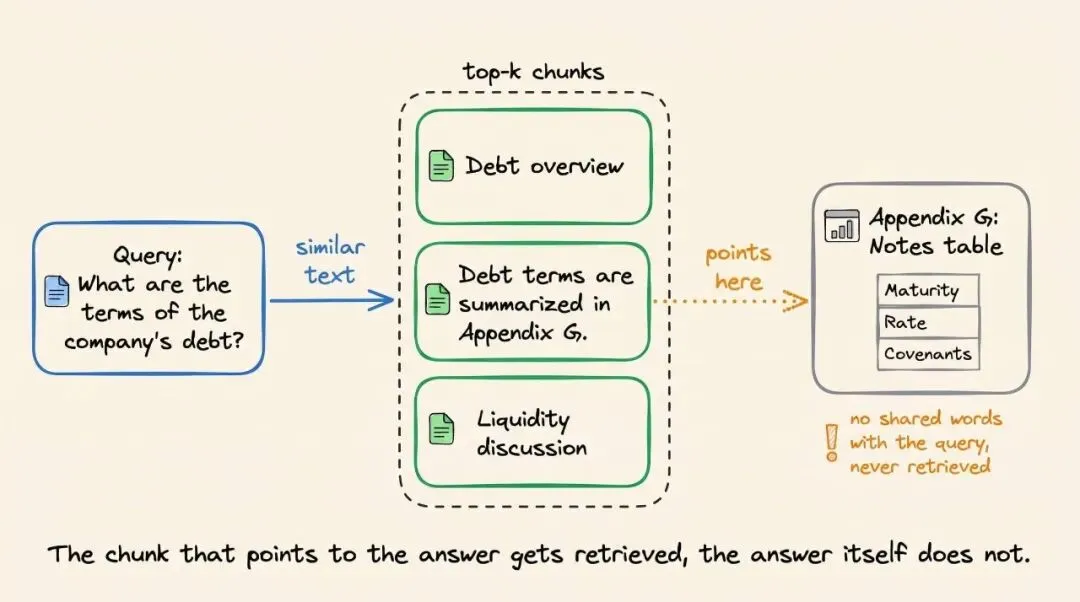
某段正文可能只写着“见附录 G”,真正的数字在附录表格里。表格的文字和问题未必相似,可能排不进前 k 个结果。系统找到了线索,却没找到线索指向的证据,LLM可能会编造数据。
向量检索也可以改进。上下文检索(Contextual Retrieval)先给每个文本块补充它在整篇文档中的背景,再做向量嵌入和 BM25 关键词检索。两种检索方法结合重排序(reranking)后,前 20 个结果的检索失败率从 5.7% 降到 1.9%。
无向量 RAG 怎么找答案?
无向量 RAG(Vectorless RAG)可以利用文档结构来定位证据。以 PageIndex 为例,系统让模型沿着章节层级寻找相关页面。
第一步,建立目录树索引。 系统把文档组织成一棵类似目录的树,节点可以记录章节标题、页码范围和摘要。检索按章节和页码定位,读取时可以保留表格所在页面的上下文。
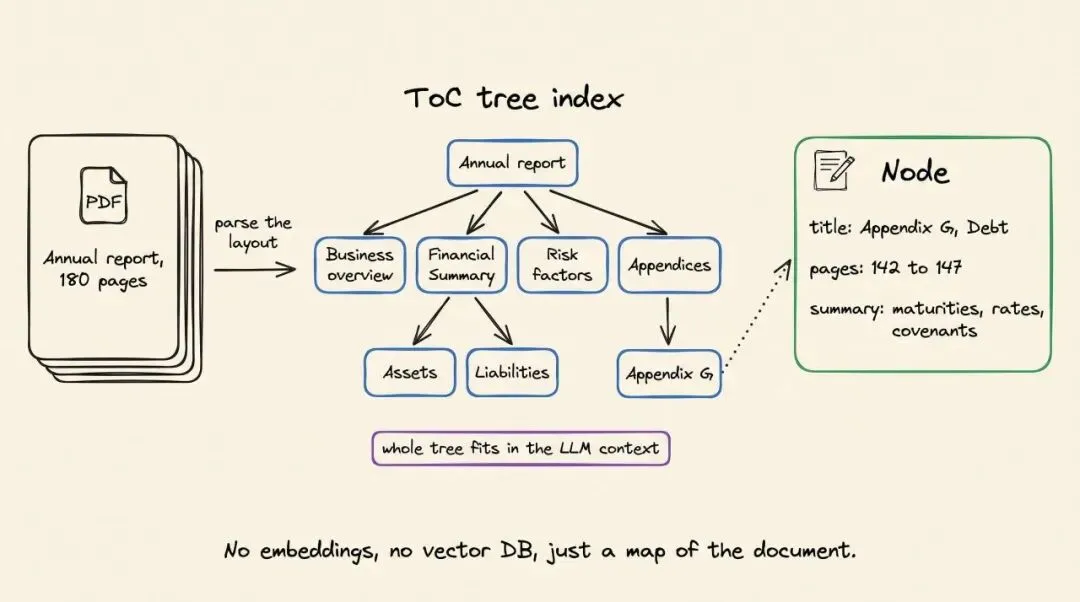
第二步,按问题选择章节。 模型结合问题和目录树,判断哪些章节可能包含答案。例如,回答债务问题时,它可以先看“财务摘要”,再按正文线索查阅附录 G。这类似分析师查阅 Form 10-K(美国上市公司提交的年度报告)时,从目录找到章节,再顺着交叉引用查证。
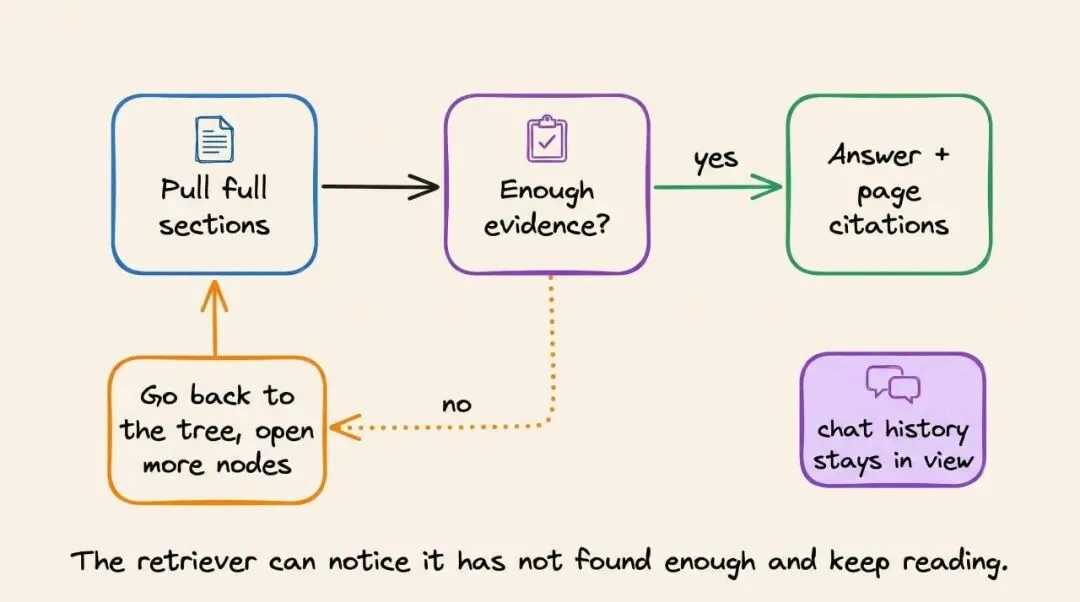
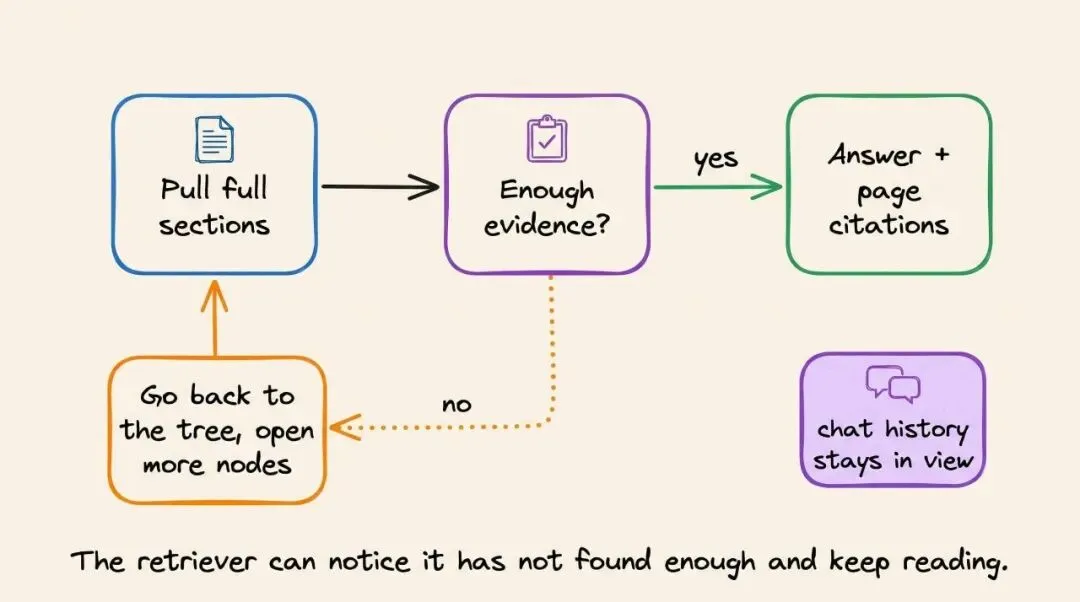
第三步,读原文并检查证据。 系统读取选中的章节或页面。证据足够时,模型根据原文作答,并标明来源页码。证据不足时,可以返回目录树继续查找。对话应用如果保留了同一份报告的上下文,也能处理“那负债呢?”这类追问。
准确率、成本和延迟怎么取舍?
PageIndex目录树方案的核心原理利用文档的章节结构缩小查找范围,再回到原文核对证据。在导入文档时建立目录树索引,记录章节层级和页码范围。索引创建之后,同一份文档可以用来回答多个问题。文档更新时,也要同步更新索引,避免页码和章节对不上。
提问时,模型先根据目录选择可能相关的章节,再读原文取证。比如,合同的付款条款写着“具体比例见附件”,系统就需要接着读取附件,才能给出比例和出处。需要查阅的页面越多、补查的轮次越多,查询通常就越慢,模型开销也越高。
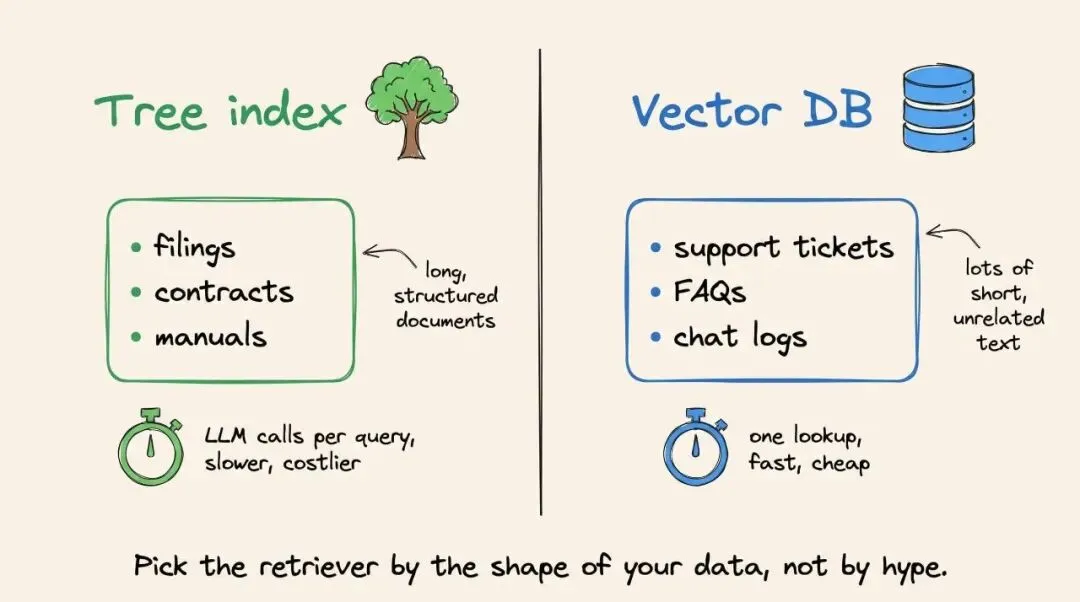
对于年报、合同和手册这类章节清晰、经常需要跨章节查证的长文档,可以先用实际问题验证两件事:PageIndex 能否找到支持答案的页面,以及从提问到拿到带出处的答案需要多久。