ARTICLE · 1386627
智能文档智能体:别让文档只是被识别,而要真正进入业务流程
智能文档智能体:别让文档只是被识别,而要真正进入业务流程企业每天都在处理文档:采购订单、收货单、发票、合同、报告、证明材料…… 问题在于,文档识别出来之后,工作往往还没有结束。 识别结果要录入系统,多个单据要相互核对,缺失字段要补齐,异常情况要交给业务人员判断,最后还要留下可以回查的处理记录。 如果智能体只是把图片转成文字,员工仍然需要复制、粘贴、核对和录入,效率提升就很有限。 智能文档智能体的价值,不是“看懂一张图片”,而是让文档中的信息进入后续业务流程。 下面用一个假设的采购至付款场景展开:企业需要核对采购订单、收货单和发票,确认信息是否一致,再进入后续处理。文中案例为方案说明,不对应真实客户和实际业务规则。 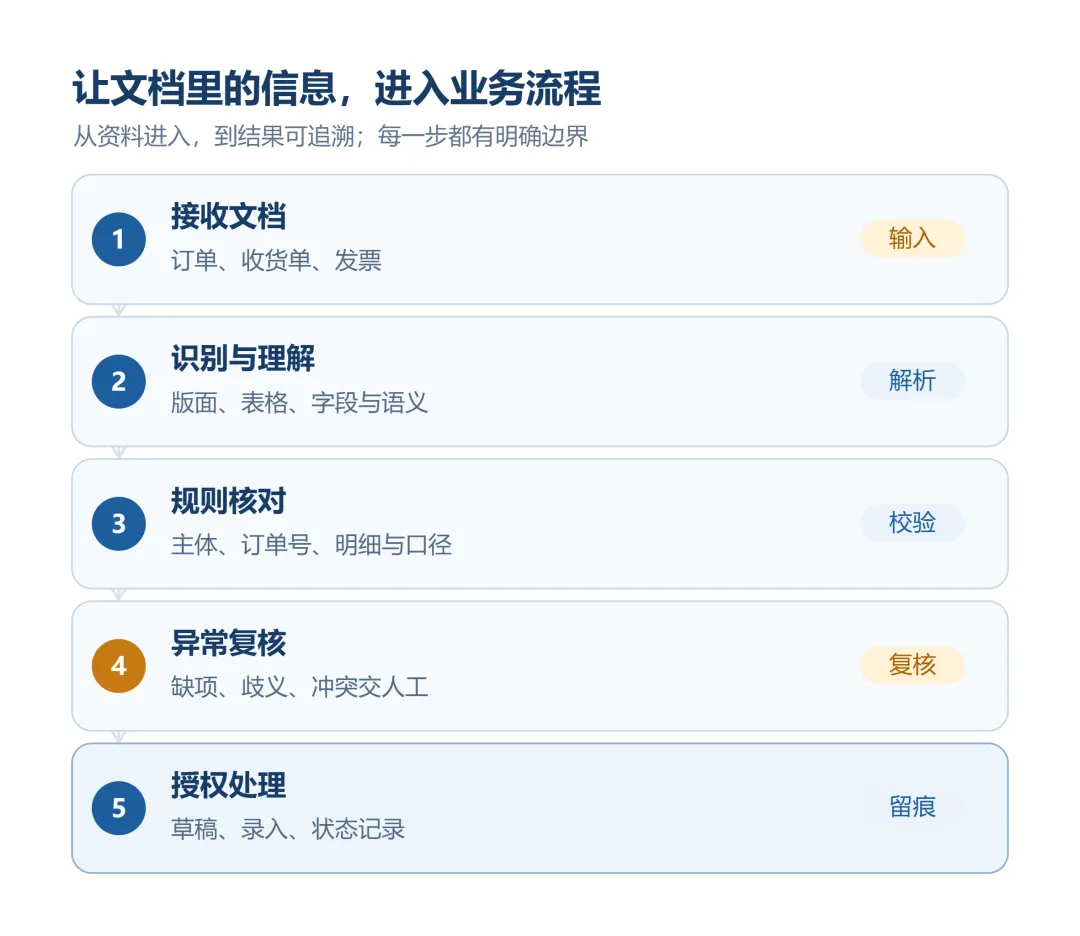
图1|智能文档处理的重点,是从识别结果继续走到规则核对、异常复核和授权处理 采购人员提交订单,仓库形成收货记录,供应商开具发票。 这三类文档可能来自不同系统,也可能以PDF、图片、扫描件或电子表格的形式出现。格式不统一,字段位置也不固定。 系统首先要识别文档类型和基本结构:这是一张采购订单,还是收货单?表格里哪些内容是商品明细?编号、日期、数量、金额分别对应什么字段? 对复杂文档来说,仅靠固定坐标识别容易受到版式变化影响。相同的信息可能出现在不同位置,也可能被放在表格、页眉或附件中。 因此,智能文档处理需要结合图像识别、文档结构理解和语言语义分析,尽量从“内容是什么”出发,而不是只看“它位于哪里”。 但识别出来的字段仍然是候选结果。比如“8”可能是数量,也可能是箱数;“2026-11-17”可能是开票日期,也可能是合同日期。 识别结果需要带着字段含义、来源和置信状态进入后续环节。 传统文档自动化往往需要先收集样本、框选区域、配置模板,再处理版式相似的文件。 这类方式适合结构稳定的单据,但企业的真实文档经常会变化:供应商更换版式,表格增加列,备注位置改变,附件从一页变成多页。 智能文档智能体可以把任务要求说得更接近业务语言: 这句话仍然需要转成字段定义、抽取规则和处理动作,但业务人员无需先理解底层识别参数。 当任务发生变化,也可以调整字段和规则,而不必把每一种版式都重新做成独立模板。 这不代表完全不需要配置。字段映射、业务规则、输出格式和异常处理方式,都需要由业务人员确认。 自然语言降低配置门槛,业务规则决定处理边界。 回到采购场景。企业需要核对三类信息: 如果只比较三张单据的总金额,可能遗漏真正的业务差异:订单有十件,实际只收到了八件;发票把两种商品合并开具;供应商名称略有差异;同一个订单分批收货、分次开票。 因此,三单匹配通常需要先建立关联键,再按字段和业务规则逐层核对。例如订单号、供应商、商品、数量、价格和税务信息,都可能参与判断。 还要提前明确部分收货、分次开票、退货、折扣和价格变更如何处理。这些不是模型凭语言能力就能推断出来的内容。 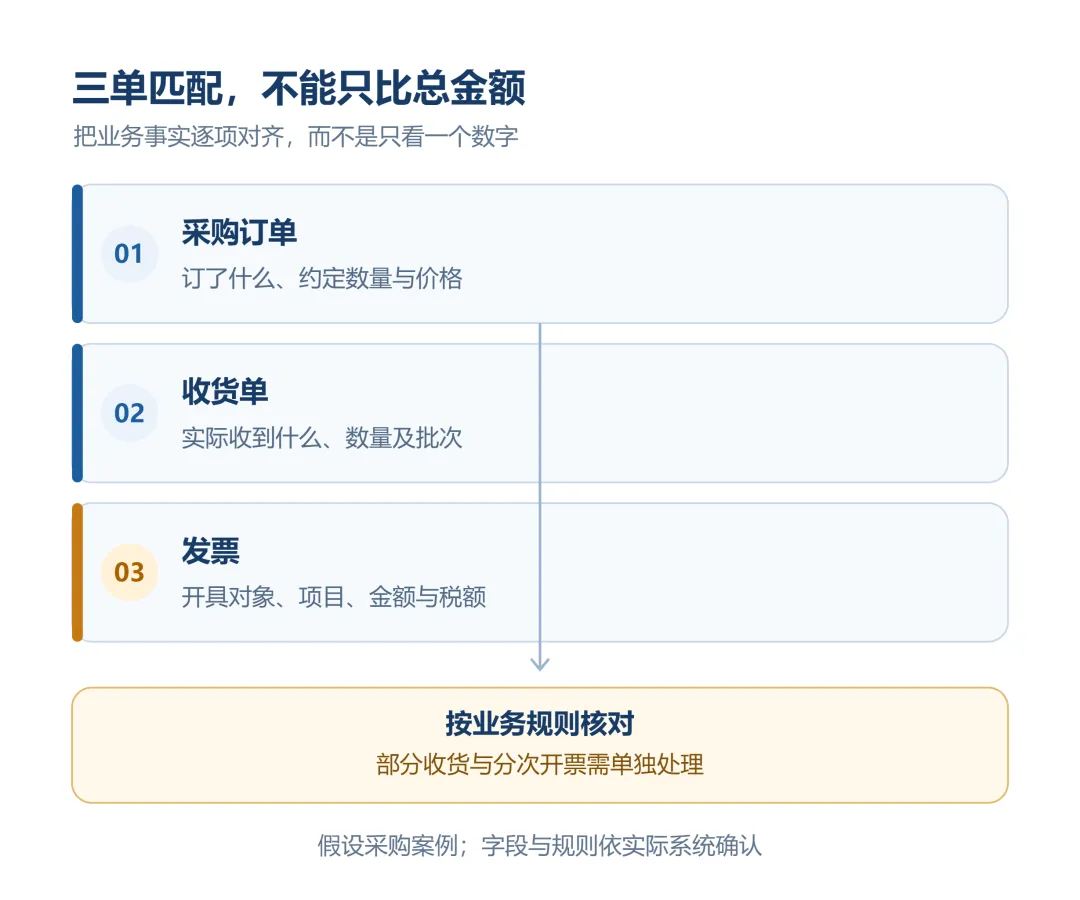
图2|三单匹配不是简单比较总金额,必须结合关联字段、明细粒度和业务规则 文档中识别出“供应商名称”和“金额”,不等于这些值可以直接进入财务系统。 可以从四个层面做校验: 单据编号、日期、供应商、商品明细等关键字段是否缺失?如果缺失,系统应明确列出缺项,而不是用空值或上下文猜测替代。 日期、数量、金额和税率是否符合格式要求?金额中的逗号、小数点和负号是否被正确识别? 数量乘以单价是否与金额关系合理?发票日期是否早于订单日期?收货数量是否超过订单数量? 三张单据的供应商、订单号、商品和金额是否能关联?名称不完全一致时,是简称差异,还是实际主体不同? 校验规则要能解释发现了什么差异、依据是什么、下一步需要谁确认。 模型负责提出识别结果,规则负责检查一致性,业务人员负责处理无法自动判断的情况。 智能文档项目容易出现一种误区:希望所有单据都自动处理,所有差异都自动解决。 但在真实业务里,异常本身就是有价值的信息。 例如: 系统发现差异后,不应直接修改源文件或替业务人员做最终决定,而应给出异常类型、相关字段、原文位置和待确认事项。 业务人员核实后,可以补充资料、修正字段或确认例外,再重新执行校验。 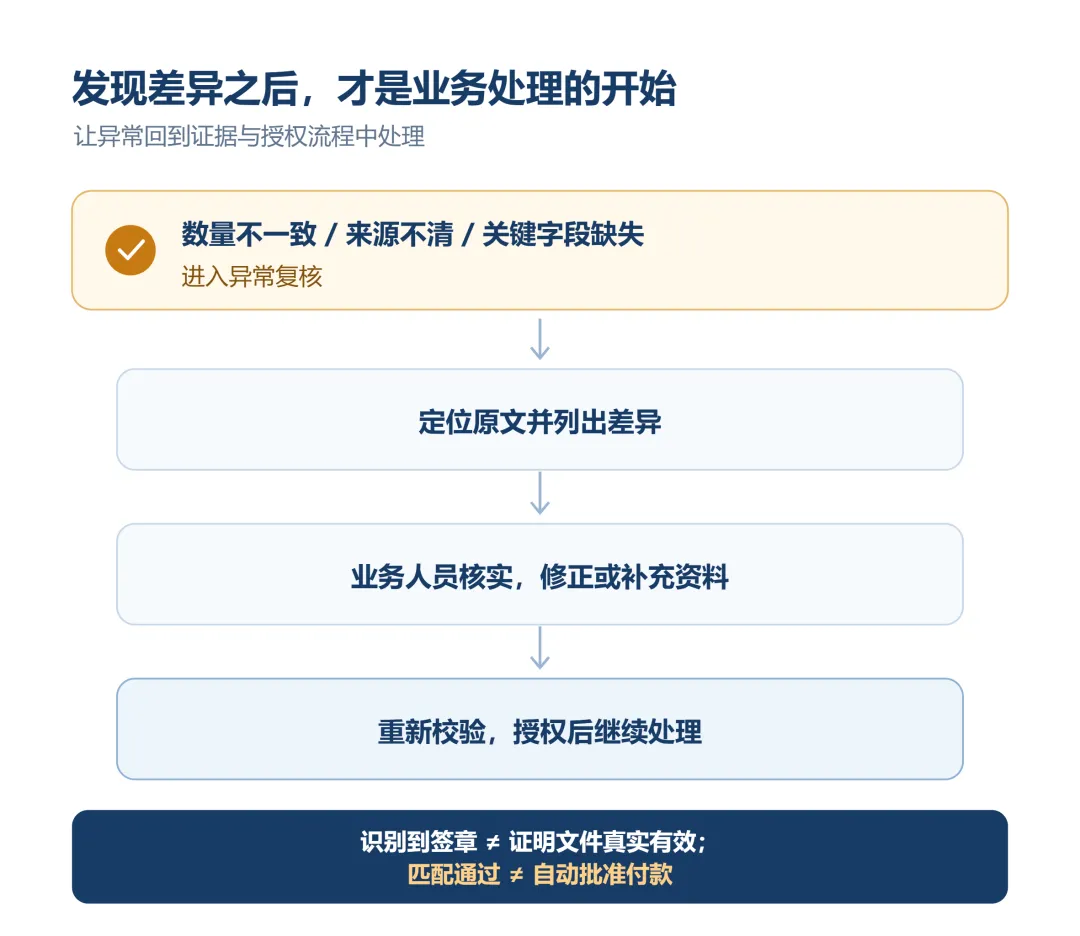
图3|异常处理的关键不是隐藏问题,而是让问题能被定位、核实和继续流转 需要特别区分两件事:识别到签字盖章,不等于证明文件真实有效;三单匹配通过,也不等于系统可以自动批准付款。最终动作要由权限、制度和业务流程决定。 如果识别结果最终要写入采购、仓储、财务或供应链系统,建议同时保留必要的过程信息: 这些记录能帮助业务人员回答几个实际问题:这个金额从哪来?为什么被判定为不一致?谁确认过这项修改?重新上传后,系统依据的是哪一版文件? 文档处理越接近财务、采购和风险业务,过程记录越不能被当成附属功能。 可追溯不是把所有日志都保存下来,而是让关键结果能够回到原始依据和处理动作。 智能文档智能体可以覆盖发票、合同、报告、证件和表格,但项目不宜一开始就承诺“所有文档都能处理”。 更稳妥的方式,是先选择一个资料稳定、规则明确、人工重复度高的场景,例如采购订单、收货单和发票的匹配,完成以下闭环: 验收时,可以准备不同供应商、不同版式、部分收货、分次开票、缺字段和冲突信息等样本,分别测试识别、匹配、异常处理和人工修正。 评价指标也不能只看字段识别率,还要看关键字段准确性、匹配准确性、异常召回情况、人工复核量和错误回溯效率。 企业并不缺少文档,缺少的是把文档信息稳定转成业务数据的能力。 智能文档智能体可以帮助企业处理那些原本需要反复打开文件、复制字段、核对差异、手工录入的工作,把自然语言理解、文档识别、规则校验和系统执行连接起来。 但真正可靠的方案,需要同时回答四个问题: 识别到了什么?依据来自哪里?发现差异后谁来确认?确认之后如何继续流转? 当这四个问题都能在流程里找到答案,智能文档就不再只是“识别工具”,而会成为业务流程中的信息入口。 本文以采购订单、收货单和发票匹配为假设场景,不对应真实客户。具体字段、校验规则、权限范围及自动处理动作,应以企业实际制度和系统配置为准。
01 文档识别只是起点,不是终点
02 从自然语言提出要求,不必先配置一套复杂模板
请从采购订单、收货单和发票中提取供应商、单据编号、商品名称、数量、含税单价和金额,并按订单号进行关联核对。发现缺失或不一致时列出差异,不要自动修改原始数据。
03 三单匹配,不能只比一个总金额
采购订单:订了什么,约定数量、单价和交付条件是什么? 收货单:实际收到了什么,数量、批次和日期如何记录? 发票:开具对象、商品项目、数量、金额和税额是什么?
04 抽取字段之后,还要做数据校验
字段完整性
格式合法性
跨字段一致性
跨单据一致性
05 异常不是失败,而是流程需要接住的状态
关键字段缺失; 订单号无法匹配; 供应商名称存在歧义; 收货数量与订单数量不一致; 发票项目与订单明细无法对应; 单据中的签字或盖章区域模糊。
06 文档进入系统,还要保留来源与状态
原始文档或可访问的来源; 抽取字段及来源位置; 系统识别结果与人工修正记录; 校验规则和异常原因; 当前处理状态与下一步责任人。
07 先做一个闭环,再扩展到更多文档
接收多种格式的文档; 识别文档类型和关键字段; 建立单据关联关系; 按规则核对明细; 对异常列出差异; 由业务人员确认或修正; 将确认结果带入后续系统或生成草稿; 保留来源和处理记录。
智能文档的终点,是让人少搬运,流程更可靠