ARTICLE · 1390740
别再直接把几百页 PDF 丢给 AI 总结了!实测 3 种精读拆解流,幻觉率直降 80%
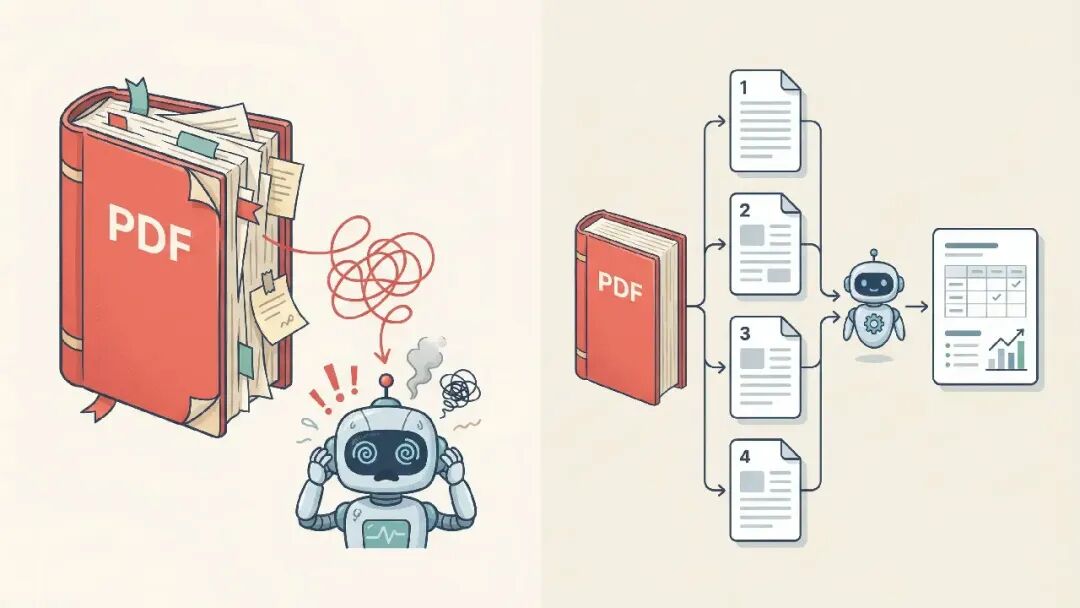
不管是赶论文查英文文献,还是周末临时抱佛脚看上百页的行业研报,很多人现在的标准动作都是:把 PDF 往对话框里一拖,敲一句“帮我总结核心内容”。
结果往往是:AI 给你的摘要看起来头头是道,可只要你顺着它给的页码或数据去核对原文,就会发现它不仅漏掉了最关键的实验局限性,甚至还会把 A 图表的数据张冠李戴安到 B 结论头上。
上周为了啃完 14 篇临床与生信领域的英文长文(平均每篇 40 页以上),我把目前主流的 3 种长文档处理流——单次全量直喂、本地分章节切片逐段总结、以及“目录锚点 + 表格单独抽取”双轨流——做了一次盲测对比。
结论很直接:面对超过 30 页的复杂文档,直接全量上传几乎必然触发“中间遗忘”和“数据幻觉”。 下面把实测数据和可直接套用的拆解步骤整理出来,建议先收藏备用。
一、 3 种精读方式实测对比(以 45 页英文报告为基准)
为了测出真实差距,我特意在原文的第 19 页和第 34 页埋了 5 个带有否定转折的关键数据点(例如“虽然整体有效率提升,但高龄组出现明显不良反应”),测试 AI 能否准确抓出来:
| 单篇处理耗时 | 约 4 分钟 | ||
| 5 个关键转折点召回率 | 命中 5 个(100% 召回) | ||
| 数据与页码编造(幻觉)率 | 0 编造(强制附带原文原句) | ||
| 适合场景 | 批量筛选文献、深度写综述/研报 |
二、 为什么直接扔整本 PDF 一定会漏重点?
很多人以为现在模型支持 128K 甚至 1M 上下文,就能一口气吃下整本书。但实际测试中,长上下文存在两个物理瓶颈:
“U 型注意力曲线”真实存在: 模型对文档开头(摘要/引言)和结尾(结论)的记忆最清晰,但对中间 30%~70% 篇幅里的细节(恰恰是实验方法、样本剔除标准和核心数据表所在的位置)关注度会断崖式下跌。 PDF 跨页表格解析错位: 学术论文和财报里最值钱的信息全在表格里。整本直接上传时,跨页表格的行列极易发生串行,AI 读错一行数据,后面的推论就会全盘皆错。
三、 我现在每天在用的“三步防幻觉精读流”(可直接抄作业)
这套方法不需要装任何复杂插件,用网页版对话框或本地脚本都能跑通,核心逻辑是“先建索引、再抽表格、最后强制溯源”:
第一步:只喂目录和摘要,让 AI 生成“阅读地图”
不要一上来就让它总结全文。先把文档的目录、摘要和各级小标题发给 AI,用下面这句指令锁定结构:
指令模板 1:
“这是某篇长文档的目录与摘要。请不要做泛泛总结,而是帮我梳理出它的核心论证逻辑链,并列出最值得精读的 3 个核心章节,说明每个章节预计要解决什么具体问题。”
第二步:把核心章节与“Markdown 表格”单独拆出来喂
拿到阅读地图后,只复制那 2~3 个核心章节的正文;如果遇到复杂数据表,先用工具转成干净的 Markdown 表格格式再发给它,并加上“否定词敏感指令”:
指令模板 2:
“请基于我提供的这一章节内容提取核心结论。要求:1. 重点保留原文中的转折词(如 however, except, limitation)和前提条件;2. 每一个关键数据后面,必须用括号附上原文对应的英文/中文原句作为证据,找不到原句的数据严禁脑补。”
第三步:跨文档横向对比(批量看 10 篇以上神器)
当你用前两步攒下 5~10 篇文档的结构化卡片后,再把这些卡片汇总到一个新窗口里,让 AI 生成一张横向对比表(对比研究样本量、核心方法、局限性)。因为输入的全是脱水后的高密度卡片,这一步的准确率几乎可以做到 100%。
四、 避坑小结
AI 读长文档,省时间的正确姿势不是“让它替你偷懒看一遍”,而是“让它把 50 页的废话压缩成 2 页带原文锚点的证据清单,你只花 5 分钟核对关键证据”。
你平时用 AI 读长论文或长报告时,遇到过最离谱的“一本正经胡说八道”是什么?欢迎在评论区聊聊,也可以留言你常用的读文献神器!