ARTICLE · 1393358
ego-lite 浏览器这么火,扒开源码看看它有几斤几两?
前 3 篇我们把美团的 Tabbit 从底座到站点脚本拆了个底朝天——大厂的路子很重,直接拉浏览器源码分支、塞进 19 个私有 C++ 扩展、再打包定制版自动化内核。
最近开源圈另一个叫 ego-lite 的 Agent 浏览器项目(核心包 ego-browser)热度很高。我也把它的文档和源码拉下来逐个过了一遍,看看它到底有几斤几两。
先把底细交代清楚:这项目不是全开源。它的桌面浏览器本体和底层快照采集都是闭源安装包分发,GitHub 上真正放出来的,主要是外面那层 Node.js 驱动层(ego-browser-v2)和配套 Skill 经验包。
但光看这层开源代码,路子和 Tabbit 完全反着来:
Tabbit 是“重底座 + 细粒度工具调用”,而 ego-lite 走的是另一条路:它不让大模型走一步点一下地反复调工具,压根不暴露几十个零散命令,而是直接让 Agent 当场写一段 JavaScript 脚本,在单轮调用里把“填表 + 点击 + 等待 + 抓末尾快照”一口气跑完。
站在我们自己在做的 Agent 浏览器和业务自动化系统视角看,这套路子的优点和硬伤都极其明显——有的防呆细节精巧到拿来就能改我们自己的代码,有的地方踩坑也不少。
这篇加更不搞全功能盘点,只拆它源码里最值得细看的 3 块设计。
一、 走一步点一下烧 Token,还是让 Agent 当场 Coding 跑完多步?
做 Browser Agent 最头疼的开销之一,就是“一步一次往返”:点个输入框等 1 秒,抓一次快照烧 3000 Token,点一下按钮再抓一次快照。一个稍微长点的报销填单流程,光来回传上下文就能耗掉半分钟。
ego-lite 的回答很干脆:把“写几步、等什么、怎么取数”直接交给大模型当场 Coding。它把整个 CLI 入口收成单一的脚本执行器,Agent 提交一段 JS 代码进来,运行时直接用 new AsyncFunction(...) 构造一个支持顶层 await 的函数,在一轮调用里连续跑完多步操作,最后只打印一次末尾 snapshot() 留给下一轮用。
但凡让大模型直接吐多步 JS 代码的人,肯定都遇到过同一个噩梦:代码稍微一长,大模型自己就会写出各种低级语法错或上下文混用错,报错信息如果含糊,模型下一轮只会原地打转。
翻开 run.ts、page-context-guard.ts 和 output-sink.ts,能看到它围绕“既然敢让 AI 当场写代码,怎么接住它写崩的烂摊子”,做了三层很省钱的防呆护栏:
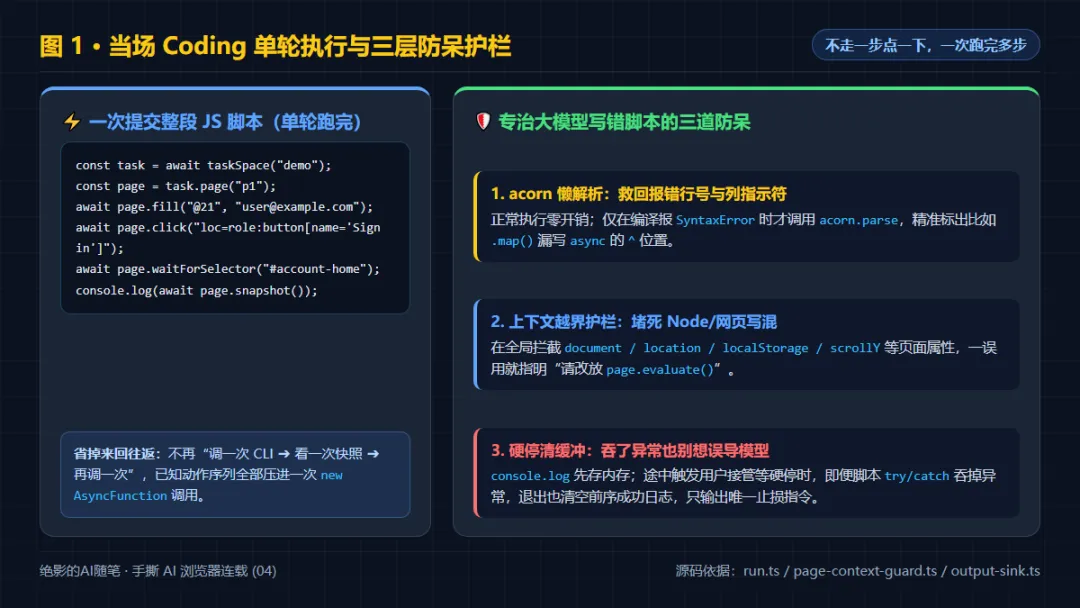
▲ 图1:Code-based 单轮执行与三层低成本防呆护栏
1. 编译报错时懒解析语法树,把丢掉的行列号救回来
JS 引擎原生的 new AsyncFunction(...) 有个老毛病:一旦里面有语法错误,抛出来的 SyntaxError 往往丢失用户脚本里的真实行号,甚至栈信息直接指向内部虚拟帧。
ego-lite 的处理很讨巧:正常跑脚本时什么额外解析都不做,只在编译失败的 catch 里才懒调用 acorn.parse 过一遍代码,把报错还原成下面这种一眼能定位的格式(摘自源码单测实锤场景:AI 在 .map() 回调里忘了写 async 就直接 await):
// AI 常写的错误脚本:map 回调里忘了加 async const task = await taskSpace(556); const rows = (await task.pages()).map(page => ({ title: await page.title() })); console.log(rows);经过 userScriptSyntaxError() 用 acorn.parse 包装解析后,吐给大模型的报错直接长这样:
Browser script syntax error at line 3, column 57: ... 3 | const rows = (await task.pages()).map(page => ({ title: await page.title() })); ^代码就几十行,但对模型自纠错太实用了——箭头直接指到漏写 async 的那个 await 头上,下一轮马上能改对。
2. 提前堵死“Node 和网页上下文写混”
大模型写自动化脚本,最高频的幻觉之一就是在 Node 脚本顶层直接写 document.body、location.href 或者 window.scrollY。
page-context-guard.ts 直接在全局作用域给 document、localStorage、sessionStorage、scrollX、scrollY 等 8 个页面专用全局变量埋了 getter 拦截(外加对 window 的错误增强),只要模型在脚本外层一碰它们,立刻抛出带明确修复指引的报错:
ReferenceError: document is not defined. The heredoc runs in Node.js, not in the Page. document is a Page global. Put browser-side code inside page.evaluate(), for example page.evaluate(() => ...); keep Node.js work outside it.不靠大段 Prompt 反复叮嘱,直接在报错点告诉它“你现在在 Node 里,去放进 page.evaluate()”,比写十句系统提示词管用。
3. 遇到人类接管,哪怕脚本 try/catch 吞了异常也强制清场
多步脚本还有个隐蔽坑:假设脚本跑到第 6 步,用户突然点进页面接管了控制权(触发 EGO_TASK_SPACE_USER_IN_CONTROL),如果脚本前面已经打印了 20 行“已填完金额”“已选好科目”的 console.log,甚至脚本里还包了一层 try/catch,流式输出就会让模型既看到前面一串成功日志,又看到一句模糊报错,很容易误判任务成功。
output-sink.ts 的处理很果断:脚本执行期所有 console.log 全部先攒在内存数组里不往外吐;一旦途中任何一步触发了“用户接管”或“任务空间失效”这种硬停(Hard Stop),即使被脚本里的 try/catch 吞掉了,退出时 flushSink() 也会把前面攒的所有业务日志全部丢弃,只输出唯一一条规范化的止损指引。
二、 最贴近业务自动化的三道动作边界:不重放、不傻等、不卡死
平时在财税、网银或者 ERP 业务网页里做自动化,最怕的其实不是复杂逻辑,而是三种极其日常的现场事故:
1. 重复提交:点击“提交”后页面刚好切了子 frame,驱动误以为失败重放一次点击,直接提交两遍;
2. 死等超时:选择器写错或者按钮改名了,自动化框架在已经完全静止的页面上傻等满 3~10 秒才报错;
3. 原生弹窗卡死:误点了一个隐形上传按钮,桌面系统弹出原生文件选择框,整个浏览器线程直接卡死在操作系统弹窗上。
翻完 page-model.ts,ego-lite 在这三件事上的工程处理非常老道:
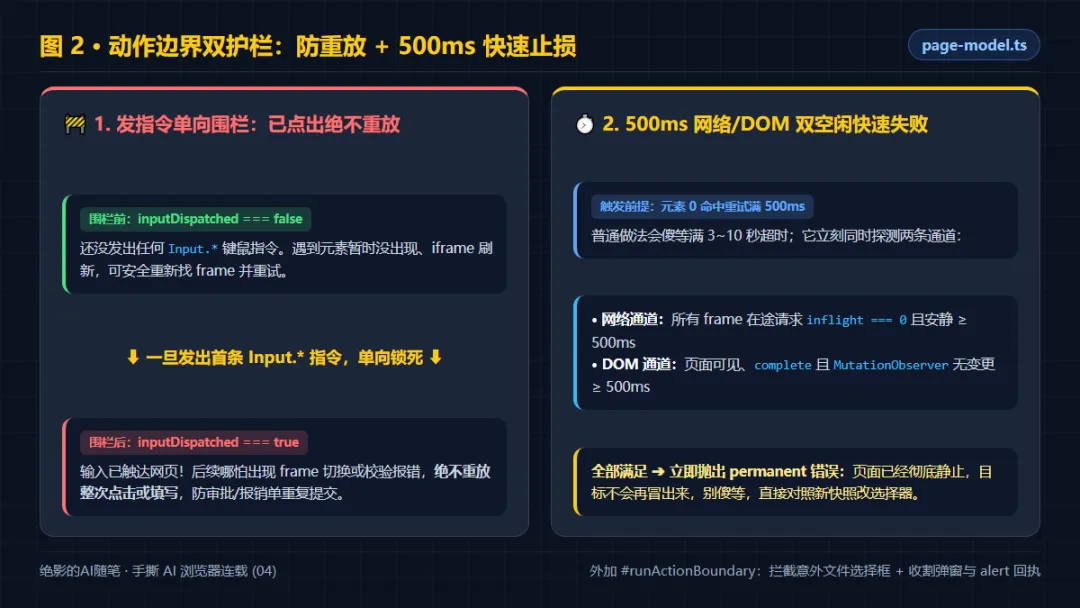
▲ 图2:动作边界双护栏——发指令单向围栏 + 500ms 网络/DOM 双空闲快速失败
1. 发指令单向围栏:只要点出去了,绝不重放
在 #retryElementAction 里,它通过一层包装器拦截所有发往浏览器底层的指令,只要看到任意一条 Input.*(真实鼠标或键盘输入)指令发出去了,立刻把 inputDispatched 标志置为 true。
围栏前(!inputDispatched):还没真正点下去之前,碰到节点临时没找到、iframe 刷新了,可以安全地重新找 frame、重新解析元素并重试;
围栏后(inputDispatched === true):只要键盘或鼠标指令已经触达网页,后面哪怕报了 frame 切换或结果校验异常,绝对不允许把整次点击或输入重放一遍。
这个思路和我们自己在做业务自动化时坚守的“取消等待后必须保留状态未知,绝不自动重试未知写入”完全一致,而且它直接在底层输入派发口卡死了开关。
2. 500ms 网络/DOM 双空闲快速失败
以前自动化工具最浪费时间的地方,就是写错一个选择器,页面明明早就渲染完一动不动了,执行器还在那每隔 50ms 轮询一次,直到耗满 3 秒甚至 10 秒才报超时。
ego-lite 在 #idleWithoutTarget 里做了一个很精准的 500ms 快速失败门槛:当一个元素找了超过 500ms 还是 0 命中时,它会同时查两项指标:
• 网络层:页面及所有跨源 iframe 均已开启网络追踪,当前在途请求 inflight === 0,且距离最后一次网络活动已经过去至少 500ms;
• DOM 层:通过注入页面的 MutationObserver 探针确认页面处于 complete 且可见状态、没有正在加载的同源 iframe,且距离最后一次 DOM 变更也已超过 500ms。
只有这两边全部安静超过 500ms,才直接抛出一个 permanent 类型的错误,明确告诉模型:“页面在途请求和 DOM 变化都已经停了 500ms 以上,这个元素不会自己冒出来了,请对照新快照检查选择器或显式等条件。” 既不会误杀正在异步加载数据的慢页面,又能在写错选择器时半秒内止损。
3. 动作边界顺手兜住三种“意外弹窗”
每次页面动作外层都包着统一的 #runActionBoundary,干了三件很贴近桌面实战的脏活:
① 防原生文件框卡死:如果脚本没提前声明要上传文件,点击前它会自动在页面和浏览器层埋好隐式拦截探针;一旦普通点击意外拉起了系统文件选择框,立刻自动传空取消原生系统弹窗,并报错引导改用专用上传接口,绝不让操作系统弹窗把自动化挂死;
② 边界同步收割新标签:点击后发一次极轻量的 Runtime.evaluate("0"),利用浏览器事件保序特性把刚才那一下点出来的新标签页即时收进回执(没及时处理的话,脚本结束末尾还会打一段 [ego-browser:pages] 提醒);
③ JS 原生弹窗转正常回执:点击期间如果触发了 alert / confirm / prompt,底层立刻中断挂起的渲染器指令,外层把它包成正常的 { dialog: ... } 对象返回,不让脚本直接崩溃。
三、 对比美团 Tabbit:哪些值得直接抄,哪些千万别学?
把这 4 篇连起来看,Tabbit 和 ego-lite 刚好站在 Browser Agent 的两端:
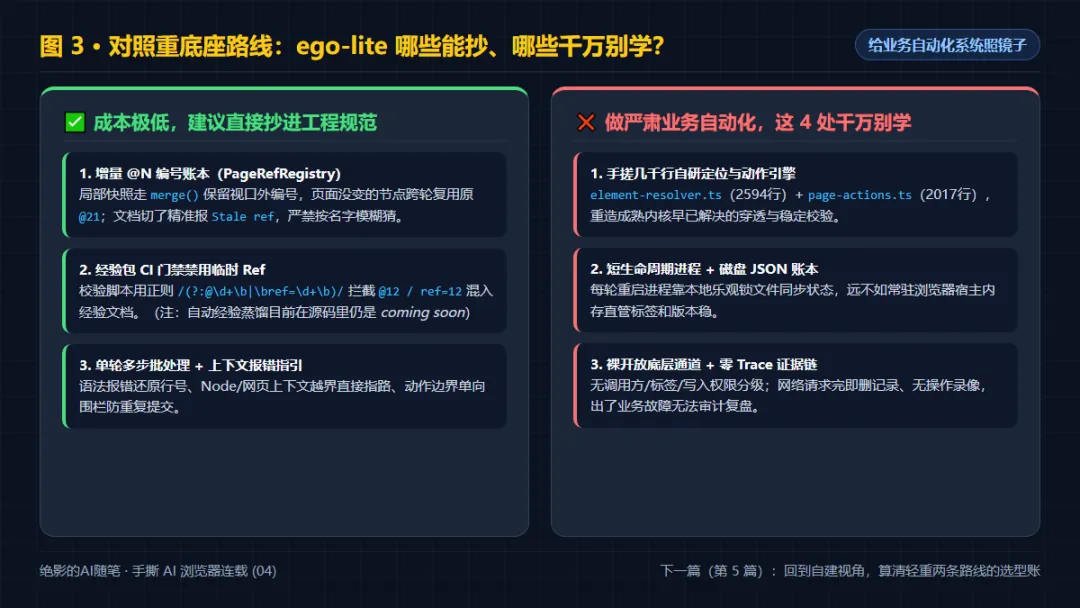
▲ 图3:重原生底座(Tabbit)vs 轻量脚本驱动(ego-lite)工程取舍对照
1. 这两个设计成本极低,建议直接抄进我们自己的项目
• 增量 @N 编号账本(PageRefRegistry):很多轻量工具一抓新快照就把整页编号清空重排,或者只抓局部区域时把旧节点编号冲掉。ego-lite 在 SDK 层按 (frameId, backendNodeId, documentId) 维护映射:抓局部快照时走 merge() 保留视口外已有编号,页面上没变的按钮跨轮次继续复用同一个 @21;一旦某个 frame 发生导航切换,精准把旧编号标记失效并报 Stale ref: @21; take a new snapshot,同时写死禁止按名称模糊瞎猜。
• 经验包里的“禁临时 Ref”校验(rejectTemporaryRefs):ego-lite 的仓库里也带了类似 Tabbit Playbooks 的站点经验包目录 learnings/。老实说,它首页宣传的“自动把成功操作蒸馏成经验包”目前在源码里还写着 (coming soon),仓库里现有的 github、google、x-com 都是开发者手工写的静态文件。但它 CI 校验脚本里有一行正则 /(?:@\d+\b|\bref=\d+\b)/ 写得极清醒——只要发现经验文档或脚本里混进了 @12、ref=12 这类只活一轮的临时编号,直接打回报错。
2. 下面这 4 处毛病,做长期维护的业务自动化千万别学
1. 为了极简依赖,手搓了几千行底层定位与动作引擎:看目录就知道,它的 element-resolver.ts 写了 2594 行、page-actions.ts 2017 行、page-waits.ts 1167 行,全是在裸 CDP 之上从头手写选择器解析、Shadow DOM 穿透、滚动可达性检查和模拟填表。对于成熟自动化内核早就打磨透的脏活,中小团队真没必要自己重造一遍。
2. 短生命周期进程 + 磁盘 JSON 账本同步状态:因为每次跑脚本都是一个独立的短命 Node 进程,它不得不搞一套 PageLedgerStore 在磁盘上用乐观锁版本号文件同步标签页和编号,还要专门写退避重试去防 Windows 杀毒软件和索引服务的文件锁冲突。如果你做的是常驻宿主的桌面端 Agent 浏览器,进程内存里直接管住标签和版本号,延迟和稳定性都要好得多。
3. 裸开放调试与脚本执行通道,缺乏企业级权限边界:它默认允许脚本直接调底层 cdp() 和 page.evaluate(),面向个人极客很好用;但放到企业业务环境里,没有调用方身份、允许操作的标签范围、只读与写入操作分级、以及高危动作的审批边界,是没法直接上生产的。
4. 全仓几乎零 Trace、零证据链:核实过它的网络和事件追踪模块:browser-runtime.ts 里在途请求一旦完成就立刻从内存删掉,不留状态码也不留响应体;全仓没有动作时间线录像,也没有结构化的操作前后状态跃迁记录。真拿这套底座去跑报税、对账或者资金类流程,一旦半路出岔子,事后连一条完整的审计证据链都拿不出来。
到这一篇为止,重原生底座的 Tabbit(第 1~3 篇)和轻量脚本驱动的 ego-lite(第 4 篇)两条完全相反的技术路线就都拆明白了。
下一篇(第 5 篇,也是这个系列的收官篇),我们不再拆别人的源码,直接回到业务落地与自建开发的视角,把这两条路线摆在一起,算一笔最实在的技术选型和改造成本账。
👋 我是绝影
在广州做财税科技一线技术研发,平时琢磨 AI、RPA 和浏览器自动化的实际落地。觉得有参考价值,欢迎点个「关注」或「在看」。