ARTICLE · 1399717
我们做了一个插件,用来管理你的提示词
问题不在于 AI 没干活。活干完之后,没有留下能被复查的东西。
提示词账本 1.2.0 就是为这件事做的。它不是一个更聪明的聊天框,也不是提示词收藏夹,而是一本挂在 DeepSeek Harness 旁边的账:把每一轮对话的输入、动作、文件、结果和验证,留在一个地方。
这篇文章按一条线走:先解决“有没有记录”,再解决“这一轮交付了什么”,最后解决“整段对话怎么复盘、怎么复用”。
01 记录:每一轮自动入库02结果:这一轮交付了什么03证据:完成事项怎么落到文件04会话:整段对话怎么复盘05评分:怎么校准、怎么复用06实现:本地 SQLite 与审计链07版本:1.2.0 更新与边界08适合:谁该用,谁不该用09 上手:安装与回填
这三层是递进的:没有记录,就没有结果;没有结果,就没有证据;没有证据,复盘就退回聊天记录。下面按这个顺序讲。
它自动记下每一轮的提示词、模型、Token、工具 / Skill / MCP 调用、结果、耗时,以及文件变化。
不需要额外开一个网页,也不需要把对话复制到另一个平台。你在 DSH 里正常做事,它在旁边把账记完。
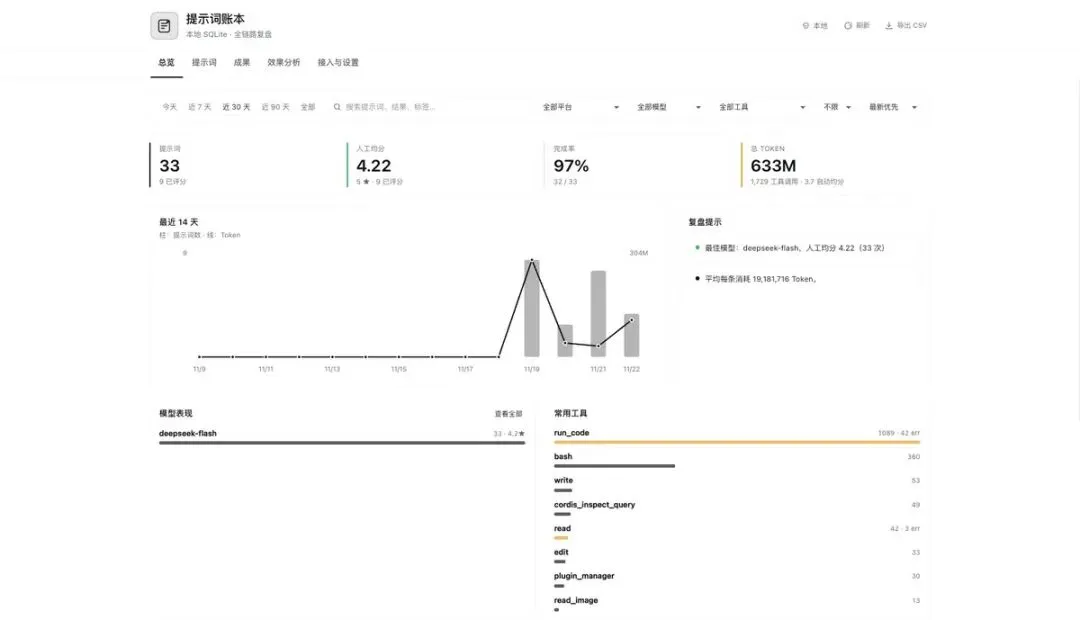
图里看什么
① 顶部四个数:33 条提示词、4.22 人工均分、97% 完成率、633M Token。② 中间折线:最近 14 天的使用节奏。③ 右侧「复盘提示」:最佳模型与平均消耗。
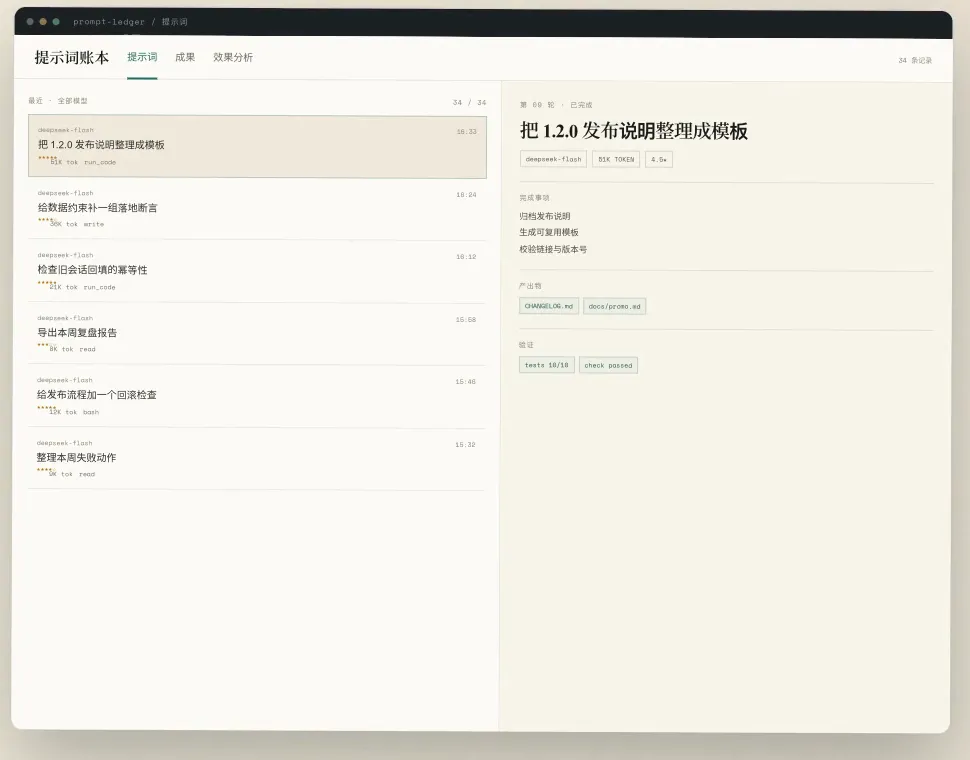
图里看什么
① 左边是每一轮的账:问题、模型、Token、工具、星级。② 右边是这一轮的结果:完成事项、产出物、验证。③ 记录和结果在同一条时间线上,不需要来回翻。
数据只写本地 SQLite。append-only,SHA-256 审计链。没有云端同步,也不把会话正文传到别的服务器。
这句话听起来像技术细节,但它决定了一件事:这份记录,是你的。
记录解决的是“有没有”,但没有回答“这一轮到底交付了什么”。
以前打开一轮对话,先看到的是工具调用:read、write、bash、run_code。它们证明 AI 很忙,但不回答“结果是什么”。
1.2.0 把顺序倒了过来。先给一张结果卡:完成事项、产出物、影响文件、校验、失败动作,以及模型的交付说明。
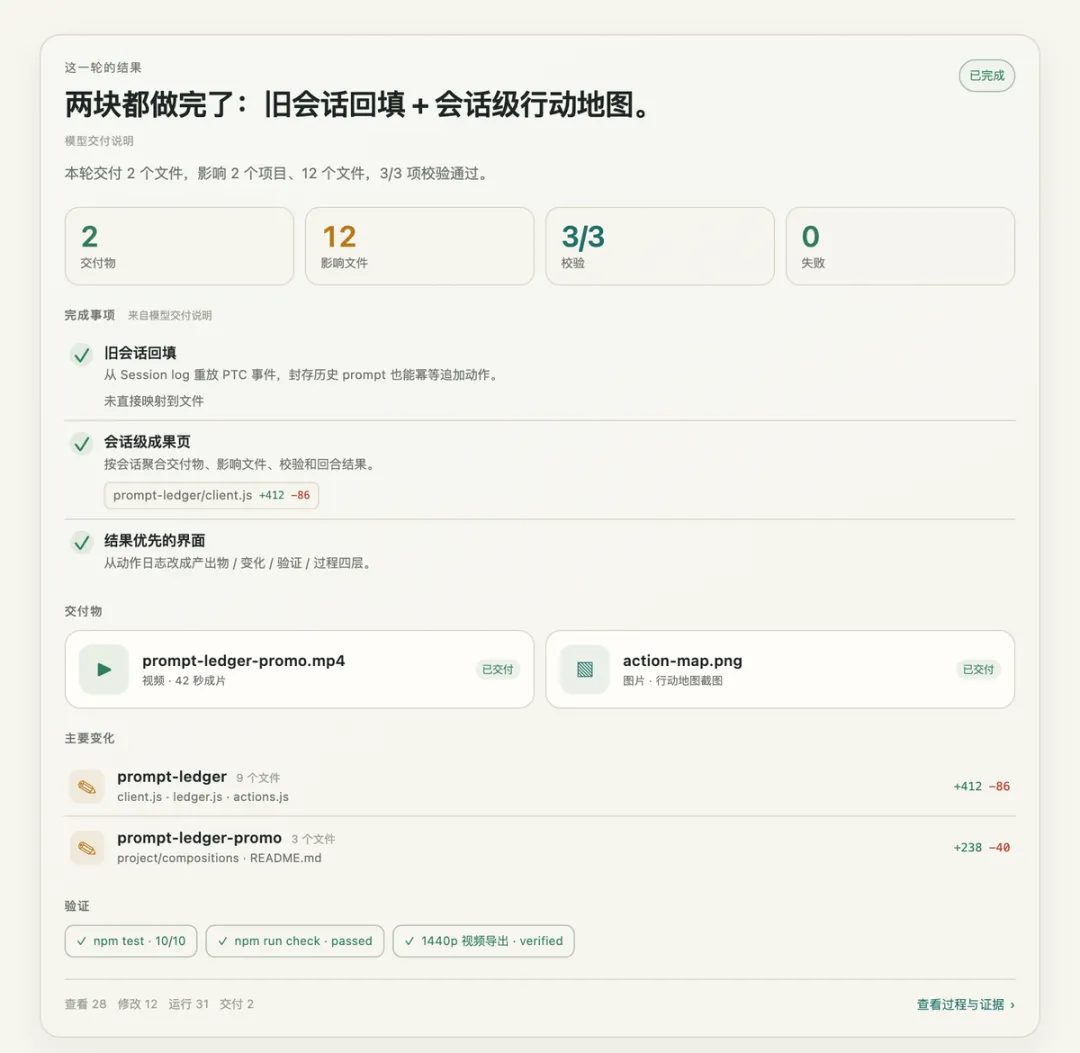
图里看什么
① 四个数字:产出物、影响文件、校验、失败动作。② 完成事项:来自模型交付说明,下面标了来源。③ 产出物:文件卡片,点开能预览。④ 验证:真正跑过的检查,不是模型口头的“已完成”。
示例里的这一轮:2 个产出物,12 个影响文件,3/3 项校验通过,0 个失败动作。下面还有一条一条的完成事项,和它们对应的文件。
完成事项来自模型的交付说明,标了“模型交付说明”;文件变化、校验数字来自事件记录。两者放在一起,但不混为一谈。
如果某个事项找不到直接对应的文件,它会写“未直接映射到文件”。不硬编,也不假装每个结论都有证据。
结果卡告诉你有哪些文件、哪些校验;但你还得能直接点开它们。
结果卡上的文件不是装饰。点一下,图片、视频、PDF、文本和代码可以直接预览;也可以用默认应用打开、在 Finder 中显示、复制路径。
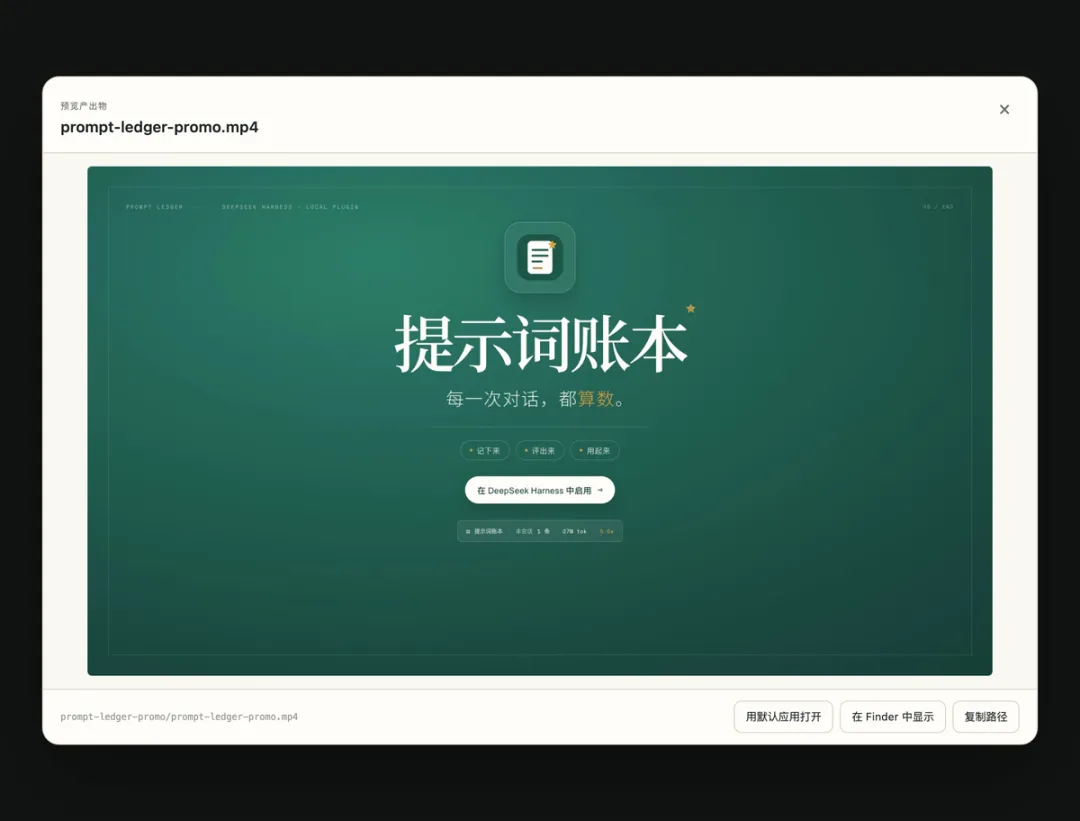
图里看什么
① 左边是完成事项和文件 chip,带 +147 −2 行数。② 右边预览的是文件本身,不是摘要。③ 底部动作:默认应用、Finder、复制路径。
完成事项下面会挂文件 chip,带 +/− 行数。比如“数据要素约束”下面就是 docs/31-data-constraints.md,+147 −2。点开就是文件本身,不是又一段总结。
安全边界也写死在代码里:只允许读取这个 prompt 已经捕获的 action target,精确路径匹配;内嵌预览上限 64 MB,超过就交给默认应用。
单轮能看了。可一个项目往往跨几天、十几轮,又该怎么翻?
单轮结果解决“这一轮做了什么”。但一个项目往往横跨十几轮,文件、校验和失败散在不同回合里。
会话成果页把它们重新聚起来:20 个产出物、16 个影响文件、5/5 项校验、10 个对话回合。每个回合下面是一次完整的“意图 → 完成事项 → 产出物 → 项目变化”。
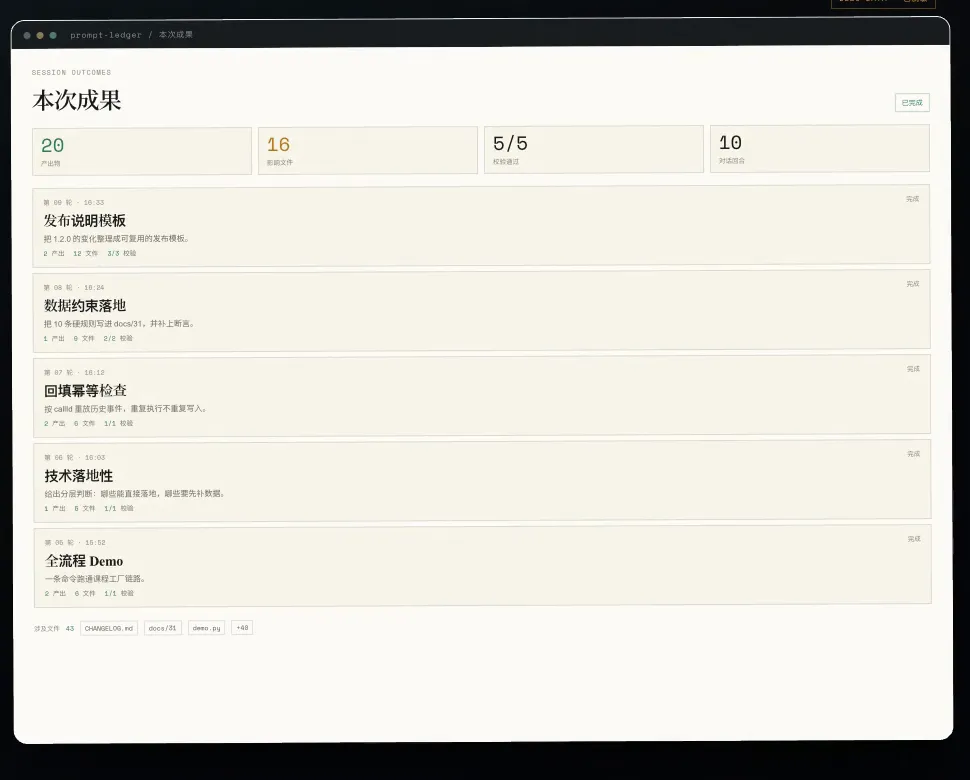
图里看什么
① 四个汇总:20 个产出物、16 个影响文件、5/5 校验、10 个回合。② 每个回合卡片:意图 → 完成事项 → 产出物。③ 底部涉及文件:这一段对话一共碰过哪些文件。
以前的会话没有这些动作记录怎么办?可以回填。它从 durable Session log 重建历史动作,按 callId 幂等写入,不改提示词正文。
这件事听起来不酷,但很实用。你不需要记得是哪一天、哪一轮,翻回去就能接上。
结果留下来了,接下来才是怎么判断好坏、怎么复用。
只有结果,还不够。你还想知道:这类任务,哪个模型更稳?哪种工具组合更值得复用?自动评分和人的判断,差在哪里?
账本支持自动评分 + 人工五星,双评校准,模型 / 工具 / Skill / MCP 多维分析,也能把筛选后的记录导出成 CSV 或 JSON。
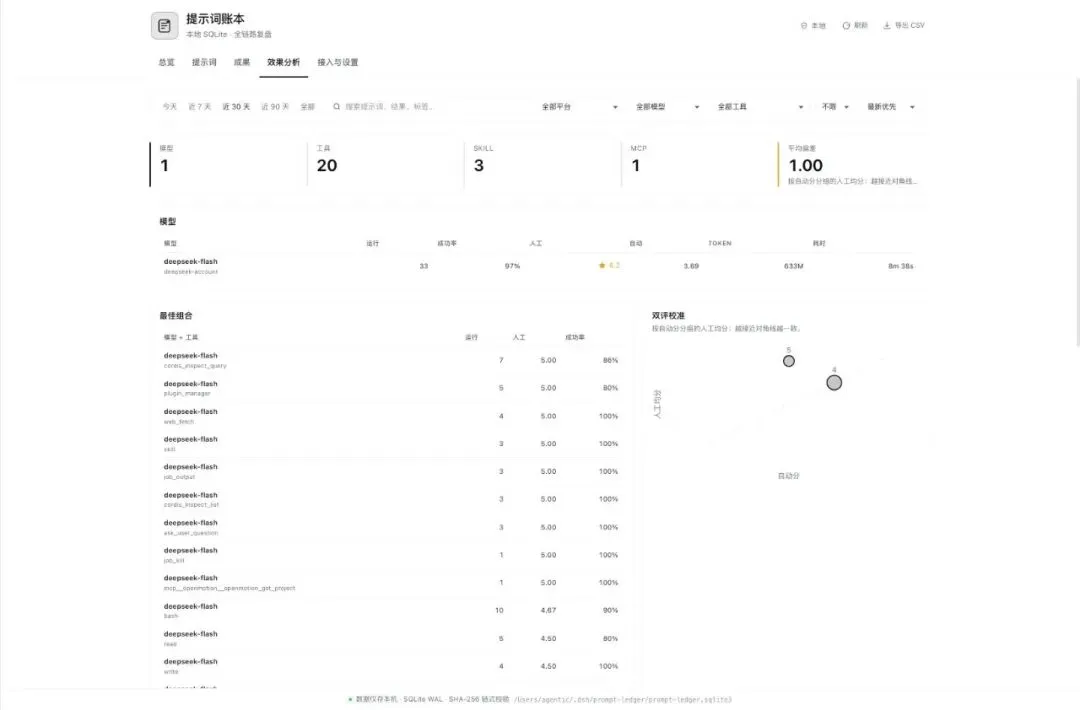
图里看什么
① 左侧:自动评分与人工五星,同一条记录里对照。② 中间:模型 + 工具的最佳组合,按成功率和人工分排序。③ 右侧:双评校准,离对角线越远,自动分和人工分分歧越大。
这些数字不是凭空来的。下面看它怎么工作。
插件监听 DSH 的会话事件,把每一轮写成一条本地的 action_events 记录。append-only,所有变更进 SHA-256 审计链。
记录的内容包括:提示词、模型、Token、工具 / Skill / MCP、结果、耗时、文件 target。写入前会裁掉过长内容、脱敏常见密钥,只保留可核实的摘要。
输入框旁有一条状态行,回合尾部有一行账本。不打断对话,也不要求你额外操作。
它不监控你的屏幕,也不读取 target 之外的本地文件。预览、打开、Finder 定位,都只对已经捕获的文件生效。
结果卡:完成事项、产出物、影响文件、校验、失败动作,一屏看清。
产出物预览:图片、视频、PDF、文本直接打开;支持默认应用、Finder、复制路径。
证据映射:完成事项对到具体文件;没有证据就明确标注。
会话成果页:按回合聚合产出物、影响文件和校验。
旧会话回填:从 Session log 重建历史动作,按 callId 幂等。
状态行 / 回合尾部账本:Token、均分、工具和星级就在聊天旁边。
如果只记一句话:从“它做了什么”,到“它交付了什么”。
适合:每天和 AI 有十几轮以上协作的人;一次任务会改很多文件的人;需要向同事、客户交代“到底产出了什么”的人;希望数据留在本机的人。
不适合:只需要一个聊天窗口、不需要复盘的人;一定要团队云同步的人;不愿意装本地插件的人。
它也有明显的限制:完成事项仍依赖模型交付说明;证据映射按链接/路径匹配,找不到就标未映射;视频 / PDF 预览取决于浏览器。它不替你判断对错,只把可核实的东西摆出来。
它现在是本地单机,团队协作和云同步还没做。这是边界,不藏着。
在 GitHub 下载 1.2.0 的 zip,解压后用 plugin_manager install_bundle 指向解压目录,完全退出并重新打开 DSH。历史会话到「成果」页点「补齐历史」。
它不一定适合所有人。但如果它帮你留下过一次结果、一个文件、一次验证,那它就值了。
每一次对话,都算数。
提示词账本 · 本地优先的 AI 对话账本GitHub:redogcc/prompt-ledger