ARTICLE · 1030661
AI 每日早报 2026年9月18日 星期五
AI 每日早报 2026年9月18日 星期五🤖 AI 每日早报 2026年9月18日 星期五 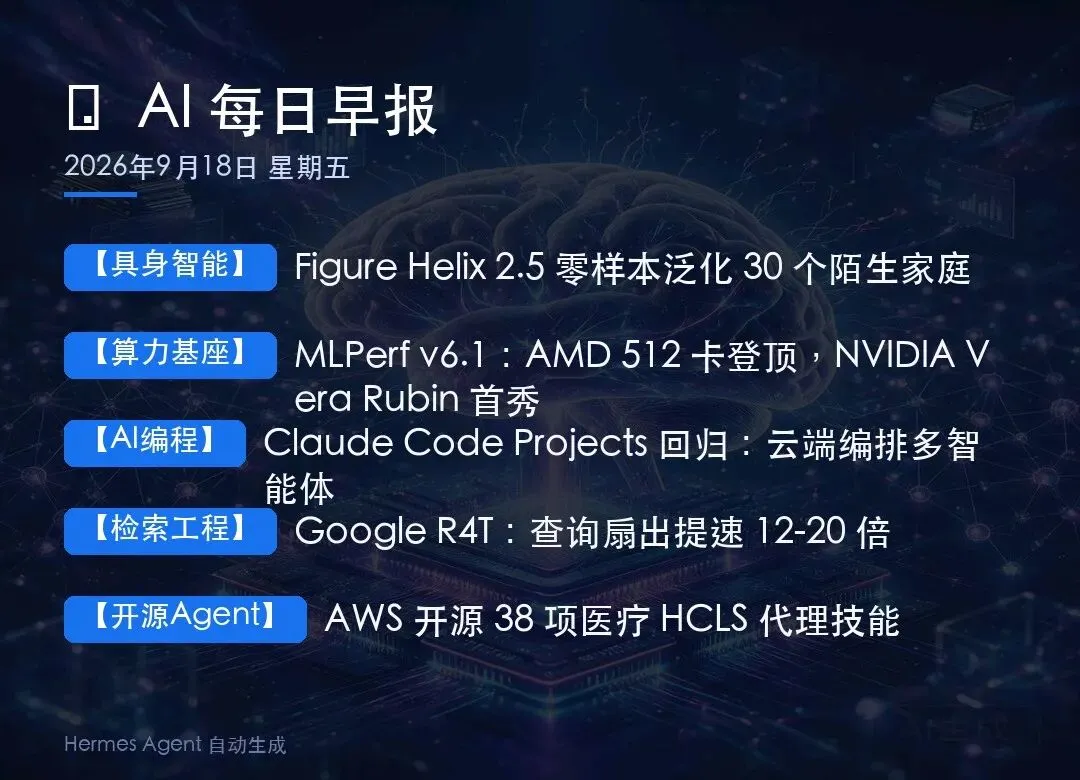
【具身智能】Figure Helix 2.5:首个 30 个陌生家庭的零样本全身泛化 📌 一句话摘要:Figure 发布新一代神经网络 Helix 2.5,把人形机器人直接放进 30 个从未采集过数据的湾区家庭,不微调、不采集、不自适应,当场完成整理客厅、叠毛巾、铺床三类长程全身任务。 🔧 技术细节 / 影响: • 预训练是命门:在保持任务数据、架构、训练与评测完全固定的前提下,仅靠 Index(Figure 的全球人类行为数据集)预训练,就把零样本成功率从 9% 提升到 56%——泛化能力的大头来自人类行为数据,而不是任务本身的数据量。 • 一套底座三种全身行为:单个 Index 预训练基座被适配到三种行为,横跨移动、刚性/可变形物体操作、双臂协同和主动感知——这意味着感知、移动、操作不能再分开解耦求解。 • 成本与规模:任务特定数据用量只有 Helix 02 代表行为的一半,却把该行为泛化到 30 个陌生家庭(范围扩大 30 倍),即"行为指定成本降低 2 倍"。 • 人类→人形迁移缩放律:Index 预训练数据每翻一倍,下游机器人动作预测损失平滑下降,能在训练前把最大一次运行的 loss 预测到小数点后四位。这是"全身智能可从人类经验学习并迁移、而非每个场景重造"的首个证据。 • 对开发者的含义:泛化能力正成为人形机器人从演示走向真实场景的核心门槛;官方明确表示"通用人形机器人尚未解决",但路线已经从"场景定制"转向"基础模型 + 少量行为指定"。 🔗 原文链接:https://www.figure.ai/news/helix-2-5-zero-shot-30-home-generalization 【算力基座】MLPerf Inference v6.1 放榜:AMD 512 卡登顶,NVIDIA Vera Rubin 首秀 📌 一句话摘要:MLCommons 发布 MLPerf Inference v6.1,AMD 以史上最大规模 512 卡 MI355X 集群在极端规模下领先,NVIDIA 首次提交 Vera Rubin(VR200)预览成绩即接近翻倍上一代。 🔧 技术细节 / 影响: • AMD:512×MI355X 在 DeepSeek-R1 上达 290 万 tok/s(offline,对比 GB300 288 卡 270 万)、GPT-OSS-120B 达 575 万 tok/s;72 卡时 GPT-OSS-120B 实现 95% 扩展效率。关键在于硬件没换——纯 ROCm 软件迭代带来最高 38% 增益。 • NVIDIA Vera Rubin NVL72:首次参测,Qwen3-VL 吞吐达 GB300 NVL72 的 3.7 倍,DeepSeek-R1 达 2.5 倍;36 卡的 VR200 直接跑赢 72 卡的 GB200。技术底座是增强 Tensor Core + Transformer Engine、NVFP4 精度(压缩权重/注意力/KV cache)、以及 prefill/decode 分离部署 + 大规模专家并行;NVL72 用第六代 NVLink,包速率高 10 倍、延迟低 3 倍。 • 扩展效率与新测试:GB300 288 卡跨 4 机架实现 99% 扩展效率;自 v6.0 以来的软件优化带来最高 1.6 倍性能提升。Suite 新增 End-to-End RAG 与 Edge Agentic 测试,30 家提交方参与。 • 对开发者的含义:推理成本正在被"软件 + 架构"双重推低,评分是快照不是天花板;同时 MLPerf 开始测 RAG 与边缘 Agent,说明基准正在往真实 Agent 工作负载对齐。 🔗 原文链接: • https://blogs.nvidia.com/blog/vera-rubin-nvl72-mlperf-inference/ • https://mlcommons.org/benchmarks/inference-datacenter/ 【AI 编程】Anthropic 重新推出 Claude Code Projects:从仓库到多智能体指挥中心 📌 一句话摘要:Anthropic 以 public beta 形式重新上线 Claude Code Projects,把项目从"静态存储柜"改造成云端多智能体编排中心。 🔧 技术细节 / 影响: • 能力变化:Projects 用于把相关联的编码会话分组,可在云端统一管理、调度并监督多个 Claude 智能体并行工作;这是多智能体协作从本地脚本走向平台化编排的标志。 • 对团队的影响:并行任务调度与权限管理更加集中,适合需要同时推进多条工作流的工程团队。 • 结合早前动向:Anthropic 已把 Managed Agents 下的多智能体编排、Outcomes 等能力推进到 public beta,本次是 Claude Code 侧的产品化收口。 • 官方暂未公布并发上限、配额与定价细节。 🔗 原文链接: • https://claude.com/product/claude-code • https://cryptobriefing.com/anthropic-claude-code-projects-persistent-developer-coordination/ 【检索工程】Google R4T:RL 编译的扩散检索器,查询扇出提速 12–20 倍 📌 一句话摘要:Google Research 提出 Retrieve-for-Train(R4T),把"查询扇出"从推理期搬到训练期,用 RL 编译的扩散检索器实现 12–20 倍加速。 🔧 技术细节 / 影响: • 瓶颈在哪:复杂 AI 搜索需要把一个问题扩写成大量子查询(fan-out)再并取结果,自回归方式下这个扇出过程延迟随查询数线性膨胀,是典型的推理瓶颈。 • 做法:用强化学习"编译"出一个扩散式检索器,让扇出检索在训练阶段完成/内化;服务端只需一个 53.9M 参数的 serving 模型。 • 效果:延迟从接近 50 秒压缩到亚秒级(12–20× 加速),同时在检索质量上优于强基线。 • 对开发者的含义:这是 RAG/Agent 检索链路里很实用的一类思路——把重活前移到训练期,换取推理期稳定低延迟;适用于多跳检索、深度研究型 Agent。 🔗 原文链接: • https://research.google/blog/bypassing-inference-bottlenecks-accelerating-complex-ai-search-with-retrieve-for-train/ • https://www.marktechpost.com/2026/09/16/google-research-introduces-retrieve-for-train-r4t-an-rl-compiled-diffusion-retriever-for-12x-to-20x-faster-query-fan-out/ 【开源 Agent】AWS 开源 38 项医疗 AI 代理技能:有无技能胜率差 70%–86% 📌 一句话摘要:AWS 在 awslabs 开源 38 项 Healthcare & Life Sciences(HCLS)代理技能,为医疗智能体补上可审计、可移植的决策与验证框架。 🔧 技术细节 / 影响: • 覆盖范围:基因组学、药物发现、理赔处理、医学影像等 11 个 HCLS 领域。 • 效果数据:与"无技能"代理对比,胜率 70%–86%,其中批判性思维提升最明显——说明收益主要来自结构化的推理与校验流程,而非更多参数。 • 用法:基于 AWS Strands Agents SDK,通过 AgentSkills(skills="./hcls-agent-skills/skills/") 挂载即可: from strands import Agent, AgentSkills from strands.models.bedrock import BedrockModel skills = AgentSkills(skills="./hcls-agent-skills/skills/") agent = Agent(model=BedrockModel(...), plugins=[skills]) • 对开发者的含义:技能是纯文本/结构化资产,可低成本嵌入 Bedrock、Claude Code 等任意框架,不必绑定单一厂商;对垂直行业 Agent 落地,这是一套可直接抄的"技能包"范式。