ARTICLE · 1036396
Word、PPT、Excel 都想喂给 AI?这个开源工具先帮你转成 Markdown
做知识库、整理资料,最磨人的工作往往发生在提问之前。
一份 Word 报告,一套 PPT,还有几个 Excel 表格。内容都在里面,可复制出来以后,标题层级没了,表格挤成一团,脚注和正文混在一起。
如果每种格式都单独找工具,文件还没整理完,转换流程已经凑了好几套。
今天分享的 AnyDoc,就是来处理这一步的。
这是 Firecrawl 推出的开源文档转换项目,核心用 Rust 编写,提供命令行、Node.js、Python 和浏览器接口,把不同文档转换成统一的 Markdown,方便后续检索、整理和交给 AI 处理。
常见办公文档,尽量用同一种方式处理
AnyDoc 覆盖的格式比较实用,除了现在常见的 Office 文件,也包括一些旧格式。
.doc.docx、.docm | |
.ppt.pptx、.pptm 等 | |
.xls.xlsx、.xlsm、.xlsb | |
.odt.ods、.odp | |
.epub.rtf、.csv | |
这对积累了多年资料的文件夹很有用。旧版 Word、同事发来的演示稿、系统导出的 CSV,可以通过同一套接口处理。
它还会根据文件内容识别格式,而不只看扩展名。CSV 这类没有明确格式标记的文件,则需要借助文件名或手动指定。
转出来以后,标题和表格还得能读
文档转换不能只看“有没有文字”。
一段内容属于哪个标题,某个数字落在哪一列,脚注对应哪句话,这些关系一旦丢失,后面做摘要和问答就容易误解。
AnyDoc 会处理标题、列表、表格、链接、脚注等结构,并把支持的公式转换成 LaTeX 表达。
它为多种办公格式使用共同的文档模型和 Markdown 输出规则,让不同文件的转换结果尽量一致。
不过,Markdown 主要承载内容与结构。PPT 的复杂视觉布局、文档里的精细排版,仍然需要回到原文件查看,不能指望转换后原样复刻。
不想装环境,可以先在浏览器里试
AnyDoc 提供了浏览器演示页面,可以拖入文件,也可以点击内置的 RTF、CSV 示例,查看转换结果,再复制或下载 .md 文件。
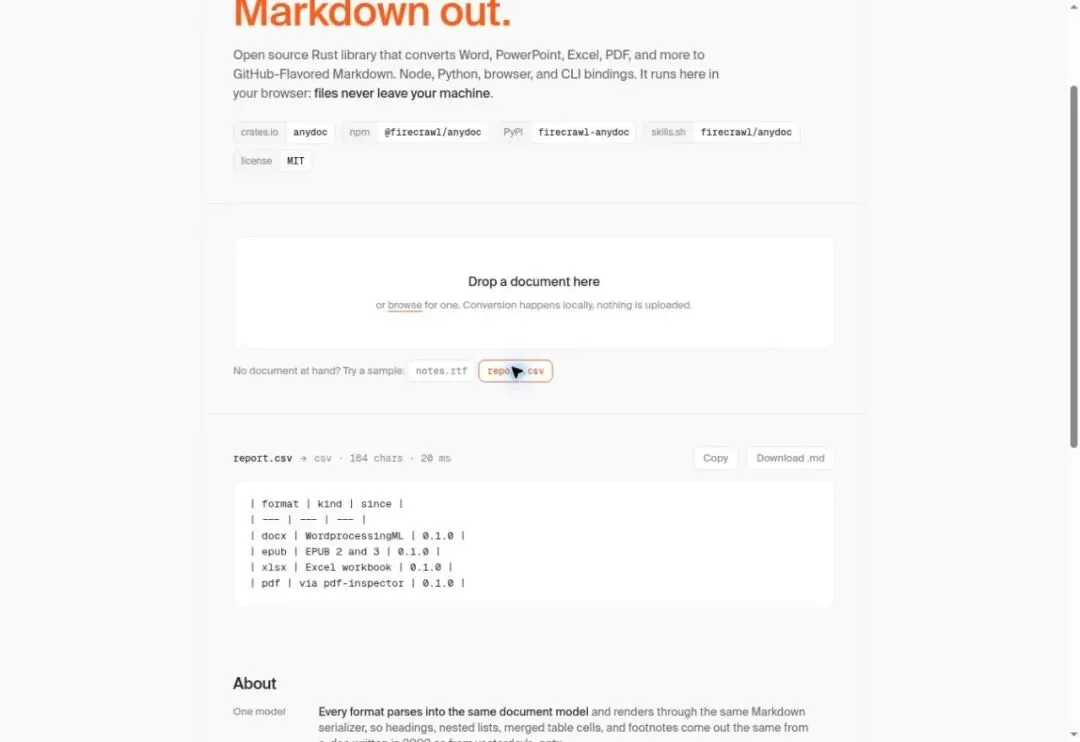
这个页面通过 WebAssembly 在浏览器本地运行转换逻辑,文件无须上传服务器。第一次打开,需要先加载转换组件。
对于只想偶尔整理几份材料的人,这个入口比较直接。先拿一份表格和一篇带标题的文档试试,就能看到输出是否适合自己的用途。
经常处理文件,一条命令就能接进流程
电脑有 Node.js 环境,可以在终端运行:
npx @firecrawl/anydoc report.docx -o report.md把文件名换成自己的文档即可。首次运行,npx 会下载对应平台的预编译程序,因此需要联网准备。
想接到 Python 脚本里,可以先安装:
pip install firecrawl-anydoc再用几行代码完成转换与保存:
from pathlib import Pathimport anydoctext = anydoc.to_markdown("report.docx")Path("report.md").write_text(text, encoding="utf-8")这样就可以在自己的脚本中遍历文件夹、记录转换失败的文件,再把结果送往后续处理环节。
项目也提供 Agent Skill,可通过 npx skills add firecrawl/anydoc 安装,让兼容的 Agent 学会调用转换工具。具体使用仍取决于所用工具的环境和权限。
PDF 和图片,有两个边界要看清
文本型 PDF 可以在本地处理,扫描 PDF 则需要另外识别图片里的文字。
AnyDoc 本身不做 OCR。遇到需要 OCR 的页面,会返回相应错误;命令行、Node.js 和 Python 接口可选择启用托管 OCR,把文档交给 Firecrawl Parse。
这里要留意,启用后遇到需要 OCR 的文件,上传的是整份文档。处理资料前,应先分清自己走的是本地转换还是托管服务。
嵌入图片也有区别。默认 Markdown 主要呈现替代文本,原始图片字节保留在文档模型中。开发者需要通过相应接口提取资源,再安排图片保存和引用,不能把转换理解成自动生成完整图文站点。
适合放在资料整理的第一步
AnyDoc 采用 MIT 协议,适合需要持续接收多种文档、又希望统一输出格式的流程。
例如把产品手册转成可检索文本,为知识库导入准备材料,或把历史报告整理成方便版本管理的 Markdown。
转换完成后,仍需要抽查复杂表格、公式和阅读顺序。加密文件、损坏文件也可能无法处理,批量脚本要保留失败记录。
第一次尝试,可以选三份结构不同的材料:一篇 Word、一套 PPT、一份表格。重点检查关键信息有没有漏、表格对应关系有没有变,再决定是否接入整个资料库。
项目地址:
https://github.com/firecrawl/anydoc