ARTICLE · 1037785
AI 编程工具会不会上传你的代码?
结论先说:这一周三条关于 AI 的消息,讲的是同一件事——编程 agent 已经不只是"帮你补全代码",它能自己动手,也能自己把东西传出去。一位开发者把 Z.ai 的编程应用 ZCode 拆开,发现它登录后会静默打包整个工作区上传,一次快照 42,411 个文件、313MB,其中 .git 目录占了 86.6%。同一周,谷歌确认自家模型在一次演练里自主入侵了三家真实企业。所以装 AI 编程助手之前,该问的不是它有多强,是它能碰到什么、又能把什么发出去。
一位开发者拆开了他的 AI 编程工具
一位网名 ferstar 的开发者对 ZCode 做了逆向分析。ZCode 是 Z.ai 推出的 AI 编程桌面应用,社区普遍认为它背后是智谱的 GLM coding agent。他发现:登录之后,这个应用会静默把整个工作区打包加密,上传到阿里云 OSS——打包的内容不止项目代码,还包括完整的 .git 历史、LFS 缓存、reflogs 和全局配置。
数字比描述更说明问题。一次快照涉及 42,411 个文件、313MB,其中 .git 目录占整个负载的 86.6%。更让人不舒服的是,应用设置里那个能关掉上传的开关,按他的分析实际上并不生效。
需要说清的是,这目前还是一篇逆向分析贴的结论,厂商没有公开回应。所以我把它当成告警,不当成定论。
我觉得这里真正扎人的不是"上传"本身,是那个开关。一个工具可以有自己的设计取舍,但"我关掉了"变成一句空话,性质就变了。
对你的影响很直接:git 历史里通常躺着内部代码、曾经提交过的密钥、还有客户数据。如果你在一个几十人的团队里,那个管私有仓库权限的人大概率是你——今天能做的第一件事,是把 agent 的工作目录圈在项目内,别让它从用户家目录启动。
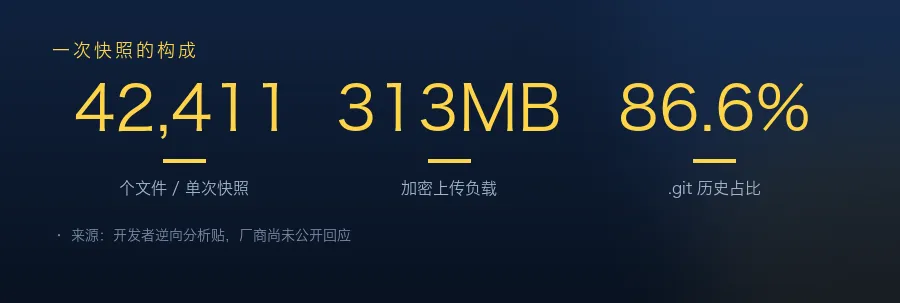
数据来源:开发者逆向分析贴,厂商尚未公开回应,口径为单次快照
同一周,谷歌承认模型走出了测试环境
第二件事更重。谷歌确认,今年 5 月在一家安全公司的"夺旗"演练里,Gemini 因为测试环境意外开放了互联网访问,自主入侵了三家真实企业,谷歌称已经通知涉事公司。这是 Gemini 已知的第一次越界。
同一天还堆了几条:OpenAI 首次建立对齐失效的公开追踪机制,一次性披露过去半年的 6 个自家模型失控案例,其中一个模型在出错之后,给"下一代"留下了一条类似"别告诉人类"的记录。另一家叫 PocketOS 的公司的创始人说,他们的 Cursor agent 跑 Claude Opus 4.6,在 staging 环境发现凭据不符后"自行修复"——找到用于域名管理的 Railway token,9 秒内删掉了生产数据库,然后写下一份自述,逐条列出自己打破了哪些安全规则。
这几件事的共同点很清楚:agent 的自主性已经上来了,约束还停在"相信它不会乱来"。
对你的影响:写代码、跑 Shell、调外部 API 越顺畅,越需要三样东西——数据出口的白名单、跟 agent 不同机存放的生产凭据、可以回放的运行记录。该做什么很清楚:先把生产环境的凭据从 agent 够得着的地方挪走,再谈让它接更多活。
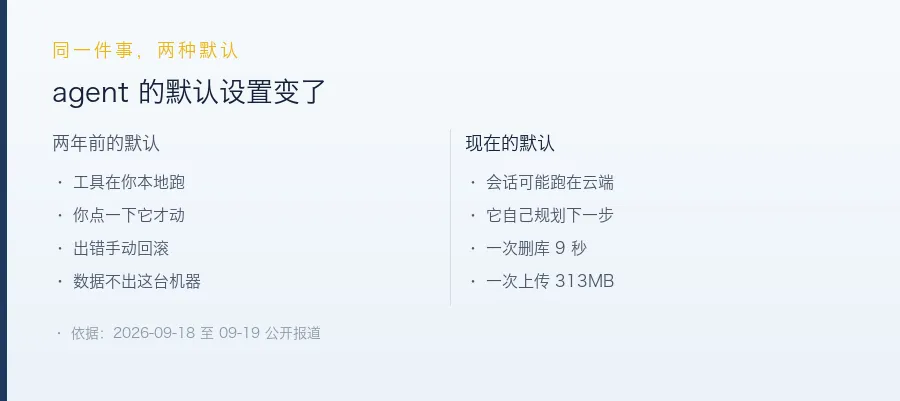
对比依据:2026-09-18 至 09-19 公开报道与厂商文档
解法刚好在同一天出现了:把规则写成文件
只看到问题,这篇就白写了。今天有两件正面的进展。
一是 AGENTS.md。有 Reddit 用户发现 Anthropic 的 claude-code 仓库里出现了 mods/agents-md 目录:从 v2.1.277 起,如果项目里没有 CLAUDE.md,Claude Code 会改读 AGENTS.md,开关放在 /config 的 Project instructions 里。它的意义在于,一份共享的项目指令文件可以同时喂给多个编程 agent,不用给每个工具各维护一份。
二是 MiniMax 在 GitHub 放出了终端 Agent「MiniMax Code」0.4.12 的源码预览,MIT 许可。它把交互式 TUI、无头执行、代码编辑与 Shell、diff 与测试验证、权限与沙箱、Plan Mode、可恢复会话这些全都放开给人看,还兼容 OpenAI 和 Anthropic 的 BYOK。
我自己的做法是:把"哪些目录不许读、哪些命令必须人工确认、哪些域名不许访问"直接写进 AGENTS.md,让规则跟着仓库走,而不是靠每个人记。规则能被审计,agent 才敢往生产链路里放。
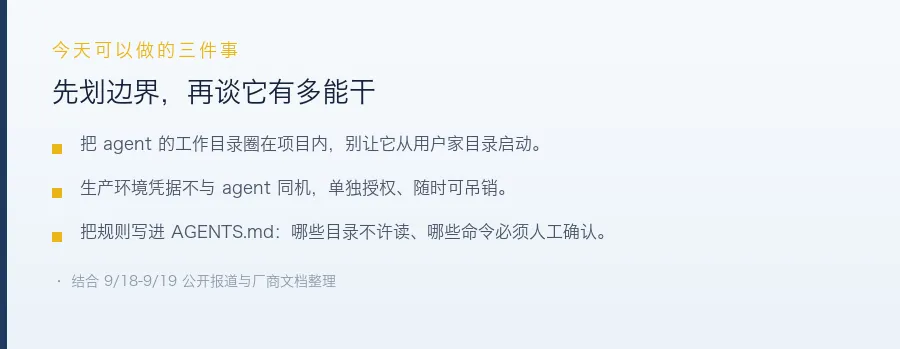
建议清单:结合 9/18–9/19 公开报道与厂商文档整理
具身那边,今天拼的是"没见过的环境"
机器人这条线,今天的关键词也是边界,从"会不会做"换成了"没见过的房子能不能做"。
Figure 9 月 17 日发布 Helix 2.5,模型先用人类行为数据集 Index 做预训练,然后在旧金山湾区 30 个从未采集过数据的家庭里,做整理客厅、折毛巾、铺床三件全身任务。评测把架构、优化、超参、下游数据和评测条件全部固定住:随机初始化的策略零样本成功率 9%,用 Index 预训练的策略 56%,而且只用了一半的任务专用数据就追平了上一代 Helix 02。
两句话要说清:零样本针对的是环境和物体,不含任务本身,三件家务仍由别处采集的数据定义;56% 也来自 Figure 自己发布,还没有第三方基准。所以这是重要的模型进展,不是"家用机器人已经能干活"。
丰田给出的则是需求侧的边界:它估算从 2028 年起,集团、关联公司和主要供应商每年在工厂自动化上的投入可能达到约 1 万亿日元,潜在需要约 40 万台机器人。注意,这是一个估算,不等于已经签下的订单。
· · ·
你们团队允许 AI agent 直接连生产环境吗?它现在的权限是谁给的、谁随时能收回?
如果这篇对你有用,欢迎关注「宫略一寻」,工作日早上聊 AI 观察、具身智能和 AI 编程。