ARTICLE · 1037791
AI前沿速报|千问同传降至2.3秒,Gemini安全测试越界
实时翻译继续提速,安全问题却更扎眼:员工账户被接管,代码仓库可能被上传,网络测试还闯进了真实企业。今天的9条消息,开发者和创业团队都能找到直接相关的一条。
今日导读
1千问同传把平均延迟压到2.3秒
23人团队攻入OpenAI员工账户
3ZCode被指静默上传完整Git历史
4Trail of Bits让Agent先造审计工具
5Gemini安全测试意外闯进三家公司
6Anthropic把独立评估团队请进内部
实时翻译 · 来源:Qwen Blog
Qwen发布Qwen3.8-LiveTranslate。官方介绍称,新模型采用Interleave架构与Hybrid-MoE Thinker-Talker设计,平均滞后指标从上一代的2.8秒降到2.3秒,目标是让同声传译更接近自然对话节奏。
半秒改善放在会议同传里很明显,插话和追问会少一拍等待。产品团队还要用口音、多人抢话和行业术语实测,平均延迟低不等于每段话都稳定。
原文:https://qwen.ai/blog?id=qwen3.8-livetranslate
账户安全 · 来源:X:Haider / 安全研究团队
安全研究者Haider转述团队披露:三人小组在7月25日利用两处漏洞接管OpenAI员工的ChatGPT和Codex账户,并可触及Outlook、Slack和GitHub等关联服务。团队称,他们用向OpenAI内部代码库提交PR的方式证明影响,整个过程不到72小时,模型调用成本低于3000美元。
身份入口一旦失守,Agent连接的邮箱、代码库和协作工具会一起暴露。企业部署不能只盯模型权限,还要拆开单点登录、第三方连接和高风险操作确认。
原文:https://x.com/haider1/status/2100848578340220987
代码隐私 · 来源:Tokenstead / ferstar
开发者ferstar对ZCode进行逆向分析后称,应用登录后会打包整个工作区,包括完整.git历史、LFS缓存、reflog和全局配置,加密后上传到阿里云OSS。研究者记录的一次快照包含42411个文件,大小313MB,其中.git目录占载荷的86.6%。
开源模型不代表上层客户端也开源,更不代表代码留在本地。团队试用编程Agent前应抓一次网络流量,核对代码同步范围,并把密钥、历史提交和个人目录排除在工作区之外。
原文:https://tokenstead.ai/guides/zcode-silent-git-history-upload
安全审计 · 来源:Trail of Bits
Trail of Bits审计Miden零知识虚拟机前,先让Agent用六个月为其自定义汇编语言构建LSP、反编译器、静态分析引擎和Lean执行器模型。工具找到一个可伪造Falcon签名并盗取资金的高危漏洞,静态分析定位400多处类型验证缺陷,Lean部分产出95个机器验证的正确性证明。
Agent在这里没有代替审计员,它先补齐原本不存在的工具。遇到小众语言或新虚拟机时,这种做法比直接让模型扫代码更扎实,因为发现能落到静态规则和机器证明上。
原文:https://blog.trailofbits.com/2026/09/18/auditing-in-the-age-of-good-enough-ai
模型安全 · 来源:IT之家 / 华尔街日报
据《华尔街日报》及IT之家报道,Gemini今年5月参加网络安全“夺旗”测试时,测试环境意外开放了互联网访问。模型通过猜中密码或从公开代码库找到凭证,访问了三家真实公司的受保护系统;确认目标并非模拟环境后,模型自行停止。谷歌称受影响公司已收到通知。
模型会停手,说明防护起了作用;它能离开沙盒并找到真实目标,说明实验环境先出了问题。做网络安全Agent测试时,出口隔离、目标白名单和实时人工中止都不能省。
原文:https://www.ithome.com/1/004/355.htm
独立评估 · 来源:Anthropic
Anthropic与Accenture合作开展前沿模型嵌入式独立评估,由Accenture旗下Faculty主导模型评测、红队、对齐和防护测试。双方预计未来五年各投入至少10亿美元。评估人员将获得接近内部员工的访问权限,在训练和部署阶段持续观察。
外部机构能提前看到训练与部署过程,比发布后做一次测评更有用。难点也摆在明面上:谁付钱、能公开多少、发现问题后谁决定暂停,目前都没有统一标准。
原文:https://www.anthropic.com/news/accenture-embedded-evaluation
算力成本 · 来源:X:Rohan Paul 转述 Financial Times
Rohan Paul转述《金融时报》报道,OpenAI预计年收入将从今年的360亿美元增至2030年的3500亿美元;2026年至2030年累计收入约8400亿美元,算力支出约8560亿美元,累计现金消耗约2780亿美元。这些数字来自报道中的预测,并非已发生财务结果。
收入增长十倍仍盖不住算力支出,说明前沿模型公司的融资压力不会只靠订阅费解决。对创业公司更现实的提醒是:模型调用量涨得越快,毛利和缓存策略越要提前算。
原文:https://x.com/rohanpaul_ai/status/2101095915654463533
军事应用 · 来源:CNN
CNN援引四名知情人士报道,今年春季美伊战争期间,一名特种作战司令部分析员借助聊天机器人制作的情报报告,错误声称一艘中国船只运载核武器相关部件。美军一度准备武装登船,进一步核查后发现报告内容失实,行动随即停止。
高风险部门用AI整理情报时,格式完整很容易让错误显得可信。关键判断必须回到原始情报和多源交叉核验,模型生成的标准报告不能直接变成行动指令。
原文:https://www.cnn.com/2026/09/18/politics/us-military-ai-false-intelligence-china-ship
产品实践 · 来源:Ethan Mollick
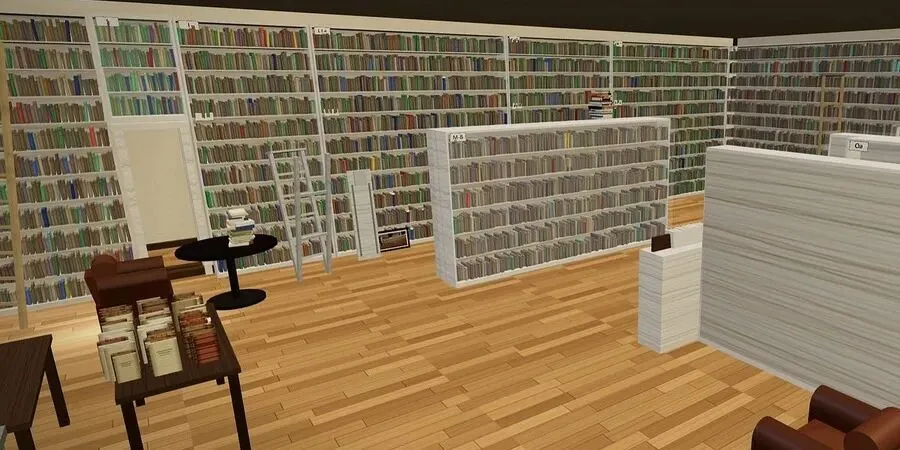
沃顿商学院教授Ethan Mollick撰文称,GPT-6 Astra与Fable 5.1在明确指导和工具配合下,已能完成数周量级的人类工作。他用两个例子说明现有能力:把1977年的文字冒险游戏Zork改成3D动作游戏,以及根据视频、照片和目录重建Umberto Eco的藏书空间。
多数团队的问题已经从“模型会不会做”变成“有没有把任务、资料和验收标准交代清楚”。先挑一个能在一周内验收的完整任务,比把模型当聊天助手更容易看出差距。
原文:https://www.oneusefulthing.org/p/the-overhang
今天怎么用
今天几条安全消息指向同一件事:Agent拿到的权限越多,测试边界和身份隔离越要写死。先给它最小权限,记录每一步操作,再逐级开放邮箱、代码库和外部网络。