ARTICLE · 1038106
0919日报| AI编程助手竞赛:Kimi开放生态与智谱隐私危机同天揭示信任新门槛
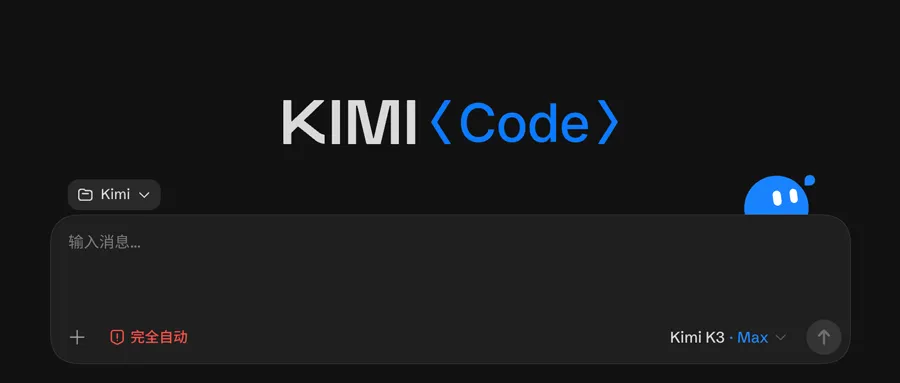
Kimi:Code桌面版发布,支持macOS与Windows及第三方模型
Kimi面向编程场景推出了Kimi Code的桌面版应用,该版本原生适配macOS和Windows系统,内置旗舰模型Kimi K3,并支持接入第三方模型。
核心进展
Kimi Code发布了独立的桌面客户端,安装包大小为143MB,完成了轻量化处理。 应用支持接入第三方模型的API(应用程序编程接口),例如DeepSeek,但接入OpenCode Go时因缺少特定会话ID头而存在兼容性问题。 桌面版内置了专用浏览器和官方数据插件Kimi Datasource,可查询金融、宏观等数据,并提供了框选屏幕评论等交互功能。
为什么重要
Kimi Code桌面版的发布意味着编程场景的AI助手从网页或通用客户端中独立出来,可能为开发者提供更专注、响应更快的本地化工具,并试图通过支持第三方模型来构建更开放的生态。
产业解读
标志着模型厂商正从提供通用对话能力向深耕垂直场景(如编程)迁移,通过发布独立应用来优化特定工作流。支持第三方模型可能削弱用户对单一厂商模型的依赖,促使竞争从模型能力本身向工具集成度、生态开放性和用户体验转移。
来源:智东西
智谱AI:编程工具ZCode被指静默上传完整Git历史
智谱AI的AI编程桌面端ZCode被开发者取证发现,在用户登录后,会静默将整个工作区(包括完整的.git历史、LFS大文件缓存、reflog和全局配置)打包加密上传至阿里云OSS(阿里云对象存储服务)。
核心进展
有开发者通过取证博客指出,智谱AI的ZCode工具存在静默上传用户本地工作区数据的行为。 被上传的数据范围包括完整的Git版本控制历史、Git LFS(大文件存储)缓存、Git reflog(引用日志)以及全局Git配置。 该上传行为在用户登录ZCode账号后自动进行,数据被加密后发送至阿里云OSS。 该问题已在技术社区引发讨论,并有其他用户通过复现验证了该行为的存在。
为什么重要
使用ZCode的开发者,其本地代码仓库的完整历史、配置乃至可能包含敏感信息的大文件缓存,在未经明确同意的情况下被上传至第三方云服务商。这直接关系到用户的数据隐私、代码安全和知识产权保护,可能违反用户信任和数据保护法规。
产业解读
此事件可能引发用户对AI编程工具数据收集边界的重新审视。模型厂商在提供本地化工具时,若过度收集用户工作环境数据以优化模型或提供服务,可能面临严重的信任危机。这可能导致竞争焦点从单纯的功能和代码生成能力,部分迁移至数据处理的透明度和用户可控性。长期看,可能促使行业制定更严格的数据处理标准,或催生更注重隐私保护的竞品。
来源:开源中国
华为:发布昇腾960超节点与百万卡集群
华为在全联接大会2026上提出要做“硅基黑土地”,并发布了昇腾960超节点和百万卡集群,同时获得了PyTorch(一个主流的深度学习框架)的官方支持。
核心进展
华为发布昇腾960超节点,这是其AI计算硬件的新一代产品。 华为宣布构建百万卡规模的AI计算集群,以提供大规模算力。 华为的昇腾AI平台获得了PyTorch深度学习框架的官方支持。
为什么重要
昇腾960超节点和百万卡集群的发布,意味着华为在提供大规模AI算力基础设施方面迈出了实质性一步。获得PyTorch官方支持可能降低开发者在华为硬件上的适配成本,有助于吸引更多用户使用其AI平台。
产业解读
华为通过硬件升级和扩大集群规模,直接参与AI算力底座的市场竞争。获得主流框架PyTorch的支持,可能改变AI开发工具链的生态格局,促使其他硬件厂商也寻求更紧密的软件生态合作。这标志着AI基础设施竞争从单一硬件性能扩展到软硬件协同和生态完备性。
来源:开源中国
智谱AI:融资50亿美元投向模型研发与算力基础设施
智谱AI完成约50亿美元融资,所得款项主要投向模型研发与算力基础设施这条主线。
核心进展
智谱AI在2026年2月至8月期间,其GLM系列模型平均每两个月完成一次重要升级,迭代节奏稳定。 智谱AI计划将约235亿港元融资投向下一代GLM模型、完全自训练体系以及大规模训练、推理和算力基础设施。 智谱AI提出‘完全自训练’(Fully Self-Training)技术路线,探索让模型在数据生成、任务环境构建和基础设施优化环节实现自我迭代。
为什么重要
大规模融资为智谱AI提供了维持其稳定模型迭代节奏所需的资金弹药,可能使其在训练规模、实验频次和工程体系建设上获得更大探索空间,从而在持续迭代能力的竞争中保持优势。
产业解读
头部AI厂商(如字节、阿里、腾讯)近期密集融资投向算力与基础设施,表明行业竞争焦点正从单点模型能力转向比拼持续、稳定迭代的工程化能力。智谱AI将‘完全自训练’作为公开战略,意味着其试图通过自动化研发流程来构建长期技术壁垒,但这需要巨额且长期的资金与工程投入,其成败可能影响未来几年头部厂商的技术代差格局。
来源:雷锋网
Wonmi Choi 等研究者:AI 代理任务并发暴露 CPU、磁盘 I/O 与内存瓶颈
Wonmi Choi 等研究者分析了检索增强问答、网络搜索和软件编码三类任务中 AI 代理的资源动态,发现并发运行请求会暴露任务依赖的资源瓶颈,并展示了利用任务资源动态的优化机会。
核心进展
研究发现,AI 代理(基于大语言模型的自动化程序)的行为因任务而异,即使使用相同工具,其资源动态也可能差异巨大。 测量表明,并发处理多个请求和任务时,会暴露任务依赖的资源瓶颈,例如 CPU、磁盘 I/O 和内存。 研究揭示,更快的 LLM(大语言模型)响应或更多的 CPU 核心并不总能加速代理任务。 研究者演示了两种利用任务资源动态的优化方法:CPU 感知的工具准入和任务感知的 CPU 分配。
为什么重要
当前 AI 代理服务在资源调度上存在显著浪费,而基于任务特性的细粒度资源管理可能大幅提升效率。研究发现的优化方法(如 CPU 感知调度)为构建更高效的代理服务基础设施提供了具体的技术路径。
产业解读
该研究可能推动 AI 代理服务栈的价值重心从单纯追求模型能力或硬件堆砌,转向对任务-资源匹配的精细化管理。如果优化方法被广泛采纳,基础设施提供商(如云服务商)可能需要提供更细粒度的资源监控与调度接口,而代理框架开发者则需将资源动态纳入核心设计考量,这可能重塑部分工具链的竞争格局。
来源:arXiv 人工智能
Meysam Ghaffari 等研究者:临床编码代理通过结构化错误记忆提升CPT编码F1分数5.9个百分点
Meysam Ghaffari等研究者提出Learn-Then-Act框架,将小批量标注数据中的错误转化为结构化错误知识库,在150份匹配的MIMIC-III病历上。该框架将CPT(当前程序术语)编码的F1分数提升了5.9个百分点。
核心进展
研究者提出了Learn-Then-Act框架,该框架能在推理时进行自适应,无需更新模型权重或改变基础工作流。 框架将错误分类为假阴性(漏报)和假阳性(误报),并分别路由给专注于召回率的编码器(Coder)和专注于精确率的判断器(Judge)。 在150份匹配的MIMIC-III病历上,结构化错误知识库使CPT编码的F1分数提升了5.9个百分点,而原始示例记忆和反思式记忆则接近无记忆基线水平。 在1000份保留的MIMIC-III病历上应用相同记忆,保持了稳定的ICD(国际疾病分类)操作点,为系统的扩展性和稳定性提供了证据。
为什么重要
临床编码自动化系统可能通过一种轻量级、无需重新训练的方式,从历史错误中学习并持续改进特定任务(如CPT编码)的性能,降低了模型维护和更新的成本与复杂性。
产业解读
该研究展示了在特定、高价值、重复性错误模式明显的垂直领域(如医疗编码),通过结构化错误反馈来优化AI代理工作流的潜力。这可能促使AI基础设施提供商(如Amazon Quick(亚马逊的智能体工作流编排工具)Sight、Google Cloud AI Platform)在其企业级AI服务中集成类似的推理时自适应模块。以提升解决方案在复杂业务流程中的可靠性和可维护性,从而创造新的产品差异化价值。同时,这也意味着未来AI算力与硬件优化的焦点,可能部分从训练大规模通用模型,转向支持高效、低延迟的推理时自适应与个性化反馈循环。
来源:arXiv 人工智能
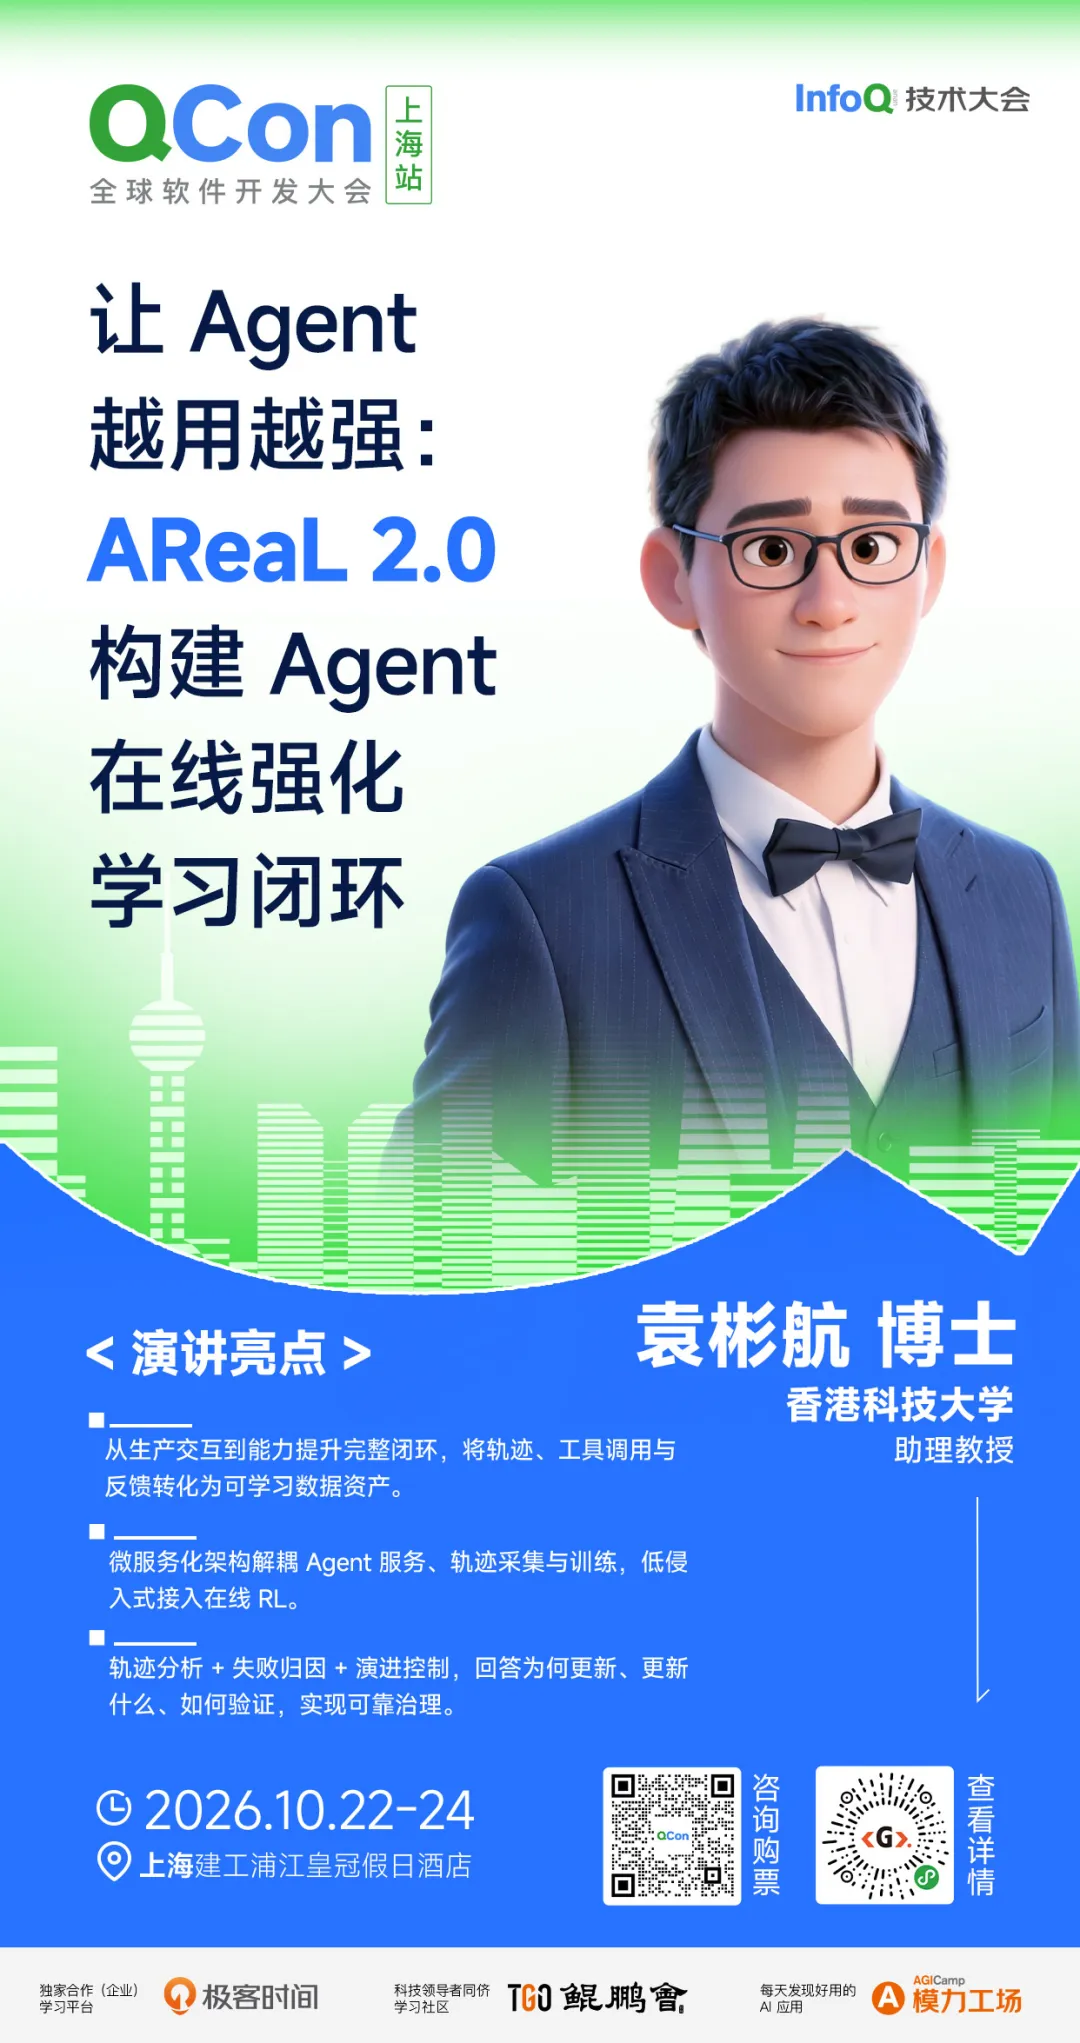
让 Agent 越用越强:AReaL 2.0 构建 Agent 在线强化学习闭环|QCon上海
让 Agent 越用越强:QCon上海站聚焦AI Native时代核心挑战,汇集100+一线实战案例
核心进展
让 Agent 越用越强:QCon上海站聚焦AI Native时代核心挑战,汇集100+一线实战案例 让 Agent 越用越强:AI Native需重构软件工程范式,系统能力决定价值落地
为什么重要
AI Native需重构软件工程范式,系统能力决定价值落地
产业解读
极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质
来源:InfoQ 中文
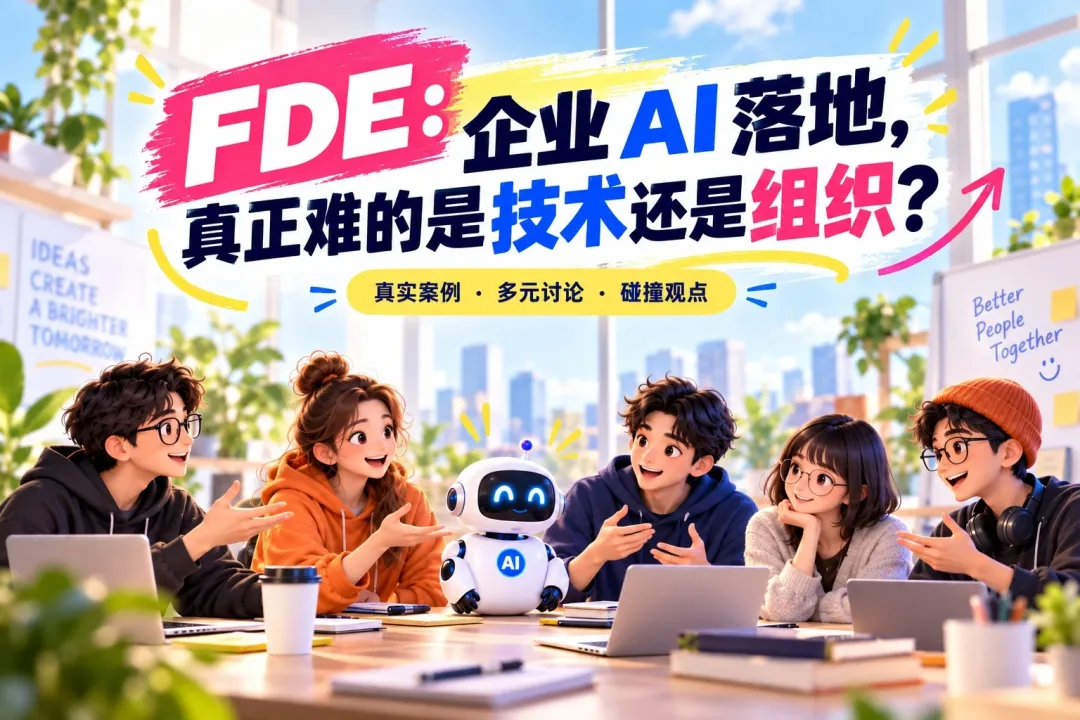
9 月 20 日杭州|FDE 在现场:模力工场举办企业AI落地诊断活动,聚焦非技术瓶颈
9月20日杭州|FDE在现场将举办一场主题为“企业AI落地,真正难的是技术还是组织?”的交流活动,旨在讨论企业AI项目从Demo走向真实业务时面临的具体障碍。
核心进展
活动将企业AI落地瓶颈明确指向数据接入、系统集成、权限管控及跨团队目标对齐等非技术因素。 活动形式包含四场主题分享,分别从组织进化、业务增长、客户现场问题及AI Native(AI原生)组织实践等不同角度切入。 活动设置了60分钟的企业AI落地诊断环节,由嘉宾与参会者共同对真实卡壳项目进行现场问题拆解与方向确认。
为什么重要
该活动将企业AI项目停滞的普遍痛点公开化、具体化,意味着产业共识正从追求模型能力转向解决工程与组织适配问题,可能帮助从业者更精准地定位项目阻塞点并调整资源。
产业解读
活动聚焦FDE(前线部署工程师)角色及其面临的争议,反映了AI服务模式可能从标准化产品交付转向深度定制与业务融合。这可能导致AI解决方案供应商的组织结构、服务流程和收费模式发生价值迁移,从提供技术工具转向提供包含组织咨询与流程改造的综合服务。
来源:InfoQ 中文
巴黎检方:对智能眼镜性骚扰启动刑事调查
巴黎检方针对涉及智能眼镜的疑似性骚扰行为启动刑事调查。
核心进展
法国司法部门首次对智能眼镜相关的性骚扰行为启动刑事调查。 法国数据保护机构已收到多家企业关于智能眼镜的投诉。 监管审查焦点从数据收集扩展至公共空间的具体行为(如未经授权拍摄)。
为什么重要
佩戴智能眼镜(一种配备摄像头和传感器的可穿戴设备)在公共场合进行拍摄或录音的行为,可能面临明确的法律追责风险,厂商需在产品设计和用户协议中加强合规警示。
产业解读
监管行动可能迫使智能眼镜厂商调整产品功能(如增加更明显的录制提示),并可能延缓企业级应用(如远程指导、第一视角记录)在敏感场景的部署,从而影响该硬件品类的市场增长曲线和商业模式探索。
来源:cnBeta
蚂蚁:开源大模型安全护栏SingProbe,适配29个开源模型
蚂蚁开源大模型内生式安全护栏SingProbe,同步开放相关代码、模型和评测基准,为开发者提供与模型生成过程同步运行的安全检测能力。
核心进展
SingProbe已适配包括Ling-3.0系列、GLM-5.2/5.3、Qwen、DeepSeekV4在内的29个主流开源大模型,并接入了SGLang、vLLM等主流推理框架(用于高效运行大模型的软件工具)。 在Ling-3.0-flash模型的生产环境实测中,SingProbe在解码阶段引入的额外计算开销低于0.5%。 同步开源的流式安全评测基准SingStreamBench,不仅检验护栏能否识别风险,还考察风险信号是否过早触发或发现是否及时。
为什么重要
为开发者提供了一种新的安全防护选项,其‘内生式’设计意味着安全检测与模型生成同步进行,可能降低传统外置护栏带来的延迟和额外计算成本,使安全防护更贴近实际业务需求。
产业解读
可能推动大模型安全防护从‘事后审核’向‘过程干预’迁移。通过提供工程化支持(如模型适配和框架集成),蚂蚁降低了‘运行时探针’(一种在模型生成过程中同步进行安全检测的技术)的落地门槛,这可能促使更多应用开发者尝试混合使用内生与外置护栏,从而优化整体的安全与效率平衡。
来源:智东西
Qingyang Xu 等研究者:BioPhys-Bridge 发布 500 个跨学科科学推理基准案例
Qingyang Xu 等研究者引入了 BioPhys-Bridge,一个用于生物物理文献证据推理的新基准数据集,初始版本包含 500 个案例和 1517 个任务。
核心进展
BioPhys-Bridge 基准要求模型将观测数据锚定于证据,通过定量物理模型解释,并关联生物机制,以评估跨学科科学推理能力。 数据集包含证据块、稳定证据 ID、定量值、单位、方程、假设、机制和后续决策,为问答和检索增强生成提供基础目标。 初步评估显示,DeepSeek-V4-Flash 在证据 ID 的 F1 分数上最高(0.360),其次是 Qwen3.7-Max(0.316)和 GPT-4o-mini(0.294)。
为什么重要
该基准为评估大语言模型在复杂、多步骤科学推理中的归因、忠实度、幻觉减少和生物实验设计能力提供了标准化工具,可能推动模型在专业科研辅助领域的能力提升。
产业解读
AI 模型评估正从通用任务向需要深度领域知识和严格证据链的专业任务迁移。一个公开、高质量的跨学科基准可能促使模型提供商优化其产品的科学推理和事实核查能力,从而影响其在学术和工业研究市场中的竞争力。
来源:arXiv 人工智能
OpenAI:安全团队利用 Claude 发现 OpenAI 漏洞并获赏金
OpenAI 的 SSO 配置错误及社区论坛软件漏洞被 Hacktron 安全团队利用,该团队借助 Anthropic 的 Claude AI 工具辅助发现漏洞并实现远程代码执行,控制了员工账户并访问内部资源。随后报告漏洞并从 OpenAI 获得 6500 美元赏金。
核心进展
安全团队组合利用 OpenAI 的 SSO(单点登录)配置错误和 Discourse 论坛软件的 libheif 软件包堆缓冲区溢出漏洞,实现了对员工 ChatGPT 账户的控制和内部资源访问。 研究人员使用了竞争对手 Anthropic 的 Claude AI 工具(包括 Opus 4.8 和 Opus 5.5 模型)来辅助漏洞发现和实现远程代码执行(RCE)。 整个 AI 辅助的漏洞发现和攻击过程消耗的 token 成本低于 3000 美元,AI 智能体运行数天,而研究人员仅投入数小时人工时间。
为什么重要
起事件表明,AI 工具(如 Claude)已能有效辅助发现和利用复杂安全漏洞,显著降低了攻击的技术门槛和时间成本。对于依赖 SSO 和第三方开源软件(如 Discourse)的企业,其攻击面可能因配置错误和软件漏洞的组合而扩大。
产业解读
事件可能加剧 AI 安全工具市场的竞争,安全团队和攻击者都将更广泛地采用 AI 辅助进行漏洞挖掘和攻击模拟。企业安全投入的价值可能从单纯防御向包含主动漏洞赏金和配置审计迁移。长期看,AI 降低攻击成本可能催生更多自动化、低成本的网络攻击,迫使安全厂商和内部团队更依赖 AI 进行对抗。
来源:奇客 Solidot
灵魂拷问
“智谱AI在融资投向基础设施时,其ZCode的数据上传政策是否匹配了用户对隐私合规的信任?”
垂直AI工具的数据信任与基础设施依赖
01Kimi:Code桌面版发布,支持macOS与Windows及第三方模型。
02智谱AI:编程工具ZCode被指静默上传完整Git历史。
03华为:发布昇腾960超节点与百万卡集群。