ARTICLE · 1042115
老师说这篇文章是AI写的,检测工具真的能当证据吗?
AI 内容鉴真 · 2026.09.20
“90% AI”能当作弊证据吗?
检测分数可以启动复核,但不该自动决定处分
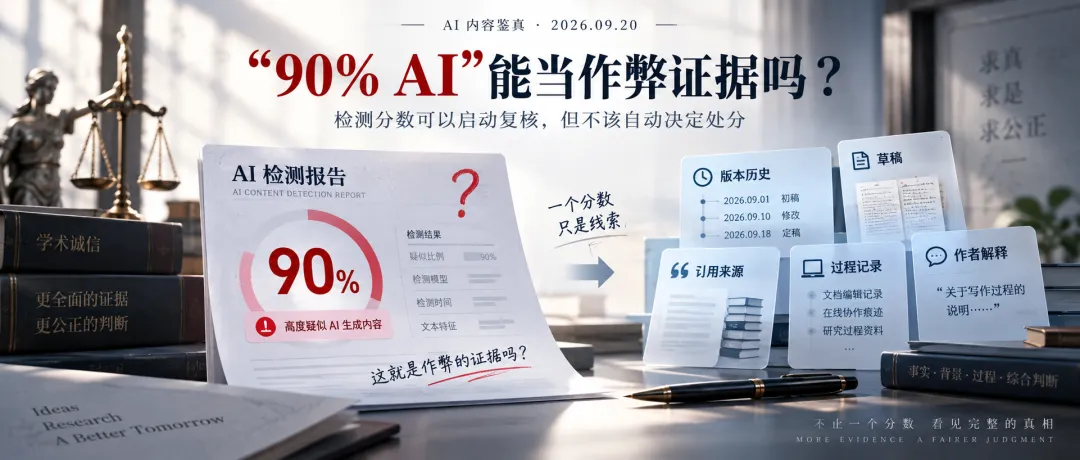
“你的论文 AI 率 90%,这门课按作弊处理。”
如果老师把一张检测报告放到你面前,这个数字看起来几乎像铁证。
但先别急着认,也别急着和老师争论“检测器都是骗人的”。
因为这里最容易混淆的是两件事:
Turnitin 在自己的使用指南里写得很清楚:AI 写作模型可能把人写的内容识别成 AI,也可能漏掉 AI 内容,因此不应单独作为对学生采取不利措施的依据。
OpenAI 的经历更直接。它曾推出 AI 文本分类器,后来因为准确率太低而下线。公开测试中,该分类器只识别出 26% 的 AI 文本,同时把 9% 的人类文本误判为 AI。
所以,“90%”到底能证明什么?
答案可能比你想象的少。
一、“90% AI”不是“你有 90% 的概率作弊”
这是整件事里最常见的误解。
以 Turnitin 为例,报告中的百分比指的是:在符合检测条件的正文里,有多少比例被模型判断为“可能由 AI 生成或经 AI 改写”。
它不是在说:
学生有 90% 的概率作弊; 全文有 90% 确定来自 ChatGPT; 检测结论有 90% 的准确率; 工具知道作者使用了哪个模型或账号。
这个分数来自统计分类。检测器观察句子是否过于规律、用词是否容易预测、段落波动是否类似模型输出,再把文本放到“更像人”或“更像 AI”的一侧。
它识别的是语言模式,不是创作现场。
就像只看脚印判断谁走过一条路:可以产生怀疑,却看不到这个人为什么来、做了什么,也不能排除鞋底相似的另一个人。
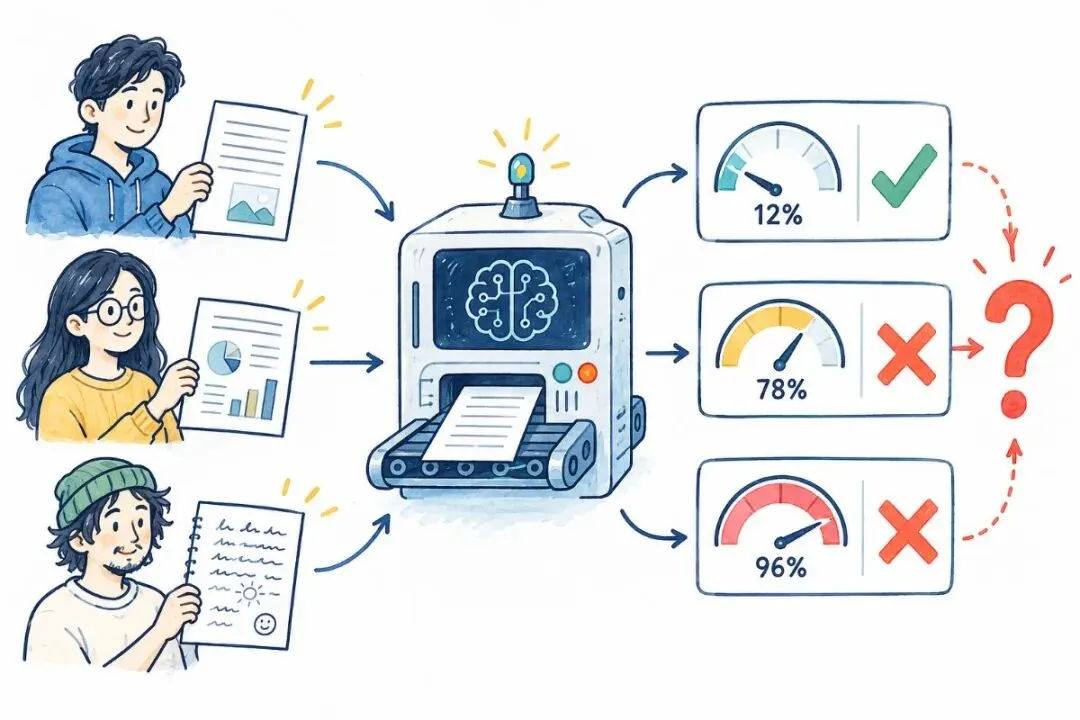
不同人类文本经过同一检测器后可能得到矛盾结果甚至发生误判
二、明明是自己写的,为什么也会被标成 AI?
检测器最难处理的,不是纯人工和纯 AI 两个极端,而是现实中的大量中间状态。
1. 规范写作本来就很“可预测”
实验报告、课程摘要、公文和标准答案往往结构稳定、措辞克制。作者越遵守格式,语言有时越像模型常见的写法。
短文本尤其麻烦。可分析的句子太少,几个固定表达就可能明显拉高分数。Turnitin 甚至不再展示 1% 至 19% 的具体数值,而用星号代替,因为这个区间更容易出现误判。
2. 非母语写作者更容易被误伤
斯坦福研究团队曾用 7 款检测器检查 91 篇真实 TOEFL 作文。它们平均把 61.3% 的非英语母语者作文误判为 AI;至少有一款工具把 97.8% 的作文标成 AI。
原因并不神秘。非母语写作者通常更依赖常用词、稳定句型和保险表达,而这些文字在统计上也更容易被预测。
这项研究针对的是 2023 年的一组检测器,不能直接代表今天所有产品的准确率。但它证明了一件事:写作风格会成为干扰变量,检测错误也可能集中落在特定人群身上。
3. 正常修改会模糊“谁写的”
一篇文章可能由人列提纲、AI 改语法、同学提建议,再由作者重写。检测器看到的是最终文字,无法还原每一步由谁完成。
反过来,AI 生成的文字经过人工重写、翻译或改述,也可能避开检测。研究已经反复证明,改写会显著降低多类检测器的识别能力。
结果是一个很尴尬的局面:
三、官方水印能成为“铁证”吗?
普通检测器是在猜写作风格。模型官方水印则更进一步:它在生成文字时,让大量词语选择形成只有检测方能验证的统计规律。
Anthropic 已宣布,未来的 Claude 模型会加入这类文字水印。水印没有隐藏字符,也不包含用户、组织、账号或对话信息。
与通用检测器相比,官方水印更有针对性,但它仍然只能支持一个有限结论:
它仍不能单独说明:
谁操作了模型; AI 写了全文还是只改了几句话; 使用方式是否违反当时的课程规则; 作者是否理解并能为内容负责; 这段文字是否构成抄袭或学术不端。
短文本、重度改写和跨模型重写还会削弱水印信号。研究也表明,递归改写可以攻击包括水印在内的多种检测方案。
所以,即便未来检测技术变强,“检测到 AI 参与”与“证明违规”之间,仍然隔着课程规则和使用过程。
四、检测报告到底能不能当证据?
更准确的回答是:可以作为辅助线索,不能自动成为定案依据。
一份检测报告可以提醒老师进一步核查,就像查重报告标出相似段落。但是否构成违规,还要回答三个问题:
1. 当时的规则是什么?
课程是否禁止一切 AI,还是允许查资料、列提纲、翻译和语法校对?规则有没有在提交前说明?学生是否被要求申报使用方式?
如果规则本身没有区分“让 AI 改一个病句”和“让 AI 代写全文”,检测出 AI 痕迹也很难直接映射到责任。
2. 有没有过程证据?
比单次检测分数更有解释力的材料包括:
选题笔记与阅读记录; 本地草稿和云文档版本历史; 引用来源与检索路径; 文件创建、修改时间; 提交前后的内容变化; AI 对话记录与使用声明。
它们不一定各自证明清白或违规,但能共同还原创作过程。
3. 作者能不能解释自己的作品?
让学生复述论点、解释资料选择、现场修改一段文字,通常比再找三款检测器投票更有价值。
如果作者能说明每一步判断,并拿出连续的写作记录,检测器的高分就需要被谨慎看待。如果作者无法解释核心概念,引用也不存在,问题就不只是“文风像 AI”了。
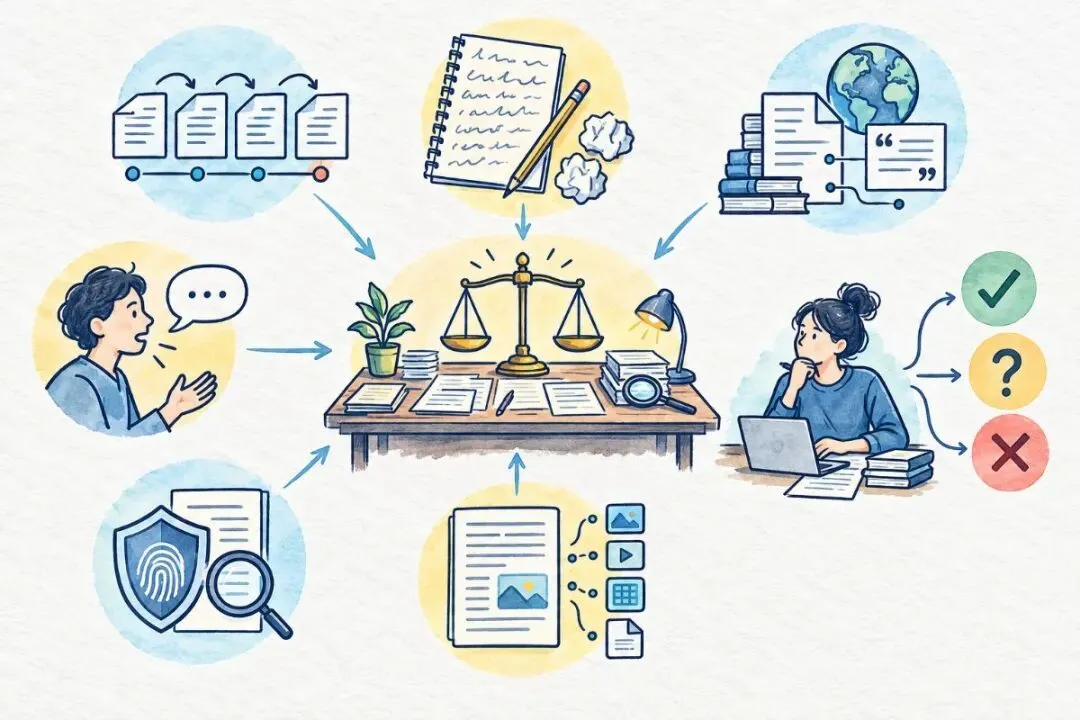
版本历史、草稿、引用、水印和作者解释共同组成复核证据链
五、如果你被误判,先做这 5 件事
被指控时,最没用的反应是把文章扔进另一款检测器,拿一个更低的分数证明前一款错了。
两台概率模型互相打架,不会自动产生事实。
更有效的做法是:
1. 要求看到完整报告
确认工具名称、版本、检测日期、被标记的具体段落,以及百分比到底代表什么。不要只接受一张“AI 率 90%”的截图。
2. 查清课程和学校规则
找到作业说明、课程大纲和学术诚信流程。重点查看允许哪些 AI 用法、老师需要提交什么证据,以及学生是否有解释和申诉机会。
3. 保存原始过程
导出 Word、Google Docs、飞书或其他工具的版本记录,整理笔记、资料、草稿、引用和文件时间。不要为了让记录“更好看”而事后修改原文件。
4. 准备解释内容
按段落说明论点从哪里来、为什么引用这些来源、哪些句子改过。必要时可以现场解释或重写一小段。
5. 用书面方式回应
保持事实化表达:你使用过什么、没有使用什么、有哪些过程材料、希望学校按哪项正式程序复核。避免只围绕“检测器一定错了”争吵。
六、老师真正需要的不是更高的检测分数
从教师视角看,AI 代写确实让评价变难。完全放弃核查并不现实。
但把判断外包给检测器,会把教学问题变成概率分数问题。
更可靠的方案是把证据前移:
作业开始时明确允许和禁止的 AI 用法; 要求保留选题、提纲和阶段性草稿; 让学生简要披露使用过的工具与环节; 对关键作业加入简短答辩或课堂写作; 发现异常时先讨论作品,再进入正式处理程序; 不把任何一款检测器的结果当作唯一证据。
MSU Denver 给教师的指导也采用了类似思路:索要草稿、笔记、版本历史或方法说明;仍有疑问时,按照学术诚信程序,结合多种证据处理。
这比不断追逐“更准的检测器”麻烦一些,却更接近教育真正要判断的东西:学生是否完成了思考,是否诚实说明工具使用,以及是否能为提交的内容负责。
最后的结论
AI 检测报告不是毫无价值。
它可以标出值得追问的段落,可以帮助教师发现异常,也可以成为完整调查中的一项材料。
但它看见的是最终文字的统计特征,看不见完整的创作过程。
因此,一张“90% AI”的报告可以成为一次谈话的开始,却不应该自动成为处分的终点。
如果你被 AI 检测器误判过,你最后是怎么证明自己的?欢迎留言聊聊。
参考资料
Turnitin:AI Writing Report 使用指南 OpenAI:AI 文本分类器及其局限 Stanford / Patterns:GPT 检测器对非英语母语写作者的偏差 研究论文:Can AI-Generated Text be Reliably Detected? Anthropic:Claude 文字水印如何工作 MSU Denver:AI、评价与学术诚信复核
#AI检测 #AI写作 #学术诚信 #教育 #人工智能
👆 关注我,持续拆解 AI 的能力与边界
💬 你遇到过 AI 检测误判吗?欢迎留言分享