ARTICLE · 1042326
介绍一个腾讯开源的文档转换模型:WeVisDoc
从论文、扫描件里复制内容,正文还算好办,公式和表格最让人头疼。腾讯开源的 WeVisDoc 可以直接读取文档页面图片,输出结构化 Markdown,公式转成 LaTeX,表格转成 HTML,方便继续编辑或交给知识库处理。
WeVisDoc 是基于 Qwen3-VL 微调的端到端文档解析模型,提供 2B 和 4B 两个版本,代码与模型均采用 Apache-2.0 协议。它面向论文、报告和扫描文档的结构恢复,更适合开发者或需要批量整理资料的用户。
项目地址:https://github.com/Tencent/WeVisDoc
项目主页:https://tencent.github.io/WeVisDoc
2B 模型:https://huggingface.co/Tencent/WeVisDoc-2B
4B 模型:https://huggingface.co/Tencent/WeVisDoc-4B
技术报告:https://arxiv.org/abs/2609.20423
核心功能
它把整页文档当作图片理解,同时恢复标题、段落、表格和阅读顺序。遇到论文里的数学公式,会输出 LaTeX;遇到多行多列表格,则输出 HTML,省去逐项复制和重新排版。
仓库支持 PNG、JPEG 和 WebP,可以处理单张图片,也能批量扫描文件夹。PDF 目前要先拆成页面图片。已有非空结果会默认跳过,适合中断后继续跑批量任务。
模型训练分成两轮。第一轮补齐文档类型、结构和画面质量,并合成保留版式的模糊、噪声等退化页面;第二轮再用独立样本查找剩余错误,把训练数据和输出 token 集中到薄弱类型。这也是它重点处理扫描件、低清页面和复杂公式的原因。
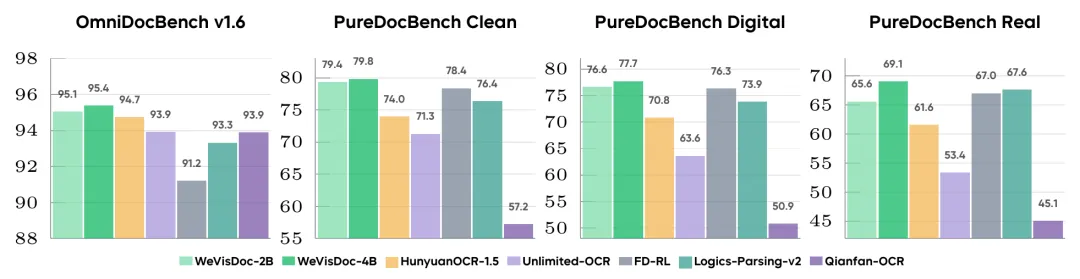
按项目公布的三次推理均值,4B 版在 OmniDocBench v1.6 得到 95.38,在 PureDocBench 三条赛道的平均 Overall 为 75.54。评测结果说明模型对数字文档和退化页面都有较好适应性,但真实效果仍会受图片清晰度、版式和输出长度影响。
安装与使用
环境需要 Python 3.10+。单张图片可以先用 Transformers 本地推理:
git clone https://github.com/Tencent/WeVisDoc.gitcd WeVisDocpython -m venv .venvsource .venv/bin/activatepython -m pip install -r requirements-local.txtpython -m wevisdoc.local --model Tencent/WeVisDoc-2B \ --image page.png --output results/page.md需要批量或提供接口时,按官方文档安装 requirements-vllm.txt,再运行 bash scripts/serve_vllm.sh Tencent/WeVisDoc-2B。官方脚本使用 Bash,Linux 环境更省事;2B、4B 都需要结合显存选择。本文未做本地推理测试,评测数字来自项目 README 与论文。