ARTICLE · 1045503
用AI去AI味,是把复印件再复印一遍:一个开源项目干脆说不玩了
2026 年,中文内容圈最热闹的两类生意摆在同一条产业链上:一类是检测器,按次收你"AI 率检测"的钱;另一类是"降 AI 率"工具,按千字收你洗稿的钱。检测器吓你一次,降 AI 工具救你一次,检测器再升级吓你一次。钱两头赚,焦虑两头卖。
有人靠这套循环赚得盆满钵满,直到一个叫"辞达(Cídá)"的开源项目出现。它做完自我介绍后说的第一句话是:我不做"去 AI 味",我不是来陪你玩这套的。
我研究了一下这个项目,先说结论:它不进场,不是清高,是因为它看出这场比赛根本不存在终点。
一、每个大模型都自带指纹,换个AI洗不掉
先说一个多数人不愿意听的事实:所谓"AI 味",不是一个玄学感觉,是统计。检测器能工作,本质上是因为每一家大模型的文本都带有自己的统计指纹——用词分布、句长节奏、连接词的铺法,连成一种可被机器量化的偏斜。
当前主流检测有一套广为引用的维度框架,拆开是五个:
- 困惑度:
逐字预测的意外程度 - 突发性:
句长和复杂度的起伏幅度 - 词汇丰富度:
用词多样性 - 语义聚类:
句与句之间信息重叠的密度 - 逻辑连接词模式:
转折、总结、递进词的铺排规律
AI 生成的文本在"困惑度偏低、突发性偏低、句子像工厂流水线"这三个特征上高度一致——各家 AI 检测的原理说明,几乎都建立在"模型文本分布与人类文本分布不同"这个假设上。
所以"用 AI 去 AI 味"这个思路,在一开始就藏着致命伤,行业内给它起了个名字:指纹问题。你想用另一个 AI 把 AI 文本改成"人写的样子"——可新 AI 自己也有指纹。你改完一层,只是盖上另一层印子。
这个判断不是玄学推演,有硬数据。2025 年 ACL 会议上一项叫 L2R 的研究直接测了"AI 改写 AI"这件事:大模型在改写另一个大模型生成的文本时,改动幅度很小(编辑距离约 0.14–0.16);而改写人类写的文本时,改动幅度明显更大(约 0.30)。
这个数据有多讽刺?它说的是:AI 对自己"同类"的文本几乎没话可改,可一旦碰上人写的、有判断、有私有经验的文本,它反而知道该动哪里。 这不是技术缺陷,这是 AI 的纹理本身——机器改写机器,改动自然趋近于零。
所以你用 AI 洗 AI 味,结果往往不是更接近人,只是从一种机器纹理,换到另一种机器纹理。
二、AI率可以降,完全消除是幻觉
看到这里你可能说:那退一步,不求"完全洗掉",把检测分数压下去总行吧?
对,AI 率确实可以降。检测器不是神谕,它靠的是统计判断;是统计判断,就能被针对性绕过。公开的降 AI 攻略说得很直白:做深度文本重构(把文本真的重写超过四成,而不是换同义词),假阴性率可以冲到 60%–80%。换个说法:只要肯下狠手改,检测器有六到八成的概率认不出你。
但请注意三个字——"可以降"。
第一,降是相对的。简单同义词替换这类"轻度操作"通常只能把 AI 率压低 10%–15%,离"安全线"差得远。真正有效的降法是深度重写,而深度重写基本等于重写一遍,那你还不如直接自己写。
第二,检测器会进化。知网 AIGC 检测已经迭代到 3.0 版本,从统计特征爬升到语义层面的分析;每家大模型的指纹也在被新的检测模型学习。你跟它赛跑,跑不赢,也跑不完。
第三,最要命的是军备竞赛没有终局。有个水印检测的公开测试:未重写时检出率 87.9%,单次重写降到 14%–41%,五次链式重写只剩 4.86%——听起来"洗得挺干净"对吧?可这恰恰说明只要规则是"检测 vs 逃逸",逃逸方永远能改出一层新皮,检测方永远会换一副眼镜。这个循环没有天然出口。
还有一记绝杀,来自行业最权威的玩家。OpenAI 自己做过的官方检测器,公开测试里真阳率只有 26%——五篇 AI 写的稿子,它大约只能认出其中一篇。最后它自己把检测器撤了,官方的解释很简单:这东西会误伤真实的人类写作者,代价不可接受。
把这三件事拼起来,得到的不是"去AI味技术不行",而是一个更冷的结构性结论:
可降的是统计特征;洗不掉的是"你为什么要写、你有没有判断、你有没有经验"。 后者不是文本的指纹,是人的指纹。
三、辞达说不,既是立场,也是计算
现在回到辞达。它选择不进场,既是立场,也是计算:既然"用 AI 去 AI 味 = 把复印件再复印一遍",既然"可降不可消"是死胡同,那一个想做表达质量的引擎,为什么要把自己定义成"帮你骗过检测器的工具"?
它在 README 里把话说得很硬,一口气拒绝了六类流行做法:
这六条拒绝是同一个逻辑的六张脸:它拒绝把"像不像 AI"当指标,只把"值得不值得读完"当指标。
最反常识的是第三条和第五条。市场上有大量教程教你"AI 味太重是因为太完美,要故意加几个口误、错别字"。辞达直接把这个行为叫"假装不完美",明着说这是拿人的缺陷当烟雾弹。而"不设禁用词表"更绝——你去翻它的反模式清单,会发现它连"首先其次最后""随着时代发展"都不禁。
它只问一件事:这个词在你这句话里,承担了真实的话语功能吗?承担,就留着;不承担,才删。机制先于规则,这是它全部方法论的底座。
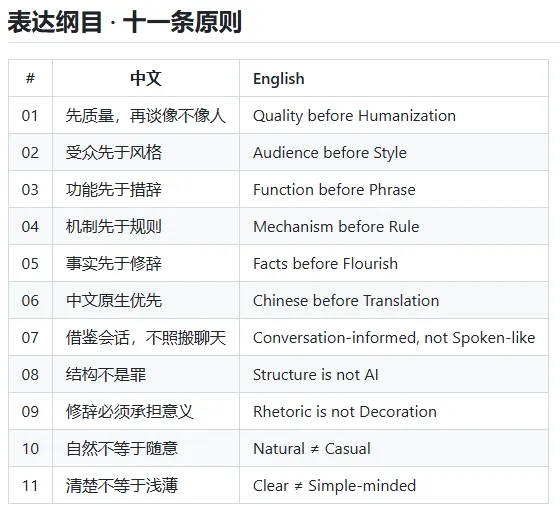
这种克制延伸到工程细节:它的知识库里是一个个"话语机制"节点(v1.0.0 发布时有 41 个),而不是一张禁词黑名单。它判断句子该不该改,靠的是"这句话有没有真实的交际功能",而不是"AI 是不是爱这么说"。
你甚至能在它身上看到一种罕见的倔强:官网一句话挑明"先质量,再谈像不像人";另一条原则叫"结构不是罪"——结构清晰不是问题,机械才是问题。它还把每一条诊断都收敛成同一个反问:"这句话真的是更好吗?",而不是"变化是不是更大"。
说白了,别人在教你怎么"装人",它在教你怎么"成人"。
四、它是怎么做的:先用十分钟装上,再体验它对表达的四层手术
光有立场不够,得能落地。辞达是个开源 Skill,安装路径门槛极低——它是纯指令文件,不写一行代码。
通用agent安装方法
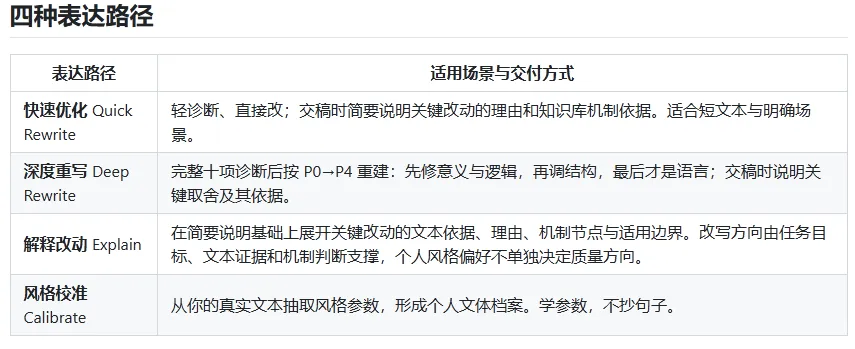
# Codex / OpenCode:克隆到项目目录即可# 仓库根部的 AGENTS.md 会被自动读取,引导进主流程git clone https://github.com/mizzlelover/cida.git装完怎么用?它提供四条路径:
- 快速优化 Quick Rewrite:
轻诊断直接改,适合短文本 - 深度重写 Deep Rewrite:
完整诊断后用 P0→P4 重建结构 - 解释改动 Explain:
逐项给出"为什么这么改"的文本依据和机制出处 - 风格校准 Calibrate
拿你喜欢的真实文本抽参数,形成个人文体档案——学参数,不抄句子
它的核心不是"润色",是一套诊断排序。最有价值的是它的执行顺序——P0 到 P4,先打值得打的仗:
P0 意义与逻辑 观点成立吗?论证断在哪?先修这个P1 结构与清晰 顺序、比例、详略——结构有问题时不许改词P2 流转与语域 衔接、过渡、正式度适配受众与平台P3 节奏与修辞 句长、停顿、修辞密度曲线、金句位置P4 打磨 措辞、用词精度、删繁我印象最深的细节是它对"金句"的态度。市面上大量 AI 写手稿是"每段一个金句",它管这叫金句通胀,还给了一句判断:"峰值一多,就全是平地。"它内置了一个"金句过滤器"——一句话想被强化成峰值,要过五项检验:是不是核心判断?是否压缩了前文?有没有新视角?离开上下文还站得住吗?落在论证线上吗?五过其三,才配峰值。
它甚至给你留好了公众号适配参数。打开它的 platforms/wechat/ 适配器,能看到一整套针对微信公众号的设置:段落偏短(两到三句为主)、每 300–500 字一个小标题、小标题用判断句而非话题词、开头 60 字内建立读者与问题的关系、金句峰值放小节末和结尾。它连平台腔都标出来了,明确警告:"震惊体开头、强行升华、'建议收藏'式乞讨、'深度好文'自封——这些不是适配,是谄媚。"
>>>我拿这个skill与humanizer、lieflat-less-ai-tone、huashu-proofreading 对同一段内容的实测优化,发现它属于机制驱动的高阶底座,这是最高级的skill写法。
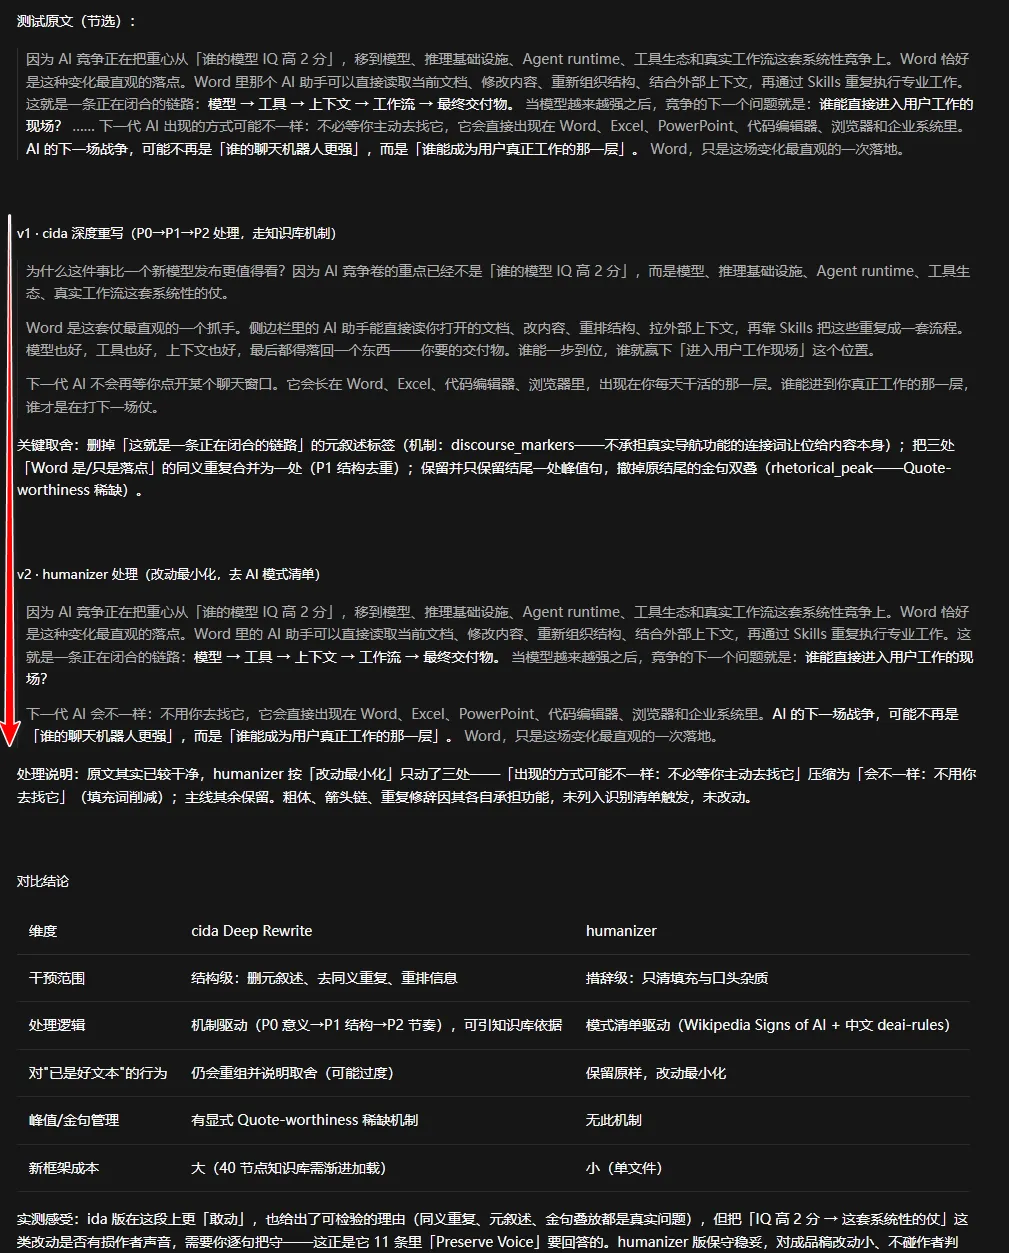
五、它解决不了什么,恰恰是它诚实的地方
按评测的规矩,该说说局限了。
辞达不承诺骗过检测器,这一点它写在明面上,而且理直气壮。它做的是"让文字值得被读完",如果你的目标就是"过查重",那大概率要找别家。
另外它仍是纯提示词驱动的知识库引擎,不写代码、不做本地模型推理,效果上限取决于宿主模型的底子,也依赖你对它的机制地图有基本耐心(41 个话语机制节点,不是洗个澡就全会)。
至于这套方法论在长文、口述转写等场景里的真实手感,我基于实测分析,认为这些"做不到",让它和满市场"AI 味 87%"的工具区分开。
所有声称"一键降 AI 率"的产品,都在帮你逃离同一个问题;而辞达做的事,是反手把那个问题换掉。
它不是换选手,是换赛道
回到开头那条产业链。检测器吓你、降 AI 工具救你、检测器再升级,这个循环为什么转得停不下来?因为双方共享同一个前提:AI 写的,就是要让人看不出来。
辞达把这个前提整个推翻了。它不跟你争"写得像不像人",它争的是"这段文字值得不值得被读完"。这是从逃逸游戏,换成了质量游戏——前者没有终点,后者永远有。
《论语》里有句话,大概被误读了几千年——"辞达而已矣",常被理解为"把话说通就行,别追求花哨"。可苏轼在《答谢民师书》里把它抬到了另一种高度:"能使是物了然于心者,盖千万人而不一遇也,而况能使了然于口与手者乎?是之谓辞达。"——把一件事看透,已是万里挑一;还能把它说清楚、写明白,才是辞达。
辞达的最高原则,跟"去AI味"是反着来的。它说:降低语言门槛,不降低思想门槛。
话说到这儿,问题就不该再是"怎么让 AI 写得不像 AI",而是一个更老、更难、也更值得的问题:你,到底有没有值得被读完的想法?
资源链接
辞达 GitHub 仓库 —
https://github.com/mizzlelover/cida
辞达官网 —
https://mizzlelover.github.io/cida