ARTICLE · 1047174
《Building AI Agents》拆解01:50行的ReAct Agent为什么会失控
这是《Building AI Agents: From Design Patterns to Production》的第一部分拆解。
全书主线已经压成五段(全书概览在上一篇:《Building AI Agents》全书概览:从 Agent Demo 到 Production,缺的是什么)。
这一篇先从 Ch1—4 开始,专门把“最小 Agent”这件事讲透:它怎样循环,为什么会翻车,以及后面为什么要补上 Prompt、Tool、Skill 和 Handoff。
先说结论:最小 Agent 不是“让模型多想几步”,而是把一轮一轮的输入、动作、工具结果和停止条件接起来。50 行 Demo 能证明 loop 跑得通,却不能证明它知道什么时候停、工具坏了怎么办、输出能不能继续被程序使用,更不能证明请求该不该交给另一个 specialist。
下面用一个问题贯穿:“LangGraph 和 CrewAI 有什么区别?”。它先是一个研究问题,模型要搜索资料、阅读页面,再给出带来源的回答。这个过程刚好把 Ch1—4 的最小 Agent 串起来:先有循环,再补 Prompt、Tool、Skill,最后才谈 handoff。书稿和仓库是作者的材料;工程归纳和验证方案是本文的判断,未运行的部分会明确标出来。
01|Agent 不是聊天,是一个会继续跑的 loop
普通 chatbot 往往是“一问一答”:收到文本,生成文本。Agent 多了一个关键动作:生成的不是终点,而是下一步动作。它可能要搜网页、读文件、调用 API;工具返回后,系统再把结果交回模型。
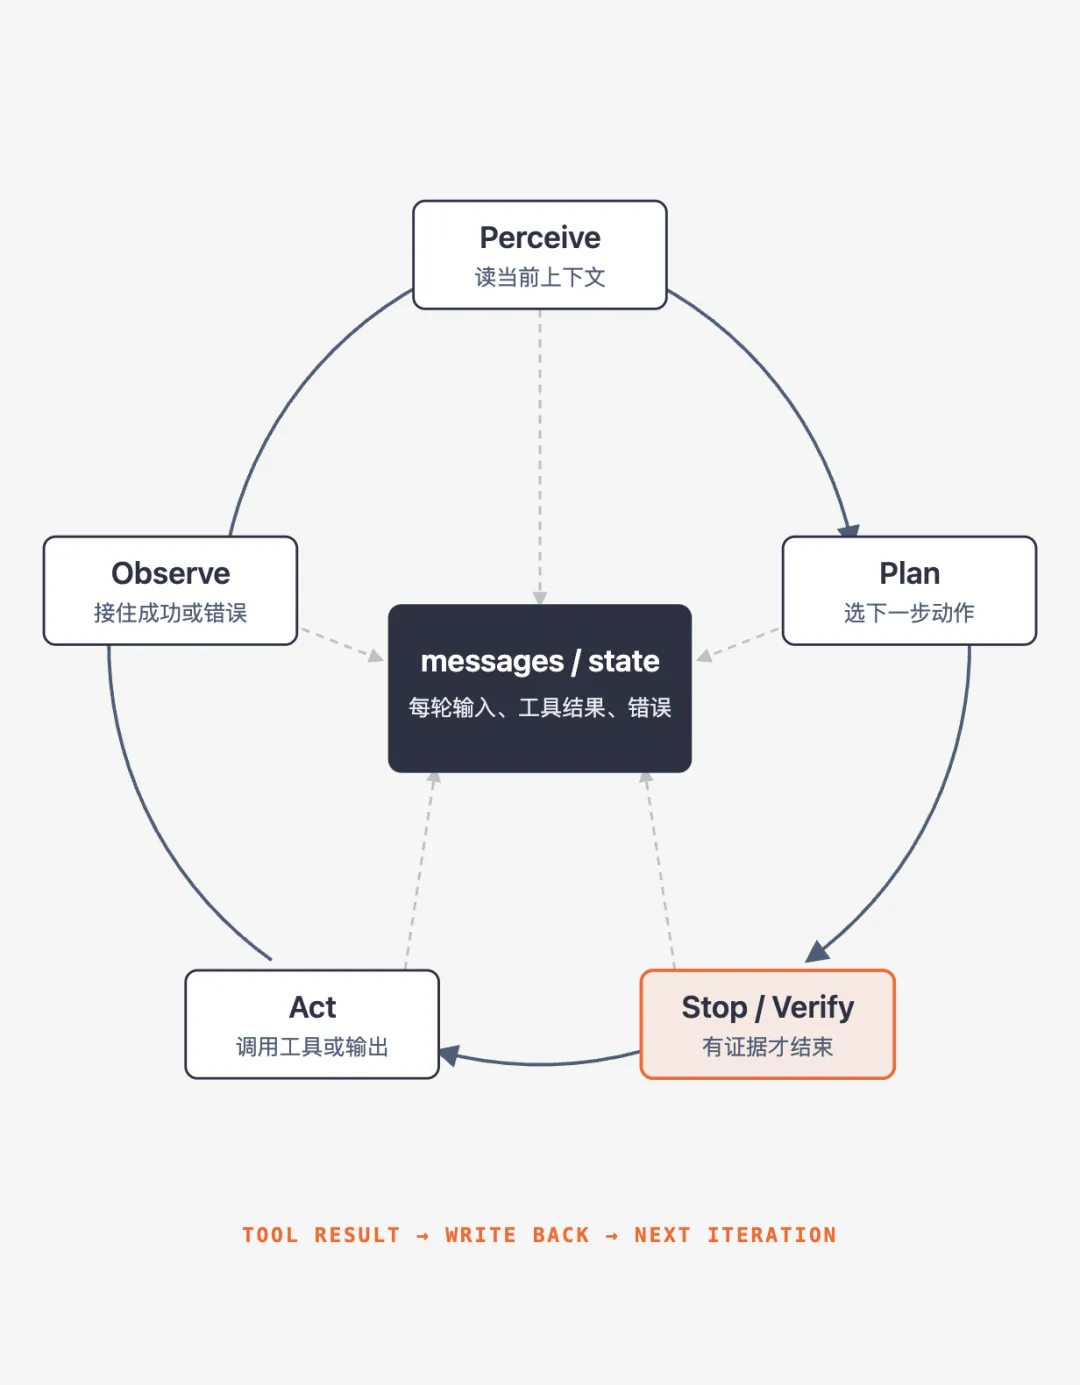
这就是书稿 Ch1 里最小的 ReAct(Reasoning and Acting)循环。这里先不把它神秘化,直接看数据怎么走:
user question→ messages→ model: tool_call(search_web, {query: ...})→ tool result→ messages→ model: final answer 或下一次 tool_call
在官方 repo 的ch01_react_from_scratch/atlas_v01.py里,messages保存上下文,tools描述可调用函数,工具结果以role: "tool"写回;MAX_ITERATIONS = 6则是最后一道保险。书稿里说的“约 50 行起步”是最小思路的概括,不是这个文件的精确行数;当前文件还包含搜索、网页抽取和命令行入口。
所以,Agent 的最小单位不是一个 Prompt,而是一段受约束的循环控制流。没有上限,它可能重复搜同一个词,或者在工具失败后继续自信地编答案,最后烧掉 API 费用。
02|Perceive、Plan、Act、Observe,每一步到底在干什么
把刚才的问题跑一遍,四个词就不抽象了:
- Perceive(感知)
读入用户问题、已有 messages,以及上一轮工具结果。此刻输入是“比较 LangGraph 和 CrewAI”,不是一张白纸。 - Plan(规划)
模型决定下一步要补什么证据。比如先搜两者官方文档,而不是直接凭记忆下结论。这个计划可以只存在于当前响应的 tool call 里,也可以被显式记录下来。 - Act(行动)
执行模型选中的函数,例如 search_web(query)或read_url(url)。真正改变外部世界的写操作,也发生在这一层。 - Observe(观察)
把工具的成功结果或错误结果追加回 messages。下一轮 Perceive 读到的,必须是这份更新后的状态。
注意,Observe不是“人看一眼日志”这么简单,而是状态写回协议。少了tool_call_id、工具名或错误文本,模型就不知道刚才发生了什么;把结果直接拼进一段自然语言,也会让后续程序难以判断“这是数据、错误,还是最终答案”。
停止也属于循环的一部分:模型没有 tool call,才可以把当前内容当作 final answer;达到最大迭代次数,则必须返回明确的失败状态。两者都没有时,Demo 只是一直转。
03|从 loop 到 Ch2—4:Prompt、Tool、Skill、Handoff 怎么补缺口
第一层缺口是Prompt Architecture。Ch2 把 prompt 拆成 Identity、Instructions、Context Injection、Output Constraints 四层。大白话就是:你是谁、要做什么、眼前有哪些资料、最后必须长什么样。它不是文案,而是写给 loop 的 operating instructions。官方prompt_ab_test.py用多个 variant 和 eval case 对比关键词、拒答、tool call 与 latency;“看起来更会说”不等于行为更稳定。
第二层是Tool Calling 与 Structured Output。Tool 是一个函数加 JSON Schema,模型只能请求符合 schema 的参数;程序执行后,再把结果写回上下文。Structured Output 则把最终结果约束成可校验结构,例如{summary, sources, confidence},比用正则从自由文本里抠字段可靠。Ch3 的SkillRegistry继续往前走:WebSkill管搜索和读页面,FileSkill管文件,CodeSkill管执行;Skill 是一组带共享配置、错误处理和权限边界的工具,不是“工具的高级别叫法”。
第三层是Handoff。如果用户问的是“发票重复扣款”,研究 Agent 不该硬撑。Ch4 的 triage 示例用一个 Router 把请求交给 Billing、Technical 或 General Specialist。它适合任务彼此独立、一个 specialist 能完整处理的场景;如果多个 Agent 必须共享状态、共同编辑一个结果,或者需要协调恢复,简单 handoff 就不够了。
这四章连起来的真实顺序是:先让循环能跑,再让每个动作有契约,最后才决定是否把责任交给另一个 Agent。别急着一上来就堆复杂 orchestration framework。
04|最小验证:故意让它失败一次
下面是一个还没运行的实验方案,不是实测结果。固定问题“LangGraph 和 CrewAI 有什么区别?”,固定模型和预算,给search_web人为返回一次Error: timeout,记录每轮:iteration、messages数量、tool name、args、result、是否 final。
重点看五件事:
错误有没有以结构化的 tool result 写回,而不是被吞掉; 下一轮是重试、换查询,还是直接编答案; 达到最大迭代次数后是否停止; 证据不足时是否说“无法确认”,而不是伪造来源; 最终输出是否能通过 schema 校验,并统计 tool calls 与总耗时。
如果这五项都答不上来,Demo 再短也只是一次成功的演示,不是可靠的 Agent。下一篇继续往第 1 章深挖:把这段 loop 拆到代码级,看看 50 行里哪些行一删,系统就开始不可靠。
你现在的 Agent 最先暴露的,是没有停止条件、工具错误没写回,还是输出根本没有可校验的结构?
这里是「Suvi搞AI」。边做 Agentic 产品,边把 AI 搞明白。
参考资料
核对日期:2026-09-20。以下事实来自作者公开书稿和官方 repo;本文没有运行模型调用或工具故障实验。
[1] Antonio Gulli、Anant Nawalgaria,Building AI Agents: From Design Patterns to Production,公开书稿:
https://docs.google.com/document/d/1keM4ZbbfVmdsq3EAkbAliIegOpnnuBf-_KpD4oDOF0o/edit
[2] 官方配套代码仓库,agulli/atlas-agents:
https://github.com/agulli/atlas-agents
[3] Ch1 示例:ch01_react_from_scratch/atlas_v01.py;Ch2 示例:ch02_prompt_architecture/prompt_ab_test.py。
[4] Ch3 技能注册与执行:shared/skills.py;Ch4 handoff 示例:ch04_handoffs/triage.py。