ARTICLE · 1047896
彻底击穿本地AI神话!微软联手顶尖学者破译:仅凭CPU微小抖动,私密大模型全被看光
为了逃避云端大厂的隐私窥探,无数人把大模型搬回了个人电脑。
断开网线,关掉 Wi-Fi,启动本地的 Ollama、Llama.cpp。屏幕前,你在和模型推敲商业机密、诊断敏感病情、编写核心代码。
你以为,所有的思考都锁在自己的固态硬盘和独立内存里。
大错特错
近日,以色列本杰古里安大学(Ben-Gurion University)与微软安全团队(Microsoft Security)在学术预印本平台 arXiv 上联合发布了一篇震撼业界的重磅论文:《Detokenization Leaks: Reconstructing Local LLM Outputs From Cache Traces》。
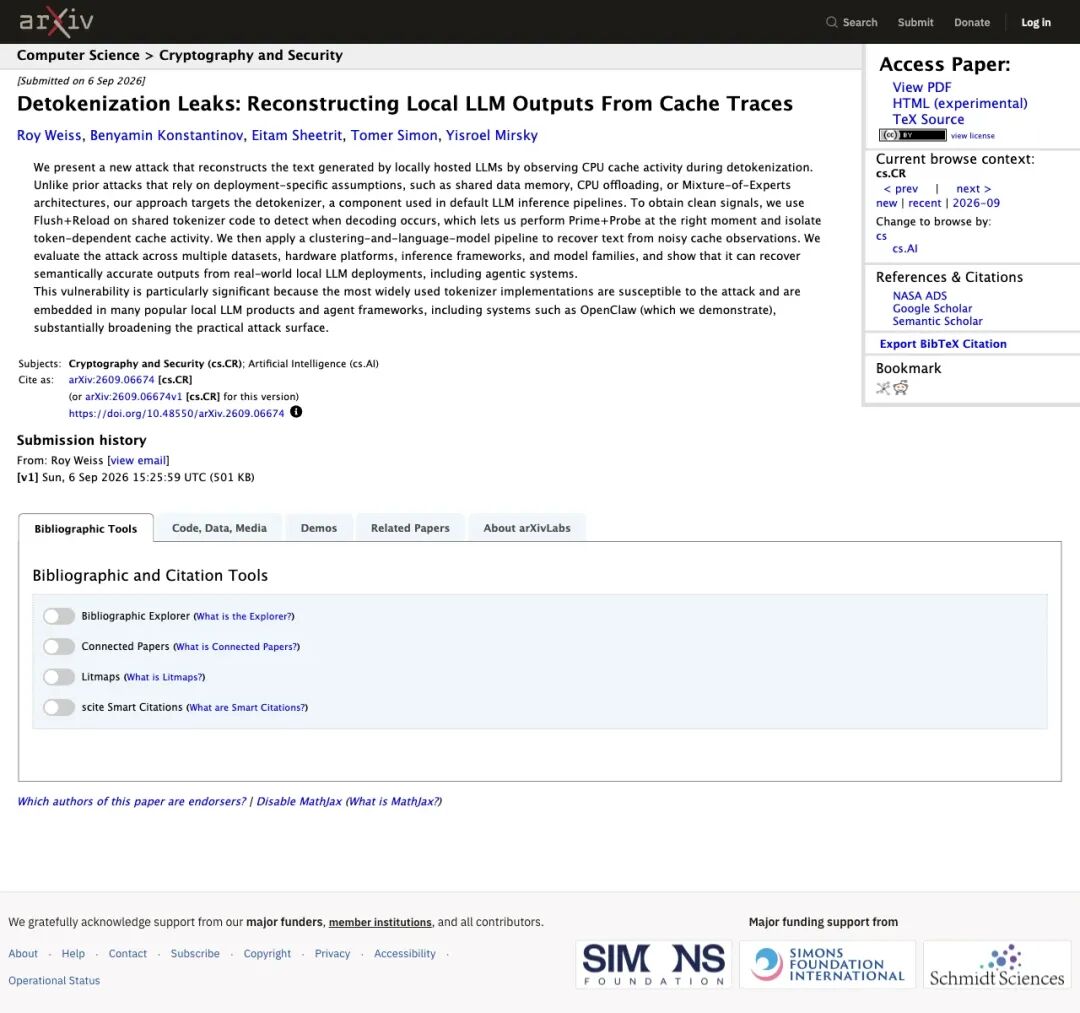
▲ 微软与本杰古里安大学联合发布的重磅论文:arXiv:2609.06674
研究给出了一个令开源 AI 社区高度警惕的结论:只要你的电脑后台正跑着一个普普通通、毫无管理员权限的流氓软件,攻击者就能通过监听 CPU 缓存的微小物理时序抖动,把你和本地大模型聊的每一个字逐步拼凑出来!
攻击过程无需管理员权限,不必触碰模型权重或操作系统核心,也无需读取显存。
物理隔绝的网络神话,在底层芯片的微架构侧信道面前,瞬间崩塌。
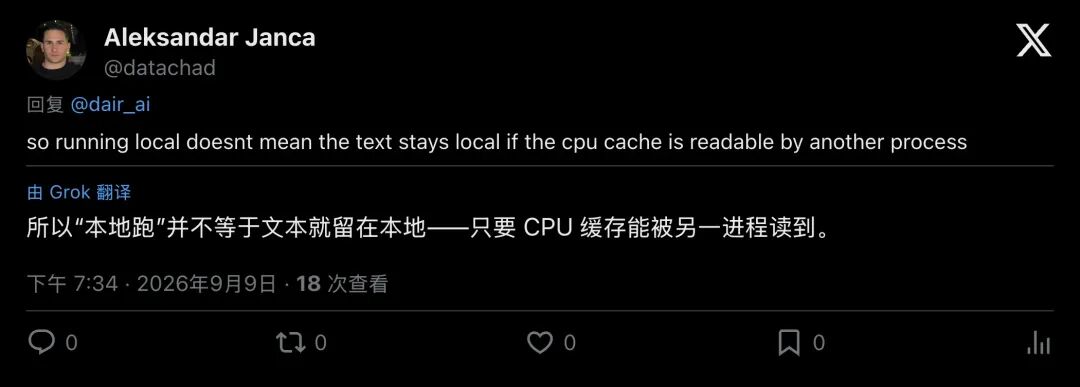
▲ 社区安全研究员评论:即便将大模型部署在本地,文本也可能因底层硬件共享而外泄
致命阿喀琉斯之踵:大模型把“字典”摊在了阳光下
很多人好奇:大模型明明运行在 GPU 或受保护的内存里,黑客怎么可能仅靠看一眼 CPU 就知道模型在说什么?
答案藏在所有现代大模型推理流水线中,一个容易被忽视的步骤,去分词(Detokenization,即解码)。
大模型的底层运转完全基于数字
在模型内部,字词会被切碎成一个个 Token(标记),对应着纯数字编号(Token ID)。比如,一句话生成出来,在模型核心其实是一串类似 [15496, 1284, 891] 的整数序列。
要把这串数字变成人类屏幕上能读懂的文字,系统必须在 CPU 上去查一张巨大的解码表(Decode Table)。这就像拿着一本对应表,看到数字 15496,就去表中查找对应的汉字。
漏洞的源头,就出在这本“字典”上
为了速度,开源生态(包括 Llama.cpp、Hugging Face Tokenizers 等)几乎都把这个反向查表的过程放在 CPU 上执行,并且使用系统共享的动态库。
当大模型以每秒几十个词的速度连续输出时,CPU 就会以惊人的频率连续读取这张解码表的不同内存位置。
每一个生成的字,都在 CPU 缓存里留下了可追踪的物理时序特征。
芯片级监听:给 CPU 贴上两支“微型听诊器”
CPU 为了提升运算速度,会在芯片内部设立极快的小仓库,CPU 缓存(Cache)。
不同程序在同一个物理核心上交替运行时,其实在共享这些缓存空间。
如果程序 A 刚刚读过某块数据,这块数据就会留在缓存里;如果程序 B 此时去读同一位置,速度就会快得不可思议(缓存命中)。反之,如果速度很慢,说明程序 A 刚才根本没碰过这里。
这种不读明文、全凭访问速度快慢来刺探情报的手段,在计算机安全领域被称为侧信道攻击(Side-Channel Attack)。
微软与本杰古里安大学的研究团队,在芯片级维度布置了精妙的“两步协同探测”:
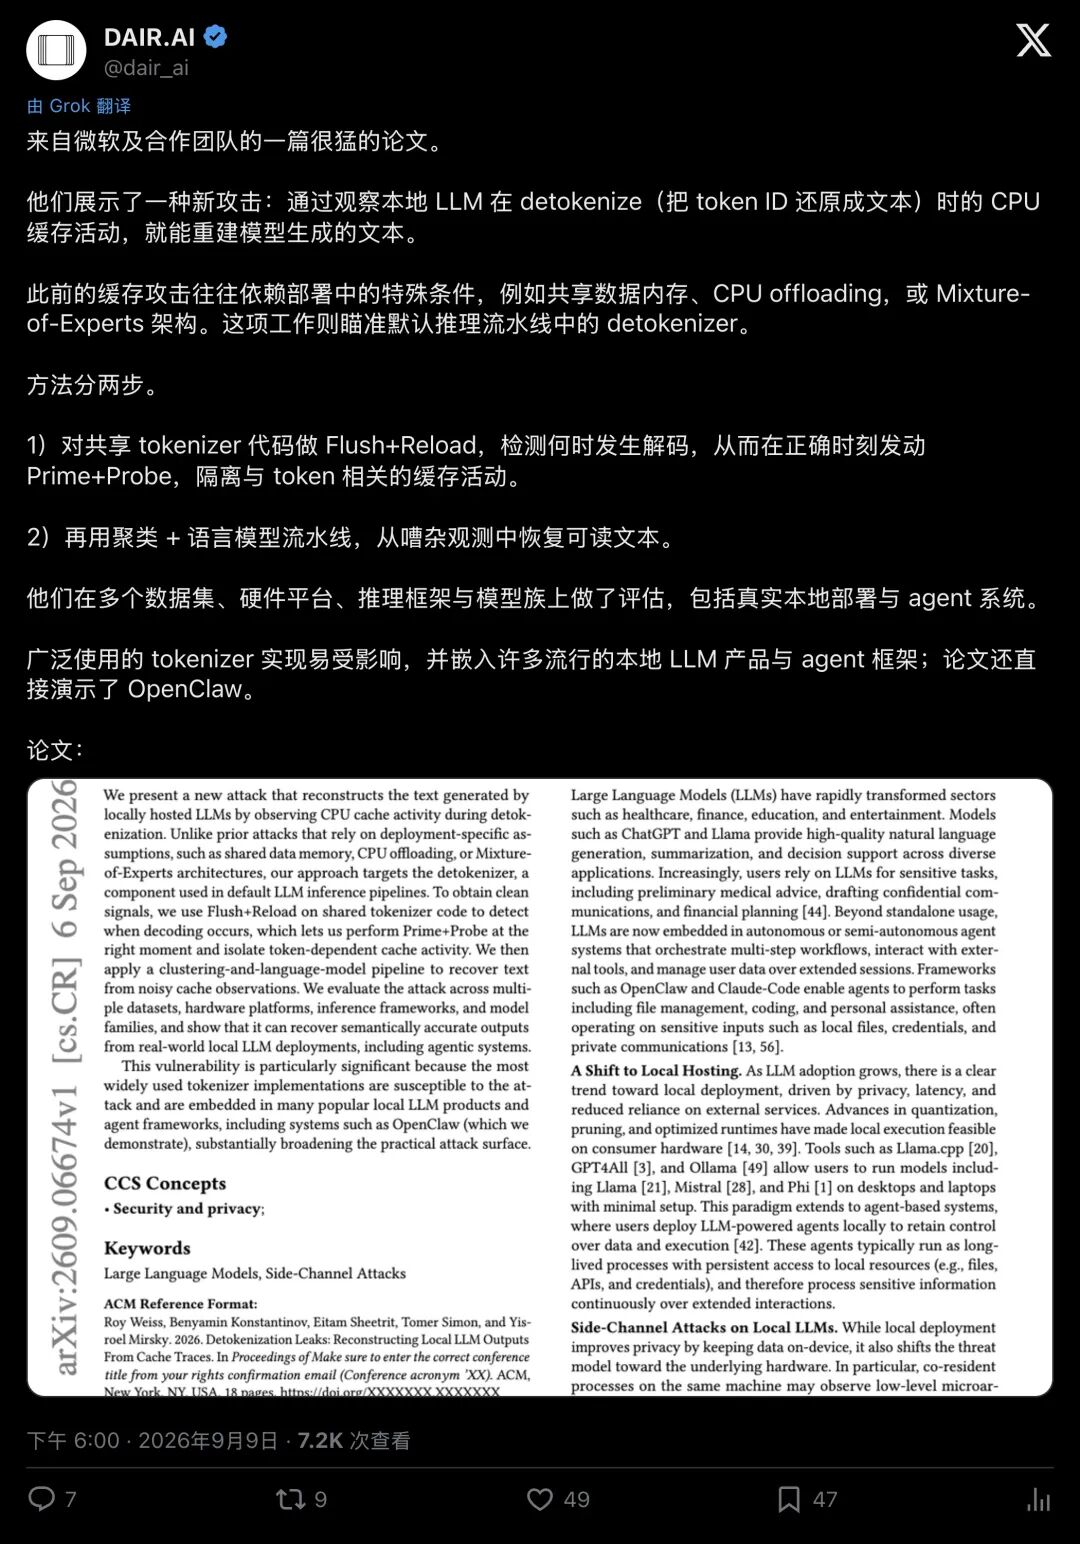
▲ DAIR.AI 对该论文核心机理的两阶段拆解
第一步:按响门铃(Flush+Reload)
攻击程序先利用经典的 Flush+Reload 技术,盯住系统共享库里的 tokenizer 代码页。大模型刚准备查表解码的前一刻,攻击者便能通过共享指令页的时序变化,获知模型即将输出下一个 Token。
第二步:听取脉搏(Prime+Probe)
在极其狭窄的时间窗口内,攻击线程在同一 CPU 核心上对最贴近核心的 L1 高速缓存 执行 Prime+Probe 探测:攻击者先用自己的数据填满 L1 缓存的各个组槽位(Prime);大模型一旦查表,就会将攻击者的数据挤出缓存;攻击者随后测算自身槽位的重新加载速度(Probe)。出现延迟的槽位,正是大模型刚刚查表触碰的内存位置。
一秒钟内,这套组合动作重复数十次一段记录着 CPU 内部缓存访问特征的时延向量,就这样被完整采集下来。
AI 破译 AI:在混乱噪点中重塑人类思想
理论很清晰,但实际环境极为复杂
L1 缓存的组数非常少(通常只有 64 组),而现代大模型(如 Llama-3、Phi-3)的词表大小高达 32,000 到 128,000 个。
因此,几十甚至上百个不同的 Token 在查表时都会挤进同一个缓存槽位。这好比把 10 万个词条分装进仅有的 64 个抽屉,单凭某一次抽屉的微小碰撞,根本无法直接判定具体触碰了哪个词。
在传统密码分析视角下,此类充满高度碰撞和环境噪点的信道,往往被视作极难还原的难题。
研究团队提出了全新的破译方案:利用另一个预训练语言模型来进行语义重构。
研究人员将采集到的粗糙缓存时延向量进行聚类,转化成离散的符号序列。随后,微调后的语言模型(如 Flan-T5-XL)登场充当破译中枢。
破译模型不仅参考当前的缓存符号,更结合前文已重构的上下文进行联合概率推断。
上下文的语义先验,化解了局部槽位带来的大量歧义。
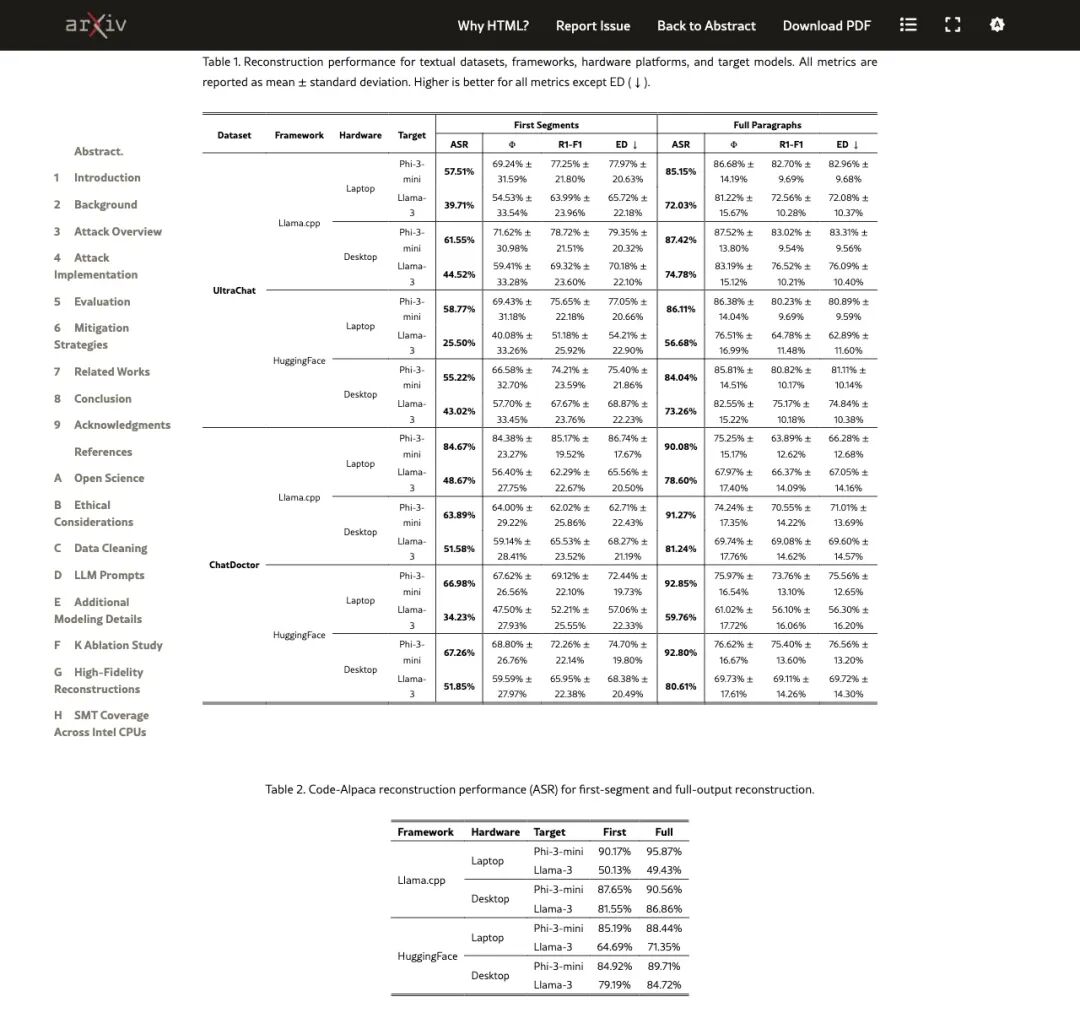
▲ 论文详细评估了在各种基准任务下的文本语义恢复能力
在针对医疗问答(ChatDoctor)、通用对话(UltraChat)以及代码生成(Code-Alpaca)的测试中:
- 通用对话重建成功率(ASR)达到 56%~87%
,语义相似度最高达到 87%; - 医疗问答的重建成功率达到 93%
; - 代码任务在部分配置下,功能等价重建率达到 85%~96%。
即便在第 13 代 Intel i9 处理器上,面对复杂的硬件预取噪声,攻击者依然能保持 30% 以上 的稳定捕获率。
该成果展示了极具冲击力的攻防新思路:借助现代 AI 强大的推断能力,穿透底层芯片微架构的物理侧信道缺陷。
现实杀伤力:当长驻 AI Agent 沦为全天候“内鬼”
很多工程师可能会辩解:“这不过是实验室里的精巧概念验证,现实中谁会坐在那让我几十次地测算?”
为了击碎这种侥幸心理,研究团队将攻击直接架设在开源 Agent 运行时 OpenClaw 上进行了实测。
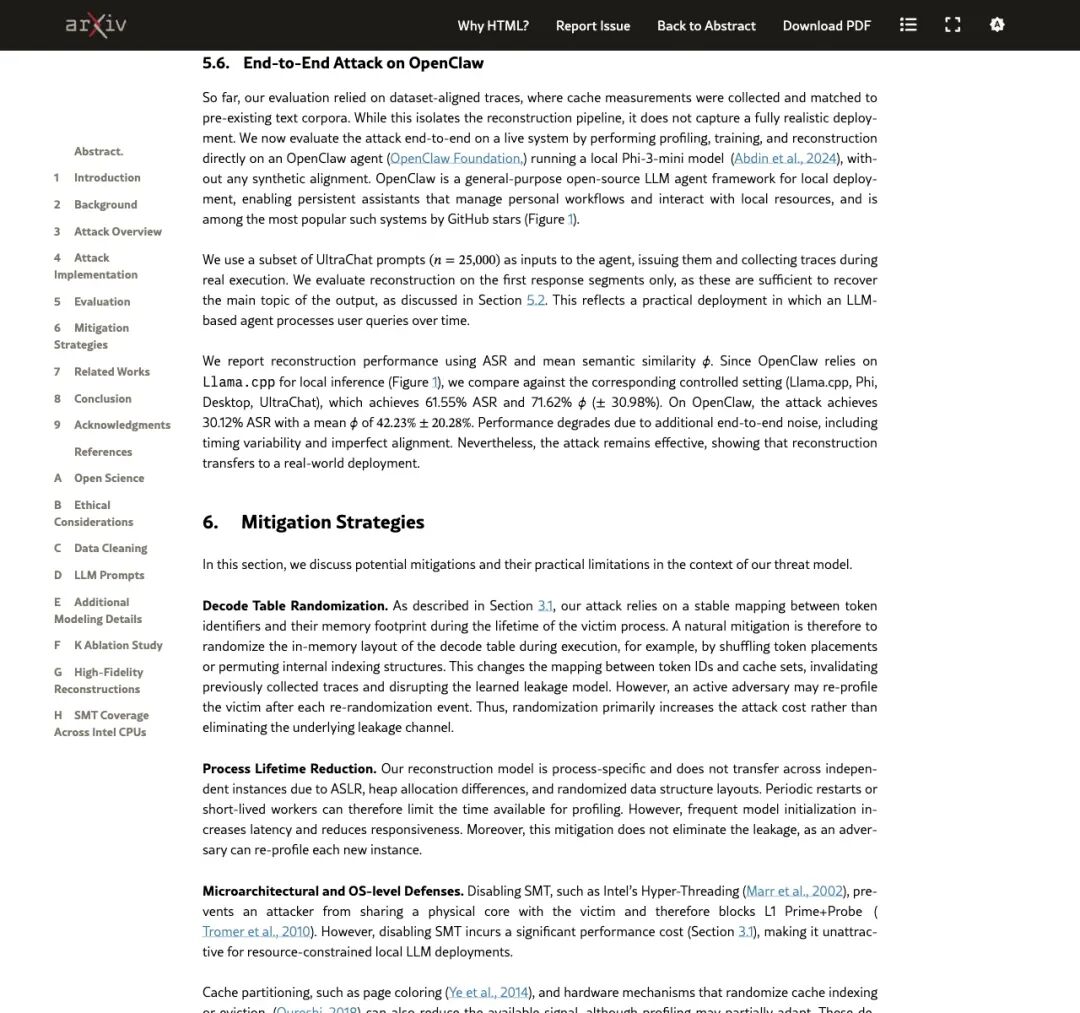
▲ 论文 5.6 节记录了在开源 Agent 项目 OpenClaw 上的端到端实测结果
现在的开发者为了极致效率,往往会在本地让 AI Agent 7×24 小时挂载运行。这些智能体手握你的本地文件、终端权限、邮件往来和私密浏览器会话。
对于攻击者而言,这简直是梦寐以求的狩猎场:
- 无需特权:
恶意软件可以伪装成一个无害的 VS Code 代码插件、一个桌面小工具; - 长效标定:
Agent 在后台持续处理真实工作流,攻击者有数小时甚至数天的时间慢慢校准(Profiling); - 精准收割:
只要 Agent 正在为用户总结私人邮件或生成涉密代码,后台的监听进程就能同步还原出高达 30%~42% 的语义片段。
在这个数字化代理人时代,你赋予本地 AI 越多的系统特权与核心机密,侧信道泄漏的致命一击就越具有毁灭性。
撕开侧信道全景图:大模型时代的“无声谍战”
把视野拉大,你会发现《Detokenization Leaks》绝非孤例。它标志着大模型安全研究已经从“提示词注入”和“网络抓包”,延伸至底层硬件微架构层面的攻防对抗。
回顾近年来的技术演进,一条值得警醒的侧信道演进脉络十分清晰:
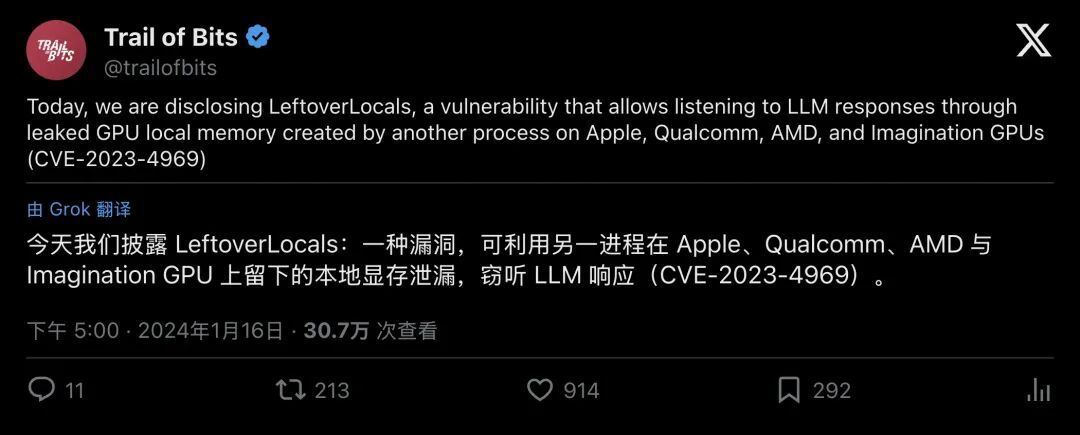
▲ 2024 年 Trail of Bits 披露的 GPU 显存残留漏洞 LeftoverLocals (CVE-2023-4969)
- GPU 显存层面的失守(LeftoverLocals):
2024 年初,Trail of Bits 爆出 CVE-2023-4969,证明在苹果、高通、AMD 等 GPU 上,未清零的本地显存残留能让共驻进程捞出数以兆字节的模型响应; - 模型权重与嵌入层防护失效(I Know What You Said & Spill the Beans):
2025 年的研究指出,若使用共享内存映射(mmap),攻击者通过观察嵌入层查表也能反推 Prompt; - 云端加密网络的被动泄密(Whisper Leak):
微软与 Mirsky 团队曾证明,即便流量全走 TLS 加密,仅靠数据包到达的时序与体积,就能推断你在和远程 AI 聊什么敏感话题; - 默认流水线的无死角击穿(Detokenization Leaks):
到了今天,本篇论文彻底剥离了“特殊配置”、“共享数据页”等苛刻前提,直接把刀口对准了每一个本地运行时都无法绕过的 Detokenizer。
▲ 微软安全官方此前深度剖析的远程与微架构侧信道矩阵
云端怕流量形态,本地怕进程共驻曾经被开发者视为最后避难所的“单机断网”,在物理共享的硅晶片面前,变成了一层自欺欺人的窗户纸。
终局代价:安全与性能的现实权衡
如何防御这种来自芯片深处的窥探?
研究团队在论文中评估了多种缓解策略,但每一种方案都需要付出显著的工程代价:
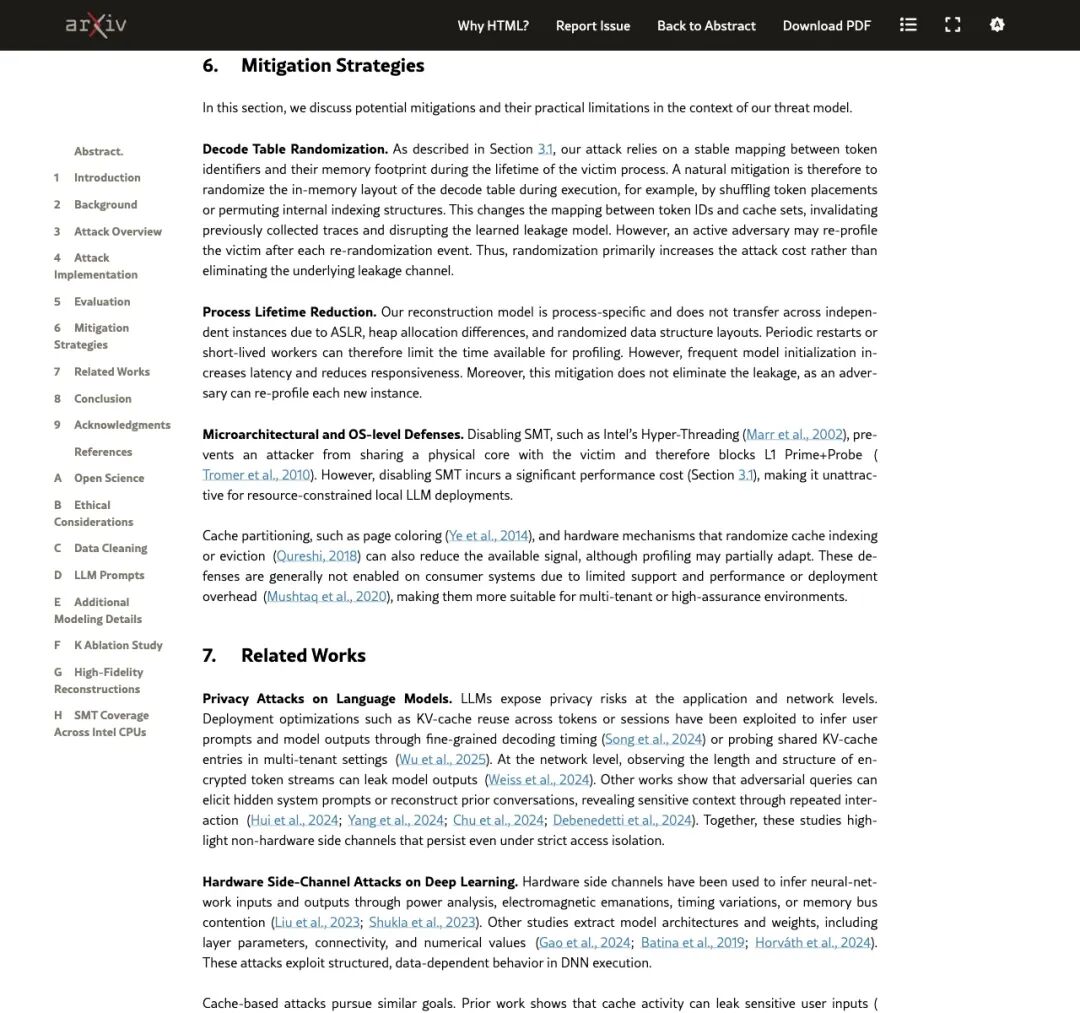
▲ 论文第 6 节列出的缓解策略及其代价讨论
- 关闭超线程(SMT / Hyper-Threading):
切断攻击者与受害者共用物理核心 L1 缓存的物理基础。代价:整机计算性能瞬间蒸发 25% 到 35%,这对于本就吃紧的本地大模型推理而言堪称灾难; - 常量时间查表(Constant-time Detokenization):
无论解码哪个 Token,强行把整张解码表都扫一遍,抹平访问痕迹。代价:吞吐量暴跌,推理延迟成倍拉长; - 运行时动态打乱解码表(Randomization):
每次启动或定期打乱内存排布,增加黑客标定难度。代价:攻击者只需多花几分钟重新抓取基准,治标不治本; - 频繁杀死重启推理 Worker:
增加冷启动开销,用户体验被彻底撕裂。
在底层硬件没有迎来彻底的缓存物理隔离架构革新之前,安全与算力之间,不存在免费的午餐。
这篇论文给所有信奉“本地即安全”的科技从业者敲响了警钟:
大模型的安全边界由多层体系共同构成。只要本地应用仍在与未经验证的软件共用同一块 CPU 与物理缓存,底层的微架构访问特征就可能成为数据外泄的隐秘通道。