ARTICLE · 1050219
物理AI工程师:做了五年降阶建模,我为什么开始用AI Agent跑流程
发布时间:2026-09-21 12:46:17 最近访问:2026-09-21 12:46:17
物理AI工程师:做了五年降阶建模,我为什么开始用AI Agent跑流程
导读:大家好,我是一名研发工程师,来自成都柯西姆物理AI部。 长期从事工程仿真与物理AI交叉领域的技术研发和工程应用,聚焦结构、流体、热及多物理场仿真,具备从高保真建模、仿真数据处理、算法开发到结果验证的完整技术经验。关注降阶建模、代理模型、动态模态分析、机器学习和AI智能体等技术方向,致力于推动人工智能在仿真流程自动化、工程结果快速预测和数字孪生建设中的应用,为复杂工程问题提供高效、可靠、可复用的智能化分析方法。最近被问得最多的一个问题是:"AI到底能不能真正用到仿真里?"
说实话,这个问题我前两年也在问自己。那时候AI大模型刚火,各种"AI颠覆仿真"的说法满天飞,但真落到项目里,你会发现——口号喊得再响,模型还是得自己建,网格还是得自己画,算例跑崩了还是得自己半夜起来调。我做工程仿真快速预测这块快五年了,从最早的代理模型、POD降阶,到后来的机器学习、数字孪生,踩过的坑不少。今天想聊聊这些年的真实感受,以及为什么我最近开始认真对待"AI Agent驱动仿真"这件事。一、先说一个最常见的坑:数据准备比模型训练重要十倍
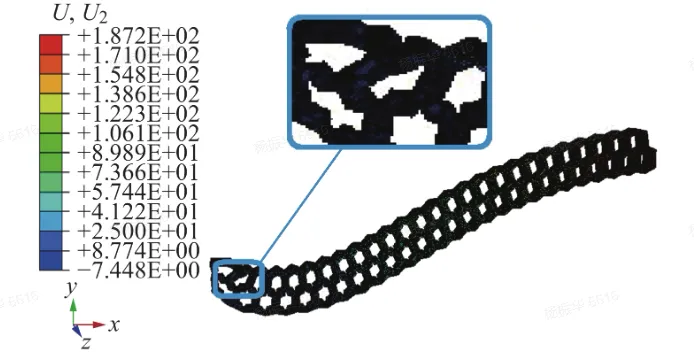
有限元应力云图—仿真工程师最熟悉的画面,但快速模型的数据准备往往被忽视
很多人一上来就问:"用什么算法最好?KAN比神经网络强吗?GPX和克里金哪个准?"我的回答通常是:先别急着选算法,先看看你的数据对不对。去年做一个动压轴封的项目,目标是根据液膜厚度、压差和转速,预测液膜静面压力。听起来不复杂,就是个三输入一输出的代理模型问题。我们用GPX建模,61组样本训练,预测结果看起来也挺光滑的。但后来做验证的时候发现了一个问题:有几组工况的预测值总是偏高,而且偏差很有规律。排查了整整两天,最后发现——CSV文件里有三行数据的顺序和对应的仿真结果文件对不上。就这么一个低级错误,模型训练照样能跑完,损失曲线照样下降,预测云图照样能出。但它学的是错的映射关系。这种问题最危险的地方在于,它不会以软件报错的形式出现。你看到的是一个"训练完成"的模型,输出的是看起来很合理的数值,但实际上已经偏了。所以现在做任何快速预测项目,我第一件事不是选算法,而是建一张数据核对表:样本编号、工况参数、结果文件名、单位、数据类型——全部一一对应,自动核对数量和名称,过不了这关,后面的都免谈。二、场预测比标量预测难在哪?
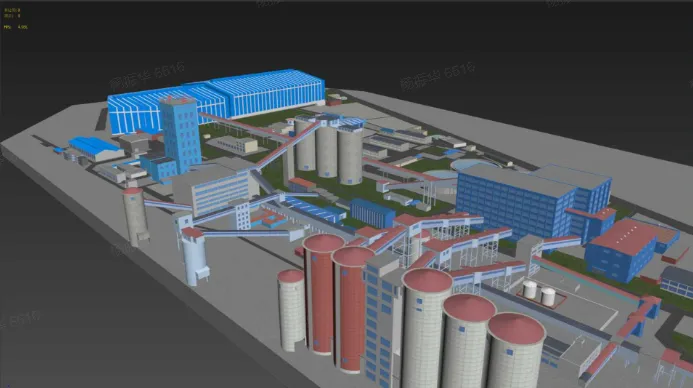
数字孪生三维模型—场预测需要把高维的仿真结果压缩到低维空间,再学习参数到响应的映射
如果说标量预测(比如预测一个压力值)的坑主要在数据,那场预测(比如预测一整个应力场)的坑就要多得多了。我们做过一个泵壳的HPC ROM项目,输出是原始网格上的von Mises应力场。直接让模型去学每个网格点的应力?不可能——维度太高了,31组样本根本不够看。常规做法是先用POD提取主要变化模态,把高维的场数据压缩成低维的系数,再学输入参数和这些系数之间的关系。听起来很标准对吧?POD截断到多少阶合适? 很多人喜欢用99%能量保留率作为标准。我也用过,但后来发现——能量保留率高,不代表你关心的区域就准。最大应力的位置准不准?局部应力集中区有没有被"平均"掉?这些光看能量百分比是看不出来的。我们那个泵壳案例,23个模态系数,99%以上的能量保留率,但关键区域的重构误差还是得逐张云图去对比。阶数选少了,细节丢了;选多了,后面的回归模型容易过拟合。这个平衡点,只能靠对工程问题的理解去把握,没有万能公式。回归模型选多大的?31组样本,你敢用很深的网络吗?不敢。样本太少,模型容量太大,过拟合是分分钟的事。我们用的是两层、每层8个单元的轻量KAN,还加了提前停止。就这,还得留独立样本做验证,盯着最差工况的误差。很多人有个误区:训练损失降得低就是模型好。其实不是。训练损失低只说明模型记住了训练数据,不代表它能预测新工况。这个道理说起来都懂,但真看到损失曲线哗哗往下掉的时候,总有人忍不住兴奋。三、验证,验证,还是验证
我经常跟团队说一句话:快速模型不是用来替代高保真计算的,是用来把高保真计算集中到真正需要复核的工况上。这句话的前提是——你得知道哪些工况可以用快速模型,哪些不行。第一层,验证数据和流程。样本是不是一一对应?单位是不是一致?降维基和预测模型是不是配套的?这层是基础,基础错了后面全白搭。第二层,验证数值精度。拿没参与训练的独立样本算误差,平均误差要看,最差工况的误差更要看。如果大误差都集中在参数边界或者样本稀疏的地方,那就说明该补样本了。第三层,验证工程合理性。趋势对不对?量级对不对?极值位置对不对?有没有出现负值或者违背物理常识的结果?这层最考验工程师的功底,也是软件代替不了的。只有三层都过了,这个模型才敢放进稳定的参数筛选流程里。而且每次预测之前,还得先判断输入是不是落在训练范围内——接近边界的加个提醒,超出范围的直接标外推,绝不能把预测值直接当设计定值用。四、那AI Agent到底有没有用?
工业AI与智能制造——AI Agent的价值不在于替代工程师,而在于把人从重复操作中解放出来
说了这么多"慢功夫",好像跟AI没什么关系。其实恰恰相反,正是因为这些基础工作太重要、太繁琐、又太容易出错,我才觉得AI Agent有真正的价值。你想想,刚才说的这些步骤——数据核对、POD分解、模型训练、结果验证、可视化输出——每一步都要人工去点、去配、去检查。一个完整的降阶建模流程,十几个节点串下来,光操作就得大半天。而且人操作就难免出错,漏了一步、配错一个参数,后面全错。AI Agent能做什么?它能把这套流程"串起来、自动跑"。你告诉它"我要做一个泵壳的降阶模型",它去调数据、建流程、配参数、跑训练、出验证结果,最后把报告交给你。区别在于,脚本是死的,Agent是活的。脚本只能跑你预先写死的流程,数据格式变一变、工况数变一变,脚本就崩了。但Agent能理解你的需求,能根据数据情况调整流程,遇到问题能自己尝试解决——至少是简单问题。更重要的是,Agent降低了门槛。一个刚入门的工程师,可能搞不清POD怎么设、KAN几层合适、验证指标怎么看,但他可以跟Agent说"我要建一个应力场的降阶模型,精度要够工程用",Agent帮他把基础流程搭起来。他只需要在关键节点做工程判断就行。当然,我不是说Agent能代替工程师。工程判断——哪些区域必须准、哪些误差可以接受、外推的边界在哪里——这些还是得人来。但Agent可以把人从繁琐的重复操作里解放出来,让工程师把精力花在真正需要判断力的地方。五、9月23日,我想把这套流程完整演示给你看
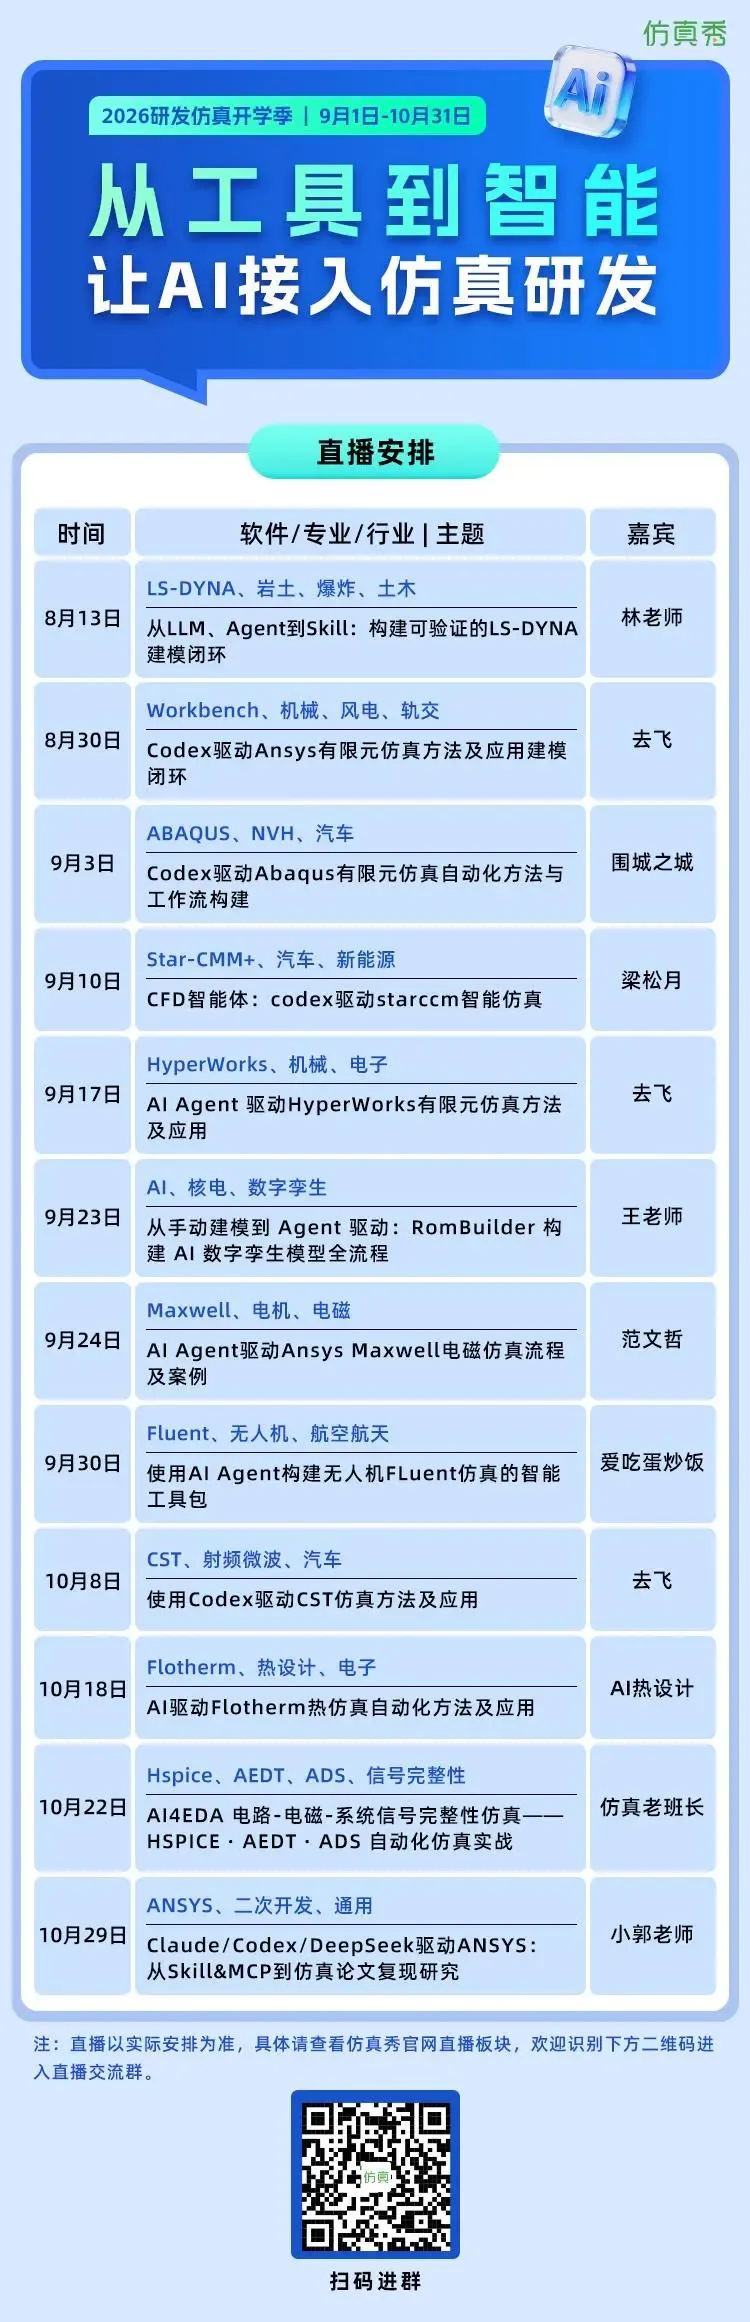
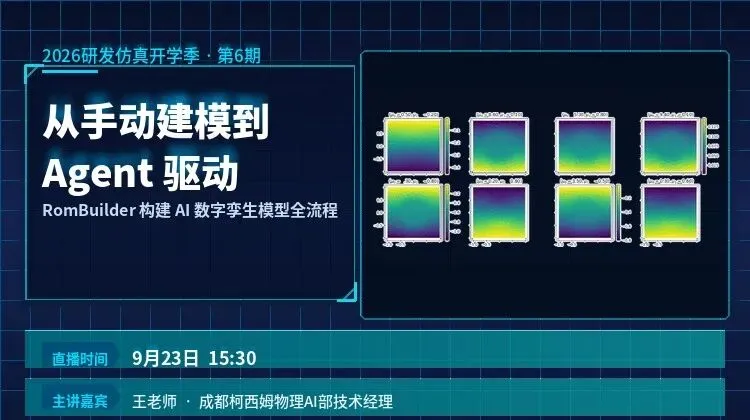
9月23日下午3点半,我在仿真秀主办的2026研发仿真开学季第六期直播间开讲,主题是"从手动建模到Agent驱动:RomBuilder构建AI数字孪生模型全流程"。直播里我会做两件事:第一件,手动走一遍完整流程。 从数据导入开始,一步步搭POD降阶、训练模型、做验证,让大家看清楚每一步在干什么、为什么这么干。这部分对应我之前写的那篇《工程仿真快速预测技术经验总结》里的方法论——纸上得来终觉浅,实际操作一遍你就知道那些经验是怎么来的。第二件,用AI Agent自动跑一遍同样的流程。 同样的案例、同样的数据,看看Agent怎么理解需求、怎么规划流程、怎么调用组件、最后出的结果跟手动做的有什么差异。两个案例都会讲:一个是GPX代理模型(动压轴封那个,标量预测的典型),一个是泵壳HPC ROM(场预测的典型)。一标量一场,基本能覆盖大部分工程快速预测的场景。如果你也在做仿真、也关心AI到底怎么落地、也想看看降阶建模的完整流程是怎么跑通的,欢迎来聊聊。请识别下方二维码报名观看和回放。到时候有问题尽管问,我尽量现场答。2026研发仿真开学季是仿真秀面向研发工程师推出的主题活动月,9月1日至10月31日以"从工具到智能——让AI接入仿真研发"为主线,覆盖结构、流体、电磁、多物理场和AI驱动仿真五个方向。仿真秀力邀企业资深研发工程师,围绕LS-DYNA、Workbench、Abaqus、Star-CCM+、HyperWorks、Maxwell、Fluent、CST、Flotherm、SolidWorks、ANSYS等主流软件,演示如何用LLM、Agent、Codex、Claude、DeepSeek等大模型能力打通建模、求解、后处理与优化全流程,让仿真从"手工操作"升级为"AI驱动";
此外仿真秀精选100余门研发仿真精品视频课限时秒杀1元起售,并叠加专属券,秒杀课程覆盖从基础到前沿的完整学习路径;活动期间,仿真秀还发起案例征集,以"我的研发仿真故事——从工具到智能的进阶之路"为题,面向工程师征集攻坚实录、工具进化、AI接入、成长与团队四类真实故事,图文或视频,通过即获“满意现金稿酬和百人千万"内容扶持计划,优秀作品还将在仿真秀APP、官网、公众号、视频号四端专题展示并邀请连麦直播。整个主题月既是一场系统化的技术充电,也是工程师用AI重塑研发工作流的一次集中练兵。
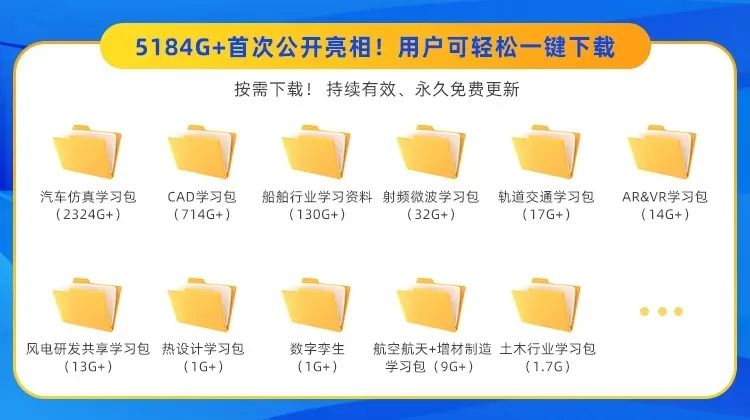
仿真秀 ,致力于为每一位学习者提供优质的仿真资源与技术服务支持,让您的仿真学习之旅更加顺畅,欢迎在公众号对话框与我互动交流!以下资料供用户永久免费下载哦(见下图)。下载地址在仿真秀APP公众号菜单-资料库-资料下载-进入百度云盘群下载,不会失效,且永久免费更新(注意在云盘群搜索文章标题,找到对应的资料或者模型自行下载即可,群满员请联系官方客服更新即可)。声明:本文首发仿真秀App,部分图片和内容转自网络,如有不当请联系我们,欢迎分享,禁止私自转载,转载请联系我们。欢迎投稿,投稿与技术交流请联系杨老师18610516616(微同)