ARTICLE · 1050471
VeRL 源码梳理笔记
一、代码总览
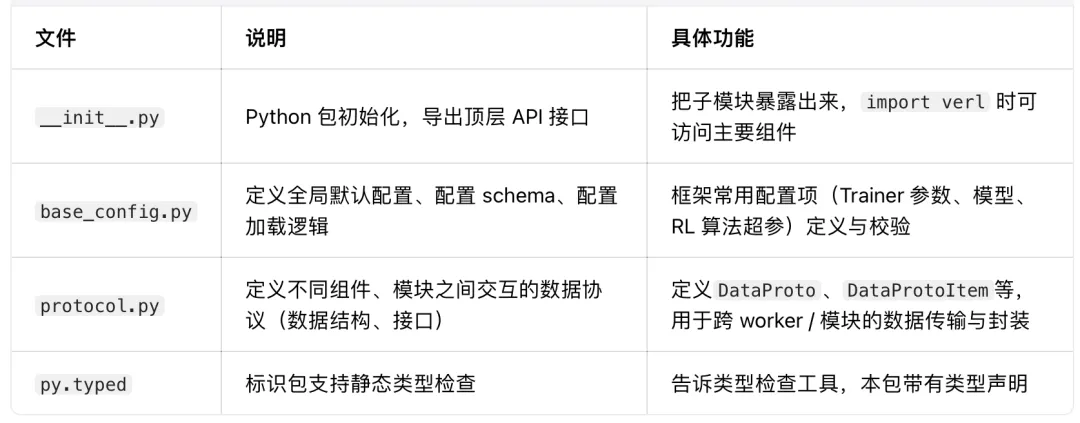
顶层文件
子目录
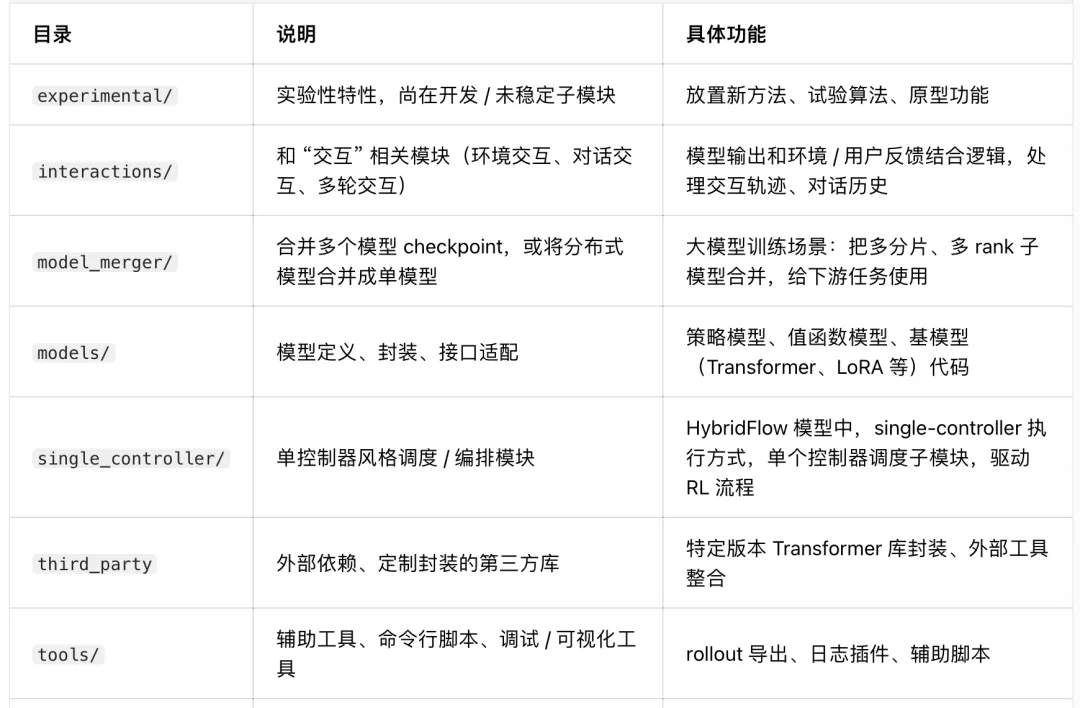
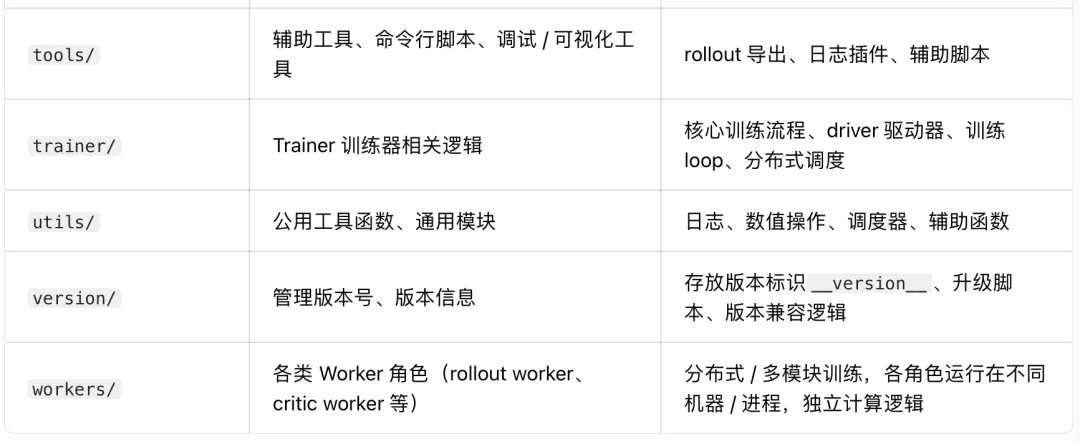
二、数据协议:protocol.py
verl/protocol.py 定义组件间数据交换标准协议,核心类:DataProto、DataProtoFuture。
1. DataProto
DataProto是标准化数据结构,用于函数间数据交换。内部包含:
batch: TensorDict:张量字典,像单张量一样操作一批张量,同 batch 尺寸的张量放在此处
non_tensor_batch: dict:非张量数据字典
meta_info: dict:元信息字典
DataProto 以 batch 维度组织数据。
2. DataProtoFuture
Future 版本的 DataProto,目的:driver 端不提前拉取真实数据,实现异步执行。 成员:
futures: list[ray.ObjectRef]:来自其他 WorkerGroup 的 Ray 异步对象列表
collect_fn: Callable:收集函数,把 futures 列表合并成一个 DataProto
dispatch_fn: Callable:分发函数,把 DataProto 切分成 world_size 份,分发到各个 worker
限制:只能把一个方法输出直接传给另一个方法输入,不能在 driver 上对 DataProtoFuture 做计算,数据在目标节点按需拉取。
三、Worker 模块
1. Worker 类
代码路径:verl/single_controller/base/worker.py VeRL 使用 WorkerGroup 统一实例化、调度 Worker。
Worker 存储分布式信息:world_size、rank,配置分布式环境。
Master Worker 额外保存MASTER_ADDR、MASTER_PORT。
继承关系:Worker继承WorkerHelper;WorkerHelper仅提供获取节点 IP 与端口的能力。
核心方法
__new__:rank0 节点配置MASTER_ADDR、MASTER_PORT
__init__:保存world_size、rank到实例
Ray Worker 极简示例
简单网络class MyNet(nn.Module):
def __init__(self):
super().__init__()
self.linear = nn.Linear(100, 1)
def compute_loss(self, x, y):
pred = self.linear(x)
return F.mse_loss(pred, y)
# 定义Worker,运行在GPU上@ray.remote(num_gpus=1)
class MyNetWorker(Worker):
def __init__(self):
super().__init__()
self.network = MyNet().cuda()
def compute_network_loss(self, inputs, targets):
inputs, targets = inputs.cuda(), targets.cuda()
return self.network.compute_loss(inputs, targets).item()
if __name__ == "__main__":
ray.init()
# 创建两个Worker
worker0 = MyNetWorker.remote()
worker1 = MyNetWorker.remote()
# 生成测试数据切分
inputs = torch.randn(16, 100)
targets = torch.randn(16, 1)
inputs_split = torch.chunk(inputs, 2)
targets_split = torch.chunk(targets, 2)
# 并行计算
future0 = worker0.compute_network_loss.remote(inputs_split[0], targets_split[0])
future1 = worker1.compute_network_loss.remote(inputs_split[1], targets_split[1])
# 收集结果
loss0, loss1 = ray.get([future0, future1])
avg_loss = (loss0 + loss1) / 2
ray.shutdown()
2. RayClassWithInitArgs
代码路径:verl/single_controller/ray/base.py
封装通过@ray.remote定义的 Actor 类,保存 Actor 类实例 + 异步调用 Actor 需要的初始化参数;调用__call__时启动 Actor。
3. RayResourcePool
Ray 中Placement Group:跨节点原子预留一组资源;bundle是资源预留最小单元。 RayResourcePool继承ResourcePool:
ResourcePool:存储资源信息
RayResourcePool:依靠 Ray Placement Group 实现资源池分配
Placement Group 示例
import ray
from ray.util.placement_group import placement_group, get_placement_group
# 创建包含8GPU、16CPU的Ray集群
ray.init(num_cpus=16, num_gpus=8)
# 创建placement group,3个bundle,每个bundle需要1GPU+4CPU
pg = placement_group(bundles=[
{"CPU": 4, "GPU": 1},
{"CPU": 4, "GPU": 1},
{"CPU": 4, "GPU": 1},
], strategy="STRICT_SPREAD") # 保证bundle分布在不同节点
# 等待placement group创建完成
try:
pg.wait(timeout_seconds=10)
print("Placement group created successfully!")except Exception as e:
print(f"Failed to create placement group: {e}")
# 根据名称获取已存在的placement groupexisting_pg = get_placement_group("my_placement_group_name")
# 清理资源ray.destroy_placement_group(pg)
RayResourcePool 使用示例
resource_pool = RayResourcePool(process_on_nodes=[4,4],
max_colocate_count=2, use_gpu=True) # 创建资源池
pgs = resource_pool.get_placement_groups() # 获取placement group列表
process_on_nodes:指定创建几个 Placement Group,每个包含多少 GPU
max_colocate_count:bundle 中单个 GPU 对应 CPU 数量,colocate actor 至少 1CPU
4. RayWorkerGroup
作用:资源分配、调度 Worker。 核心方法:_init_with_resource_pool、_bind_worker_method、execute_all_async 初始化两件核心工作:
在指定资源池上启动 worker
将 worker 的方法绑定到 worker group,支持直接通过 worker group 调用
self._workers保存全部 worker;execute_all_async可批量调用所有 worker 同一个方法
# 4个worker,每个worker执行add方法,参数x=10workergroup.execute_all_async("add", x=10)
推荐使用@register装饰器 + _bind_worker_method完成绑定
user_defined_cls:用户自定义 worker 类
func_generator:构造包装函数,执行顺序:dispatch_fn分发参数 → 执行 worker 的 method → collect_fn聚合输出结果
colocate 机制
colocate:多个 Worker 共享同一个资源池;VeRL 默认所有模型 worker 共用global_pool资源池。
create_colocated_worker_cls
代码路径:verl/single_controller/ray/base.py
该接口已废弃,推荐 FusedWorker
内部定义WorkerDict:
__init__构建self.worker_dict;key 为 actor/critic,value 是 Actor、Critic 实例
_bind_workers_method_to_parent:把@register标记的方法绑定到 WorkerDict;key 作为方法前缀
_bind_workers_method_to_parent
遍历用户自定义类中所有@register装饰的公开方法,生成包装函数挂载到 WorkerDict。
setattr(func, MAGIC_ATTR, getattr(method, MAGIC_ATTR))
复制装饰器元信息(add/sub 这类注册标记)到新生成的包装函数上。
spawn
代码路径:verl/single_controller/ray/base.py
def spawn(self, prefix_set):
"""Spawn to a dictionary of worker groups, each with a subset of method prefix."""
self.from_detached:基于已有 worker 构造新 RayWorkerGroup,不新建 worker 进程
_rebind_actor_methods:把带前缀方法(如actor_add)重命名为add,绑定到新 worker group
spawn 目标:保证 colocate 场景下,可像非 colocate 方式执行功能
colocate 效果:Actor、Critic 绑定在同一个 WorkerDict,在同一个 Ray 节点运行,可分别调用各自方法。
四、Colocated Workers 同节点 Worker 绑定示例代码
核心作用:把 Actor Worker、Critic Worker 绑定到同一个 WorkerDict,放置在同一节点资源池(多 GPU),用于大模型 RL 训练多 Worker 协同。
定义一个 Actor Worker,执行加法操作
@ray.remoteclass Actor(Worker):
def __init__(self):
super().__init__()
@register(dispatch_mode=Dispatch.DP_COMPUTE_PROTO)
def add(self, data: DataProto):
# 把 tensor 放到 cuda 上,并加上当前 worker 的 rank
data.batch['a'] = data.batch['a'].to("cuda")
data.batch['a'] += self.rank
return data
# 定义一个 Critic Worker,执行减法操作
@ray.remoteclass Critic(Worker):
def __init__(self, config):
super().__init__()
self.config = config
@register(dispatch_mode=Dispatch.DP_COMPUTE_PROTO)
def sub(self, data: DataProto):
# 把 tensor 放到 cuda 上,并减去配置中的参数 data.batch['a'] = data.batch['a'].to("cuda")
data.batch['a'] -= self.config['b']
return data
def test_colocated_workers():
ray.init()
# 构造输入数据:维度为10的全零向量
data = DataProto.from_dict({'a': torch.zeros(10)})
print("Input:", data.batch["a"])
# 封装 Actor 和 Critic 类及其初始化参数
actor_cls = RayClassWithInitArgs(cls=Actor)
critic_cls = RayClassWithInitArgs(cls=Critic, config={'b': 10})
# 构建仅含一个节点(2GPU)的资源池
resource_pool = RayResourcePool(process_on_nodes=[2])
# 利用 create_colocated_worker_cls 把 Actor 和 Critic 绑定到同一个 WorkerDict 上
cls_dict = {'actor': actor_cls, 'critic': critic_cls}
ray_cls_with_init = create_colocated_worker_cls(cls_dict)
# 打印元信息,确认 worker 确实绑定到 WorkerDict
print(type(ray_cls_with_init)) # RayClassWithInitArgs
print(ray_cls_with_init.cls.__ray_actor_class__) # WorkerDict print(ray_cls_with_init.cls.__ray_actor_class__.__base__) # Worker print(ray_cls_with_init.cls.actor_add) # Actor 的 add 方法 print(ray_cls_with_init.cls.critic_sub) # Critic 的 sub 方法
# 启动 WorkerDict,并获取 actor 和 critic 对应的 worker group
wg_dict = RayWorkerGroup(resource_pool=resource_pool, ray_cls_with_init=ray_cls_with_init)
spawn_wg = wg_dict.spawn(prefix_set=cls_dict.keys())
actor_wg, critic_wg = spawn_wg['actor'], spawn_wg['critic']
# 执行 Actor 的 add 和 Critic 的 sub 操作
actor_output = actor_wg.add(data)
critic_output = critic_wg.sub(data)
# 预期结果: actor_output: 前5个为0, 后5个为1, critic_output: 全为-10
print("Actor output:", actor_output.batch["a"])
print("Critic output:", critic_output.batch["a"]) ray.shutdown()
if __name__ == '__main__':
test_colocated_workers()
要点:
create_colocated_worker_cls:将多个 Worker 封装到同一个 WorkerDict,共用 Ray 资源池,同节点多 GPU 部署。
RayWorkerGroup:管理一组 worker,批量调用注册的方法(add/sub),底层自动分发 DataProto 数据。
DataProto:Verl 自定义数据容器,存放 batch 张量,在 worker 之间传递数据。
五、Rollout 推理生成模块
VeRL 使用 vLLM、SGLang 等推理引擎优化 Rollout(Actor 模型生成样本)。
1. vLLM 版 Rollout
代码路径:
verl/verl/workers/rollout/vllm_rollout/vllm_rollout_spmd.py 类:vLLMRollout(BaseRollout),核心 2 个方法:
__init__:基于actor_module实例化 vLLM 的inference_engine
generate_sequences:参数预处理、结果后处理;生成前后处理 kv cache,解决 vLLM 预分配显存问题
2. 模型分片 ShardingManager
代码路径:
verl/verl/workers/sharding_manager/fsdp_vllm.py,类FSDPVLLMShardingManager(BaseShardingManager) 核心方法:
__enter__:推理前,完成模型权重重新分片
__exit__:推理结束,将 vLLM 模型权重移出 GPU,释放显存
preprocess_data:TP 分组内执行 all-gather,保证同一个 TP 组使用相同输入
postprocess_data:将推理输出结果重新 chunk 分片
关键背景:Rollout 阶段会对模型重新分片,因此 TP 组数据必须对齐。
3. 完整 Rollout 流程
代码位置:ActorRolloutRefWorker 的 generate_sequences 方法
文件:verl/verl/workers/fsdp_workers.py
@register(dispatch_mode=DispatchMode.ND_COMPUTE_DATAPROTO_DISPATCH_FN(mesh_name="rollout"))
@DistProfiler.annotate(color="red", role="rollout_generate")
def generate_sequences(self, prompts: DataProto):
# Support all hardwares
assert self._is_rollout
prompts = prompts.to(get_device_id())
Rollout 完整链路:接收 prompt → ShardingManager 加载分片权重 → vLLM 推理生成 → 结果分片还原 → 返回生成 response。
六、强化学习算法实现
文件统一路径:verl/verl/trainer/ppo/core_algos.py
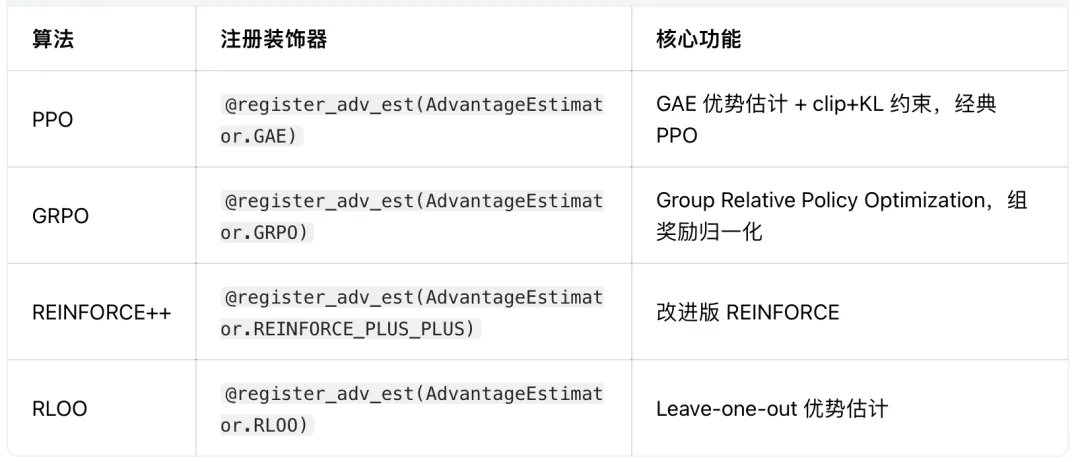
所有算法均通过@register_adv_est注册优势函数,方便框架动态调度。
1. PPO
Policy 损失函数:compute_policy_loss 参数:old_log_prob, log_prob, advantages, response_mask, cliprange...
GAE 优势估计:compute_gae_advantage 参数:token_level_rewards, values, response_mask, gamma, lam
KL 惩罚项 kl_penalty LLM RL 中,单纯最大化奖励容易输出不合自然语言的文本,增加 KL 约束,限制新模型与 ref 模型分布偏移。 提供 k1/k2/k3 多种无偏 KL 估计器,实现直通梯度 trick。
Critic 价值损失 compute_value_loss Critic 模型用来预测状态价值函数;有标签时用 MSE 回归损失。 参数:vpreds, returns, values, response_mask, cliprange_value
2. GRPO
compute_grpo_outcome_advantage
NOTE:仅考虑 outcome supervision,reward 为标量。 输入:token 级别奖励、response mask,输出归一化后的优势。
3. REINFORCE++
compute_reinforce_plus_plus_outcome_advantage
4. RLOO
compute_rloo_outcome_advantage
offer捷报
恭喜保拿offer辅导的同学
985硕 非科班 26届秋招最佳!BAT大满贯最高总包80w
1)淘天大模型ofer70w总包
2)腾讯搜广推ofer70w总包
3)百度搜广推offer60w总包
4)字节大模型offer60w总包
5)得物大模型offer80w总包
恭喜项目辅导的同学(最高总包出现!26届海外硕非科班。从去年四月开始准备,先后参加了三个项目辅导,时间覆盖暑期实习/秋招/春招。春招收获腾讯推荐算法offer,总包85w
联系我们
面向算法岗实习/校招/社招 提供面试/项目/全流程保拿辅导,欢迎添加微信咨询。
微信号|Mr_Lin-07-21
备 注|公众号