ARTICLE · 1050480
poll 源码分析(五):从内核返回用户态-上
为了有更直观的感受,el0_svc 分支代码摘抄如下(省略无关行):
.align 6el0_svc:...ldr x16, [stbl, scno, lsl #3] // address in the syscall tableblr x16 // call sys_* routineb ret_fast_syscall
这一篇就从 ret_fast_syscall 出发,看看内核是怎么一步步回到用户态的。文章比较长,决定分上下两篇。
本文基于 Linux 4.4.126 版本的源码,只分析 ARM64 平台上的流程。
1. 总览
老规矩,先把本文要分析的代码调用链列出来:
b ret_fast_syscalldisable_irqldr x1, [tsk, #TI_FLAGS]cbnz x2, work_pending// 标志位干净:快路径kernel_exit 0eret// 标志位不干净:慢路径work_pendingldr x2, [sp, #S_PSTATE]enable_irqbl do_notify_resumedo_signal()get_signal()handle_signal()restore_saved_sigmask()b ret_to_userdisable_irqcbnz x2, work_pendingkernel_exit 0eret
返回流程分为快慢两条路径。
ret_fast_syscall 先检查当前线程的标志位,全部干净就直接 kernel_exit 返回用户态,这是快路径。有任何一个标志位置位,就去 work_pending 做额外的工作,做完再回到 ret_to_user 重新检查,这是慢路径。
不管是哪条路径,返回用户态的最后一条指令都是 eret。eret 是 Exception Return 的缩写,这条指令没有操作数,它在硬件层面恢复 PC 和 PSTATE 等寄存器,完成现场恢复的最后那小部分。
先把汇编代码完整贴出来混个脸熟,它们全部在 arch/arm64/kernel/entry.S:
/** This is the fast syscall return path. We do as little as possible here,* and this includes saving x0 back into the kernel stack.*/ret_fast_syscall:disable_irq // disable interruptsstr x0, [sp, #S_X0] // returned x0ldr x1, [tsk, #TI_FLAGS] // re-check for syscall tracingand x2, x1, #_TIF_SYSCALL_WORKcbnz x2, ret_fast_syscall_traceand x2, x1, #_TIF_WORK_MASKcbnz x2, work_pendingenable_step_tsk x1, x2kernel_exit 0ret_fast_syscall_trace:enable_irq // enable interruptsb __sys_trace_return_skipped // we already saved x0/** Ok, we need to do extra processing, enter the slow path.*/work_pending:tbnz x1, #TIF_NEED_RESCHED, work_resched/* TIF_SIGPENDING, TIF_NOTIFY_RESUME or TIF_FOREIGN_FPSTATE case */ldr x2, [sp, #S_PSTATE]mov x0, sp // 'regs'tst x2, #PSR_MODE_MASK // user mode regs?b.ne no_work_pending // returning to kernelenable_irq // enable interrupts for do_notify_resume()bl do_notify_resumeb ret_to_userwork_resched:bl schedule/** "slow" syscall return path.*/ret_to_user:disable_irq // disable interruptsldr x1, [tsk, #TI_FLAGS]and x2, x1, #_TIF_WORK_MASKcbnz x2, work_pendingenable_step_tsk x1, x2no_work_pending:kernel_exit 0ENDPROC(ret_to_user)
这是返回路径上最重要的三个标签,四十来行。为了阅读和逻辑上的清晰性,还有部分标签和宏没有贴出来,等后面分析到它们的时候再贴出来逐行分析。
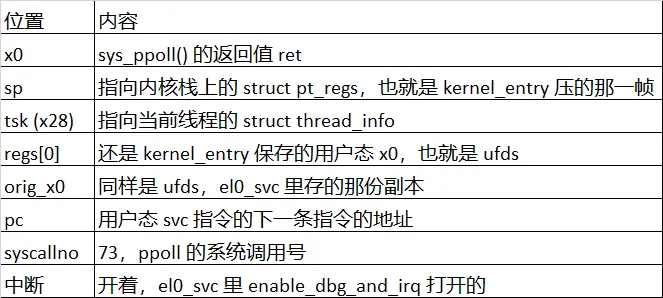
在开始分析之前,先明确一下执行到 ret_fast_syscall 这一刻时,一些重点寄存器和字段的状态。这些在前两篇文章里基本都分析过:
2. 总入口:ret_fast_syscall
ret_fast_syscall:disable_irq // disable interruptsstr x0, [sp, #S_X0] // returned x0ldr x1, [tsk, #TI_FLAGS] // re-check for syscall tracingand x2, x1, #_TIF_SYSCALL_WORKcbnz x2, ret_fast_syscall_traceand x2, x1, #_TIF_WORK_MASKcbnz x2, work_pendingenable_step_tsk x1, x2kernel_exit 0
一共九行,一行一行来。
第 1 行:关中断。
disable_irq // disable interrupts这是个宏,定义在 arch/arm64/include/asm/assembler.h:
/** Enable and disable interrupts.*/.macro disable_irqmsr daifset, #2.endm.macro enable_irqmsr daifclr, #2.endm
源码分析(三)里分析 enable_dbg_and_irq 时讲过 DAIF 四个屏蔽位,#2 对应 I 位,也就是普通中断。daifset 是置位,也就是屏蔽,所以 msr daifset, #2 就是关中断。
为什么这里要关中断?
因为从这条指令开始,到 kernel_exit 最后一条 eret 为止,这期间不能被中断打断。这段路要做的事情是:读线程标志位,根据标志位决定要不要做额外的工作,然后恢复用户态现场并 eret。
原因有两层。
第一层:kernel_exit 不允许被打断
kernel_exit 要把用户态的返回地址写进 ELR_EL1 这个特殊寄存器,然后 eret 才能据此回到用户态。而 CPU 每次进异常,硬件都会用新的返回地址覆盖 ELR_EL1。
如果写完返回地址之后、eret 之前又来了一个中断,中断返回时 ELR_EL1 里留下的是被中断打断的那条内核指令的地址,用户态的返回地址已经丢了!eret 无法返回用户态了!
所以 kernel_exit 期间必须关中断。
这里看的比较懵没关系,有个大概的因果逻辑就行。要把这个问题彻底解释清楚,涉及到很多 kernel_exit 的实现细节,这里展开不太合适。
等后面分析完了 kernel_exit,我们再来剖析这个问题,到时会有更深的理解。
第二层:为什么要提前到读标志位之前关
既然只是 kernel_exit 不能被打断,那在 kernel_exit 前一条指令关中断不就够了?为什么还要提前到第 3 行 ldr 读标志位之前?
因为标志位的检查结果必须一直有效到 eret 那一刻。
以 TIF_FOREIGN_FPSTATE 为例。这个标志表示浮点寄存器里装的不是当前线程的数据,置位了就得先把它们恢复回来才能回用户态。
假设读标志位时它是 0,于是决定走快路径直接返回用户态。如果此时中断还开着,读完标志位到 eret 之间来一个中断,而内核又默认开了抢占,中断返回时就可能切到别的线程跑一会儿,再切回来。
这一切一回,浮点寄存器很有可能已经被别的线程用过了。因此,内核切回来时会给当前线程置上 TIF_FOREIGN_FPSTATE,但检查点已经过了,后面没有人再看它,最终就带着一堆错误的浮点寄存器回到了用户态。
提前关了中断,从读标志位到 eret 之间不可能发生任何中断,也就不会发生上面的问题了。
等等。那什么时候再开中断呢?kernel_exit 里并没有 enable_irq 这样的代码。
很棒,这才是分析内核代码的正确思路。所谓开中断,无非就是再将 I 位清零。后面分析 kernel_exit 时详聊。
第 2 行:保存返回值。
str x0, [sp, #S_X0] // returned x0str,sp,#S_X0,前面文章都分析过,不赘述了。这条指令是把 x0 写进 pt_regs 的 regs[0] 字段。
这一步很关键,涉及到系统调用返回值如何传递给用户态。之前我们提到过函数调用约定,x0 用来保存函数返回值。后面 kernel_exit 恢复现场时,是从栈上的 pt_regs 里把 reg[0] - reg[30] 整个读回到对应的通用寄存器中,当然也包括 x0。
注意,这条指令之前,reg[0] 里保存的是 kernel_entry 时期的 x0 的值。当时刚进内核态,x0 保存的是 poll() 的第一个参数,ufds 指针。
所以,如果这里不先把返回值写进 regs[0],kernel_exit 就会把用户态原始的 x0 恢复回去,这样用户程序拿到的 poll() 返回值将是它自己传进去的 ufds 指针。
这里有点绕,是因为 x0 在调用 poll() 时用来存储第一个参数,而在 poll() 返回后用来存储其返回值。
如果返回流程走的是快路径,kernel_exit 将很快被执行,所以这里是把系统调用返回值递送给用户态的最后机会。
现在,再来看源码分析(三)里留下的一个问题:为什么 el0_svc 要专门在 orig_x0 里再备份 x0 的值?
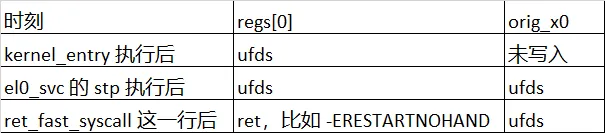
regs[0] 被返回值覆盖之后,第一个参数的原始值就只剩 orig_x0 这一份了。后面 do_signal() 可能会重启系统调用,再次调用 ppoll 就意味着必须得准备好其所需的五个参数,而第一个参数 ufds 就是从 orig_x0 这里取出。
至于 x1 到 x7 这几个参数寄存器,它们在 pt_regs 里的位置从没被改写过,所以不需要备份。
第 3 行:读出当前线程的 thread_info 里的 flags 成员,里面保存了当前线程的线程标志位。
ldr x1, [tsk, #TI_FLAGS] // re-check for syscall tracing这条指令前面文章里已经详细分析过,这里不赘述了。
考虑到后面两条 and 指令里涉及 _TIF_SYSCALL_WORK 和 _TIF_WORK_MASK 这两个和线程标志位有关的宏常量,这里稍微展开聊聊线程标志位。
ARM64 平台上,所有的线程标志位都定义在 arch/arm64/include/asm/thread_info.h:
/** thread information flags:* TIF_SYSCALL_TRACE - syscall trace active* TIF_SYSCALL_TRACEPOINT - syscall tracepoint for ftrace* TIF_SYSCALL_AUDIT - syscall auditing* TIF_SECOMP - syscall secure computing* TIF_SIGPENDING - signal pending* TIF_NEED_RESCHED - rescheduling necessary* TIF_NOTIFY_RESUME - callback before returning to user* TIF_USEDFPU - FPU was used by this task this quantum (SMP)*/#define TIF_SIGPENDING 0#define TIF_NEED_RESCHED 1#define TIF_NOTIFY_RESUME 2 /* callback before returning to user */#define TIF_FOREIGN_FPSTATE 3 /* CPU's FP state is not current's */#define TIF_NOHZ 7#define TIF_SYSCALL_TRACE 8#define TIF_SYSCALL_AUDIT 9#define TIF_SYSCALL_TRACEPOINT 10#define TIF_SECCOMP 11#define TIF_MEMDIE 18 /* is terminating due to OOM killer */#define TIF_FREEZE 19#define TIF_RESTORE_SIGMASK 20#define TIF_SINGLESTEP 21#define TIF_32BIT 22 /* 32bit process */#define _TIF_SIGPENDING (1 << TIF_SIGPENDING)#define _TIF_NEED_RESCHED (1 << TIF_NEED_RESCHED)#define _TIF_NOTIFY_RESUME (1 << TIF_NOTIFY_RESUME)#define _TIF_FOREIGN_FPSTATE (1 << TIF_FOREIGN_FPSTATE)#define _TIF_NOHZ (1 << TIF_NOHZ)#define _TIF_SYSCALL_TRACE (1 << TIF_SYSCALL_TRACE)#define _TIF_SYSCALL_AUDIT (1 << TIF_SYSCALL_AUDIT)#define _TIF_SYSCALL_TRACEPOINT (1 << TIF_SYSCALL_TRACEPOINT)#define _TIF_SECCOMP (1 << TIF_SECCOMP)#define _TIF_32BIT (1 << TIF_32BIT)#define _TIF_WORK_MASK (_TIF_NEED_RESCHED | _TIF_SIGPENDING | \_TIF_NOTIFY_RESUME | _TIF_FOREIGN_FPSTATE)#define _TIF_SYSCALL_WORK (_TIF_SYSCALL_TRACE | _TIF_SYSCALL_AUDIT | \_TIF_SYSCALL_TRACEPOINT | _TIF_SECCOMP | \_TIF_NOHZ)
_TIF_SYSCALL_WORK 和 _TIF_WORK_MASK 也定义在这里,对于整个标志位全集而言,它俩是两个子集,而且不相交。
为了更好地理解后面的代码,简单介绍下 _TIF_SYSCALL_WORK 和 _TIF_WORK_MASK 包含的这 9 个标志位。
第一组:_TIF_SYSCALL_WORK:有没有人在旁观这次系统调用
这五个标志都是系统调用钩子,只要有一个置位,系统调用入口就走 __sys_trace,在真正调用之前和之后各插一个钩子函数。
它们和系统调用本身的语义无关,是跟踪、审计、过滤这类旁观者的需求。poll 源码分析(三)里也简单介绍过这几个标志位。了解到这个程度即可。
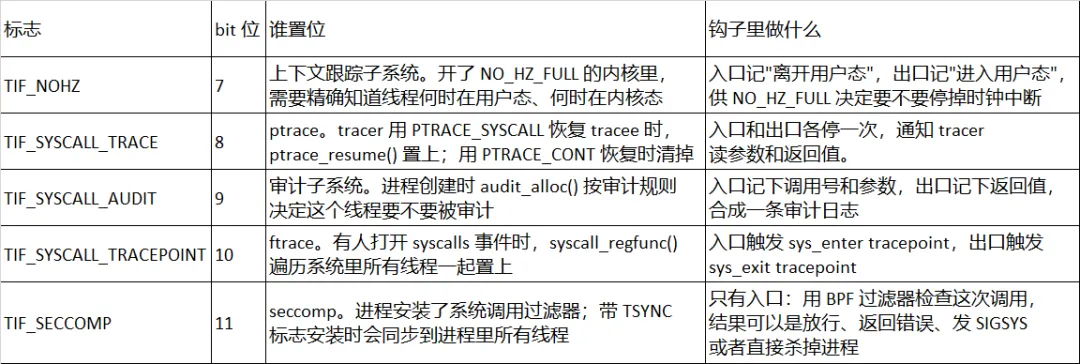
上表是请 AI 帮忙总结的,我了解不多,就不班门弄斧了。
第二组:_TIF_WORK_MASK:回用户态之前自己还有没有活没干完
这四个标志不属于任何一个系统调用,而是内核借即将回到用户态这个时机顺便处理的四类事务。不管从哪个系统调用、哪种异常返回用户态,都要做这个检查。
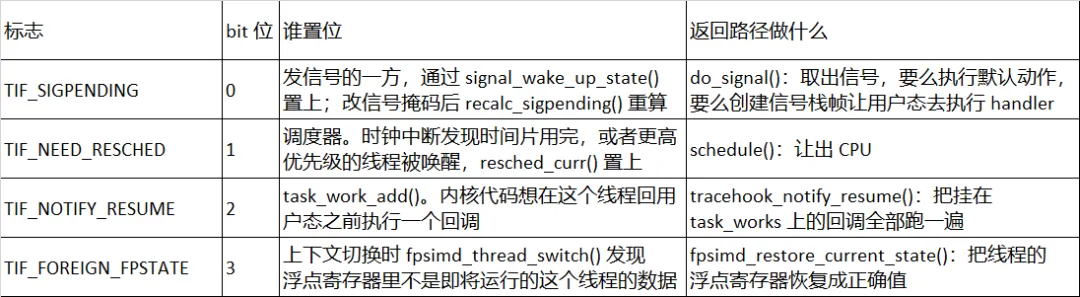
这四位决定了返回流程是走快路径还是慢路径。全为 0 则直接 kernel_exit;有一位不为 0 就进 work_pending,处理完回 ret_to_user 重查,直到全为 0。
两组之间的差别
触发时机不同。第一组在系统调用的入口和出口两头都要处理,第二组只在返回用户态时处理。 覆盖范围不同。第一组只对系统调用有意义,缺页、中断这些异常返回时不检查它;第二组对所有回用户态的路径都检查,el0_da、el0_irq 的返回路径同样要走 ret_to_user。 检查方式不同。第一组用 and 加 cbnz 在 ret_fast_syscall 只查一次;第二组在慢路径里是循环检查的。
第 4 - 5 行:检查 _TIF_SYSCALL_WORK 标志位子集,并决定是否跳转。
and x2, x1, #_TIF_SYSCALL_WORKcbnz x2, ret_fast_syscall_trace
x1 是当前线程的 thread_info 里的 flags 成员,将它与 _TIF_SYSCALL_WORK 相与,结果放进 x2。
第二条 cbnz 是 Compare and Branch on Non-Zero,语法 cbnz Xn, label:Xn 非零就跳转到 label。和它成对的 cbz 是为零就跳转。
和前面的 tst + b.ne 相比,cbnz 一条指令就完成了比较和跳转,但是它不修改 NZCV 条件标志位。
ret_fast_syscall_trace 标签紧挨着 ret_fast_syscall:
ret_fast_syscall_trace:enable_irq // enable interruptsb __sys_trace_return_skipped // we already saved x0
这条分支不是主线,而且需要大量相关的背景知识才能完全理解,就此打住了。
我们的 poll 场景没有被跟踪,也没有打开这些机制,x2 为零,cbnz 不跳转,继续往下走。
第 6 - 7 行:
and x2, x1, #_TIF_WORK_MASKcbnz x2, work_pending
x1 里还是那份 flags,_TIF_WORK_MASK 子集前面刚介绍过。
分水岭
这条 cbnz 就是本文总览里说的那个分叉点:
x2 为零,四位全干净:不跳转,顺序执行下面的 enable_step_tsk 和 kernel_exit 0,直接回用户态。这是快路径,第 3 节分析。 x2 非零,至少一位置位:跳到 work_pending,把活干完再回用户态。这是慢路径,第 4 节分析。
两条路的终点都是 kernel_exit 0。
对于我们的 poll 场景,典型的场景有:
poll 进来时就有 fd 就绪,没睡就返回了:一般四位都是干净的,走快路径。 poll 睡了一觉,被 fd 就绪唤醒:如果睡眠期间这个 CPU 上跑过别的线程,TIF_FOREIGN_FPSTATE 大概率是置位的,走慢路径。 poll 被信号打断:TIF_SIGPENDING 一定置位,走慢路径。
先看快路径。
3. 快路径:kernel_exit
cbnz 没有跳转,ret_fast_syscall 就剩下两行:
enable_step_tsk x1, x2kernel_exit 0
第一行是使能单步调试,第二行是恢复现场并 eret。
事实上,慢路径最后也是走的 kernel_exit 0 返回用户态。
3.1 单步调试:enable_step_tsk
这个宏和 kernel_entry 里的 disable_step_tsk 是一对,都定义在 arch/arm64/include/asm/assembler.h:
.macro disable_step_tsk, flgs, tmptbz \flgs, #TIF_SINGLESTEP, 9990fmrs \tmp, mdscr_el1bic \tmp, \tmp, #1msr mdscr_el1, \tmpisb // Synchronise with enable_dbg9990:.endm.macro enable_step_tsk, flgs, tmptbz \flgs, #TIF_SINGLESTEP, 9990fdisable_dbgmrs \tmp, mdscr_el1orr \tmp, \tmp, #1msr mdscr_el1, \tmp9990:.endm
在分析代码前,得先聊聊什么是单步调试。
所谓单步调试,就是调试程序时,每执行一行代码后程序停下,允许程序员观察此刻的程序状态,比如内存状态和 CPU 执行状态,也就是那些寄存器。
这很好理解,程序都停下了,整个线程状态可以 360 度无死角被围观。
前面说的单步的颗粒度是源码行级别,一行可能对应多条机器码指令。当然,也有机器码指令级别的单步。
gdb 是典型的可以支持单步调试的工具。它的 step 和 next 命令就是源码行级别,而 stepi 命令则是机器码指令级别。
Linux 在 ARM64 上实现单步调试靠的是 CPU 的硬件单步机制。硬件提供的是指令级单步,源码级单步是 gdb 在它之上用调试信息拼出来的。本节只讨论指令级单步。
硬件单步机制主要涉及到三个 bit 位:
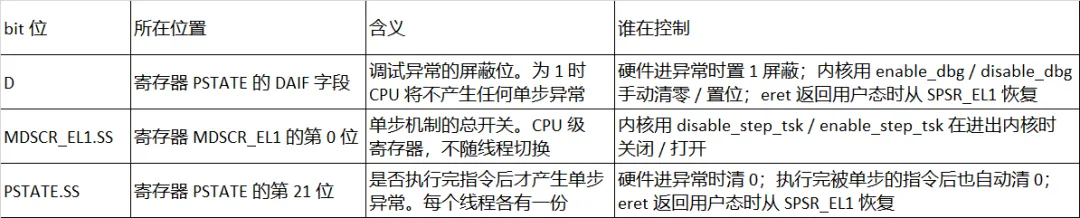
D 是调试异常类的屏蔽位。单步异常属于其中一类。
MDSCR_EL1.SS 控制着 CPU 是否产生单步异常。
PSTATE.SS 则控制着 CPU 是否执行完指令后再产生单步异常。MDSCR_EL1.SS 为 1 的前提下,如果 PSTATE.SS = 1,则执行完一条指令后才产生单步异常。如果 PSTATE.SS = 0,则不执行指令,立刻产生单步异常。
三个位组合起来可以理解为一个状态机:
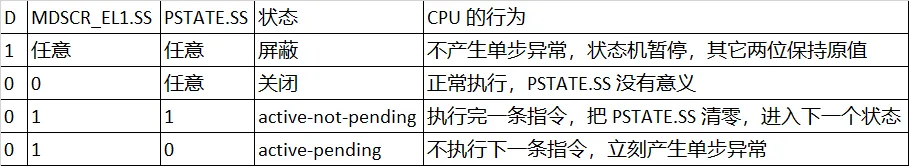
MDSCR_EL1 是 CPU 级的寄存器,不区分用户态和内核态。如果被调试线程带着这个开关进入内核态,那内核自己的指令也将会被单步。
进异常时硬件自动把 PSTATE.SS 清零,此时 MDSCR_EL1.SS 为 1、PSTATE.SS 为 0,状态机处于 active-pending。el0_svc 里 enable_dbg_and_irq 一放开 D 位,下一条指令就会立刻触发单步异常。
所以,进内核需要先把单步调试关掉,返回用户态前再把它打开,让单步只作用于用户态的代码。kernel_entry 里的 disable_step_tsk 就是先把开关(MDSCR_EL1.SS)关掉,出内核前再由 enable_step_tsk 打开。
有了这个背景知识,enable_step_tsk 的代码就很好理解了。
第一行 tbz 是 Test bit and Branch if Zero,语法 tbz Xn, #bit, label:Xn 的第 bit 位为 0 就跳转。tbnz 与之相反,为 1 才跳。
9990f 里的 f 表示 forward,向后(代码下方)找最近的 9990 标号。数字标号可以重复定义,配合 f 或 b 后缀指明方向,是汇编宏里的常用写法。
flgs 传的是 x1,也就是先前读出来的 flags。TIF_SINGLESTEP 是第 21 位,置位表示当前线程正在被单步调试。
TIF_SINGLESTEP 没置位就直接跳到 9990,直接结束。置位了就走第二行的 disable_dbg,关掉调试异常。
这里 disable_dbg 是置位 DAIF 里的 D 位,这样就不会产生单步异常了。
接下来的第 3 - 5 行:先把 mdscr_el1 寄存器读出来,然后把它和立即数 1 相或,也就是把 bit 0(MDSCR_EL1.SS)置位,然后再更新回去。这里用 orr(或指令)可以保证只修改寄存器里的 bit 0,不会改到其它控制位。
注意,这里的先后顺序很重要,必须要先置位 D 位,然后再置位 MDSCR_EL1.SS。否则 msr 指令一执行完,CPU 就会产生单步异常。在内核态我们并不需要单步调试。
单步调试不是本文重点,不再展开更多细节。
我们的 poll 场景没有单步调试,tbz 直接跳到 9990 什么都不做。
3.2 kernel_exit
kernel_exit 是 kernel_entry 的镜像,基本可以理解为 kernel_entry 的逆过程,也定义在 arch/arm64/kernel/entry.S。先把宏完整贴出来:
.macro kernel_exit, el.if \el != 0/* Restore the task's original addr_limit. */ldr x20, [sp, #S_ORIG_ADDR_LIMIT]str x20, [tsk, #TI_ADDR_LIMIT].endifldp x21, x22, [sp, #S_PC] // load ELR, SPSR.if \el == 0ct_user_enterldr x23, [sp, #S_SP] // load return stack pointermsr sp_el0, x23#ifdef CONFIG_ARM64_ERRATUM_845719alternative_if_not ARM64_WORKAROUND_845719nopnop#ifdef CONFIG_PID_IN_CONTEXTIDRnop#endifalternative_elsetbz x22, #4, 1f#ifdef CONFIG_PID_IN_CONTEXTIDRmrs x29, contextidr_el1msr contextidr_el1, x29#elsemsr contextidr_el1, xzr#endif1:alternative_endif#endif.endifmsr elr_el1, x21 // set up the return datamsr spsr_el1, x22ldp x0, x1, [sp, #16 * 0]ldp x2, x3, [sp, #16 * 1]ldp x4, x5, [sp, #16 * 2]ldp x6, x7, [sp, #16 * 3]ldp x8, x9, [sp, #16 * 4]ldp x10, x11, [sp, #16 * 5]ldp x12, x13, [sp, #16 * 6]ldp x14, x15, [sp, #16 * 7]ldp x16, x17, [sp, #16 * 8]ldp x18, x19, [sp, #16 * 9]ldp x20, x21, [sp, #16 * 10]ldp x22, x23, [sp, #16 * 11]ldp x24, x25, [sp, #16 * 12]ldp x26, x27, [sp, #16 * 13]ldp x28, x29, [sp, #16 * 14]ldr lr, [sp, #S_LR]add sp, sp, #S_FRAME_SIZE // restore speret // return to kernel.endm
参数 el 表示要返回到哪个异常等级。我们传的是 0,返回用户态。
宏里有两块可以先剔除掉。
开头第 2 行 .if \el != 0 那一段只在返回 EL1 时执行,用来恢复 kernel_entry 时改掉的 addr_limit,我们不走。
中间第 13 - 30 行 CONFIG_ARM64_ERRATUM_845719 那一段是 Cortex-A53 一个硬件勘误的规避代码,和主线无关。
剔掉之后,el = 0 时实际要执行的指令就是:
ldp x21, x22, [sp, #S_PC] // load ELR, SPSRct_user_enterldr x23, [sp, #S_SP] // load return stack pointermsr sp_el0, x23msr elr_el1, x21 // set up the return datamsr spsr_el1, x22ldp x0, x1, [sp, #16 * 0]ldp x2, x3, [sp, #16 * 1]...ldp x26, x27, [sp, #16 * 13]ldp x28, x29, [sp, #16 * 14]ldr lr, [sp, #S_LR]add sp, sp, #S_FRAME_SIZE // restore speret // return to kernel
这样看起来就清爽多了。后面的逐行分析就基于这个简化后的版本。
3.2.1 寄存器介绍
在开始分析之前,我还是想介绍下这里涉及到的各种寄存器(主要是通用寄存器和常见的特殊寄存器),否则理解起来总让人觉得有点飘,云里雾里的感觉。
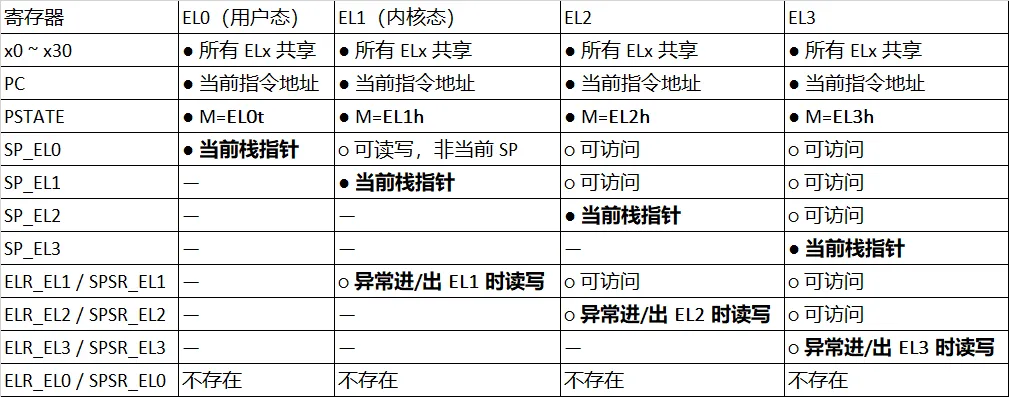
●= 此刻作为活跃寄存器在用;
○= 存在、可访问,但不是当前执行时的主角;
—= 当前 EL 不能访问该寄存器。
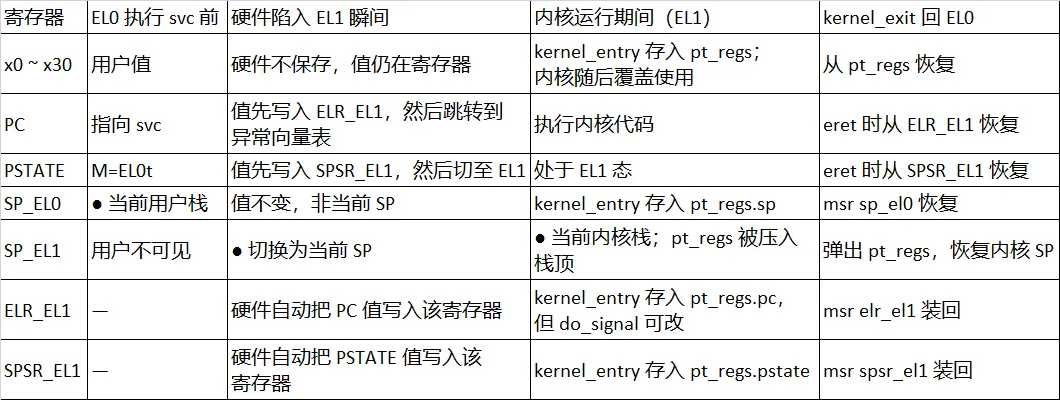
同步异常场景下,寄存器在各个时刻的情况如下:
重点介绍下 PC/ELR_EL1 和 PSTATE/SPSR_EL1 这两对寄存器。
PC 和 ELR_EL1
PC 是程序计数器,装着 CPU 当前正在执行的指令的地址,每执行完一条就前进到下一条。ARM64 上 PC 不是通用寄存器,软件不能用 mov 等指令直接读写它,只能通过跳转指令间接改变它。
ELR_EL1 是 Exception Link Register,异常链接寄存器。CPU 从用户态进入 EL1 处理异常时,硬件自动把返回地址写进 ELR_EL1;异常处理完执行 eret 时,CPU 从 ELR_EL1 取回这个地址装进 PC。
返回地址是哪一条指令,取决于异常的类型。svc 是主动陷入,返回地址是 svc 的下一条;中断和缺页是被打断,返回地址是被打断的那条指令自己,回去后要重新执行它。
PSTATE 和 SPSR_EL1
PSTATE 是处理器状态,装着 CPU 当前的一组控制位和标志位:当前异常等级和栈指针选择(M[3:0])、四个异常屏蔽位(DAIF)、条件标志位(NZCV)、单步位(SS)等。和 PC 一样,PSTATE 不是一个可以整体读写的寄存器,软件只能通过 msr daifset 这类特殊指令改它的某个字段。
SPSR_EL1 是 Saved Program Status Register,保存的程序状态寄存器。CPU 进入 EL1 处理异常时,硬件把进异常之前的 PSTATE 完整地拷贝进 SPSR_EL1,然后把 PSTATE 改成异常处理所需的状态:切到 EL1、DAIF 全部置 1、SS 清 0。eret 时再把 SPSR_EL1 整个装回 PSTATE,被打断的上下文就恢复到了进异常前的状态。
两对寄存器的关系
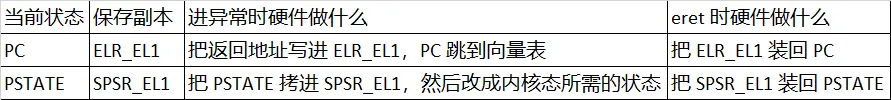
可以把 ELR_EL1 和 SPSR_EL1 理解成 PC 和 PSTATE 的影子。CPU 自己在用 PC 和 PSTATE 干活,影子里则存着异常返回之后它们该是什么值。
这里有一个关键的限制:影子只有一份。
每一次新的异常都会用新的值覆盖 ELR_EL1 和 SPSR_EL1。而系统调用执行期间,中断和缺页异常随时可能发生,每次发生都是一次新的异常。
所以 kernel_entry 进内核后第一件事就是用 mrs 把这两个影子读出来存进内核栈上的 pt_regs 的 pc 和 pstate 字段。此后不管来多少次异常,用户态的返回地址和处理器状态都安全地备份在内核栈上。
3.2.2 代码分析
现在开始分析代码。
这些汇编指令,pt_regs,以及 #S_xxx 这样的立即数在 poll 源码分析(三)里都详细介绍过,这里不再解释它们,重点聚焦在代码逻辑。
第 1 行:取回返回地址和处理器状态。
ldp x21, x22, [sp, #S_PC] // load ELR, SPSRpt_regs 偏移表里,pc 在 256,pstate 在 264,两个字段紧挨着。所以可以用一条 ldp 指令一次性从 S_PC 开始读 16 字节。
ldp 执行完后,x21 = pt_regs->pc,x22 = pt_regs->pstate。
第 2 行:上下文跟踪。
ct_user_enter和 el0_svc 里的 ct_user_exit 成对。没开 CONFIG_CONTEXT_TRACKING 的话展开为空,略过。
第 3 - 4 行:恢复用户态栈指针。
ldr x23, [sp, #S_SP] // load return stack pointermsr sp_el0, x23
ARM64 每个异常等级有自己的栈指针寄存器。内核跑在 EL1 模式,通常用的是 SP_EL1;用户态跑在 EL0 模式,用的是 SP_EL0。进内核后 SP_EL0 就一直闲着,kernel_entry 把它读出来存进了 pt_regs 的 sp 字段,这里再原样写回去。
既然一直闲着,为什么还要存了再恢复呢?
因为 SP_EL0 的值可能会变。一是当前线程睡眠期间,这个 CPU 上跑了别的线程,别的线程返回用户态时会往 SP_EL0 里写它自己的栈指针。二是信号处理会修改 regs->sp,让用户态回去之后落在一个新建好的信号栈帧上。前者要求必须备份,后者要求必须从 pt_regs 恢复。
第 5 - 6 行:恢复 ELR_EL1 和 SPSR_EL1。
msr elr_el1, x21 // set up the return datamsr spsr_el1, x22
x21 和 x22 在第 1 行代码那里已经装填成了 pc 和 pstate 字段,这里分别写进 ELR_EL1 和 SPSR_EL1,供 eret 使用。
不知不觉中,我们已经在恢复现场了。
第 8 - 13 行:恢复通用寄存器。
ldp x0, x1, [sp, #16 * 0]ldp x2, x3, [sp, #16 * 1]...ldp x26, x27, [sp, #16 * 13]ldp x28, x29, [sp, #16 * 14]ldr lr, [sp, #S_LR]
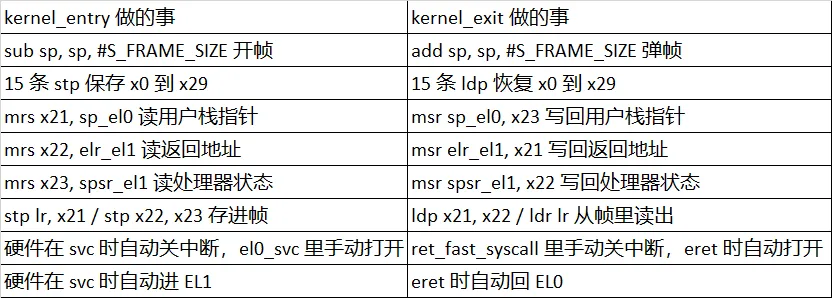
十五条 ldp 加一条 ldr,把 x0 到 x30 全部从 pt_regs 读回来。和 kernel_entry 里那十五条 stp 严格对应。lr 是 Link Register,链接寄存器,x30 的别名。
这里面有两个寄存器值得留意:
x0 = regs[0],也就是前面刚存进去的返回值。 x8 = regs[8],从 kernel_entry 存进去之后就没人碰过,所以还是 73。后面讲系统调用重启时要用到这一点。
第 14 行:弹出栈帧。
add sp, sp, #S_FRAME_SIZE和 kernel_entry 第一条 sub sp, sp, #S_FRAME_SIZE 对应。sp 加回 304 字节,pt_regs 这一帧就被弹掉了,sp 回到内核栈的栈底。
此时内核栈是空的,线程下次进内核时 kernel_entry 会在同一个位置重新压一帧。
第 15 行:eret
eretException Return。这一条指令做三件事:
PC 恢复为 ELR_EL1,也就是 regs->pc。 PSTATE 恢复为 SPSR_EL1,也就是 regs->pstate。 根据新 PSTATE 的 M[3:0] 字段切换异常等级和栈指针。我们的 pstate 是用户态保存下来的,M[3:0] = 0b0000 表示 EL0,于是 CPU 降到 EL0,栈指针切换成 SP_EL0。
PSTATE 里的 DAIF 也一起恢复了。用户态的 I 位是 0,所以前面关掉的中断到这里自动重新打开。
至此,CPU 回到用户态,从 svc 的下一条指令继续执行,x0 里是 sys_ppoll() 的返回值。
glibc 的封装函数拿到 x0 后对其进行检查。如果它落在 -4095 到 -1 之间(内核里 MAX_ERRNO 是 4095),就把它取反存进 errno 并返回 -1;否则原样返回,也就是就绪 fd 的个数。
3.3 kernel_entry vs kernel_exit
快路径到此结束。接下来看慢路径。
4. 慢路径:work_pending
work_pending:tbnz x1, #TIF_NEED_RESCHED, work_resched/* TIF_SIGPENDING, TIF_NOTIFY_RESUME or TIF_FOREIGN_FPSTATE case */ldr x2, [sp, #S_PSTATE]mov x0, sp // 'regs'tst x2, #PSR_MODE_MASK // user mode regs?b.ne no_work_pending // returning to kernelenable_irq // enable interrupts for do_notify_resume()bl do_notify_resumeb ret_to_userwork_resched:bl scheduleret_to_user:disable_irq // disable interruptsldr x1, [tsk, #TI_FLAGS]and x2, x1, #_TIF_WORK_MASKcbnz x2, work_pendingenable_step_tsk x1, x2no_work_pending:kernel_exit 0ENDPROC(ret_to_user)
跳到这里时,x1 里还是 ret_fast_syscall 在关中断状态下读出来的 flags,中间没有任何指令改过它。
第 2 行:检查是否要调度出去,让出 CPU。
tbnz x1, #TIF_NEED_RESCHED, work_resched前面介绍过 tbz,这里的 tbnz 是目标 bit 位非零就跳转。
x1 里装的是 thread_info 的 flags 成员,如果它的 TIF_NEED_RESCHED 标志位置位了就跳到 work_resched:
work_resched:bl schedule
调用 C 函数 schedule() 让出 CPU。
注意,这里 schedule() 是在关中断的状态下被调用的。等当前线程再次被调度回来,从 context_switch() 后半段的 finish_lock_switch() 出来时中断会被重新打开。所以 schedule() 返回时中断是开着的。
schedule() 返回后没有跳转指令,直接落到紧接着的 ret_to_user 标签。
TIF_WORK_MASK 有四个标志位,TIF_NEED_RESCHED 是第一个被优先处理的。为什么?
因为如果有更高优先级的线程等着运行,那让它先跑是第一要务。其它三个标志位对应的事情,说到底属于当前线程的内部事务。更高优先级的线程已经如饥似渴地等着 CPU 资源了,你还在这里死皮赖脸地处理这些事务不肯让出 CPU,不合适。
第 4 - 7 行:确认是否是回用户态。
ldr x2, [sp, #S_PSTATE]mov x0, sp // 'regs'tst x2, #PSR_MODE_MASK // user mode regs?b.ne no_work_pending // returning to kernel
ldr 把 pt_regs 的 pstate 字段读到 x2。
PSR_MODE_MASK 是 0xF,所以 tst 用来测试 pstate 的 M[3:0] 位域是否为 0。0 表示 EL0。
如果不是 0,说明这个 pt_regs 保存的不是用户态现场,那就不能去处理信号,b.ne 将直接跳到 no_work_pending。no_work_pending 标签处只有 kernel_exit 0 这一条指令。
第 5 行的 mov 指令提前把 pt_regs 的地址放进 x0,作为将来调用 C 函数 do_notify_resume() 的第一个参数。
第 8 - 9 行:开中断,然后调用 do_notify_resume()。
enable_irq // enable interrupts for do_notify_resume()bl do_notify_resume
进 C 函数之前得先把中断打开,原因是 do_notify_resume() 可能会睡眠。
为什么因为 do_notify_resume() 可能会睡眠就必须要开中断呢?不打开行不行?
先补一个概念,IPI(Inter-Processor Interrupt,处理器间中断)。
多核系统里,一个 CPU 要让另一个 CPU 做点事,比如刷掉它的 TLB、让它重新调度、在它上面执行一个函数,唯一的办法就是给它发一个中断。这个由 CPU 发给 CPU 的中断就是 IPI。
目标 CPU 收到 IPI 后进中断处理程序,做完要求的事再返回。这也意味着,如果目标 CPU 关着中断,IPI 就只能挂在中断控制器里等,等到它开中断为止。
IPI 有一种同步用法:发送方发出 IPI 后原地自旋,直到目标 CPU 执行完再继续。
kernel/smp.c 的 smp_call_function_single() 就是这样,它开头有一句检查:
/** Can deadlock when called with interrupts disabled....*/WARN_ON_ONCE(cpu_online(this_cpu) && irqs_disabled()&& !oops_in_progress);
注释说得很直白:关着中断调用它可能死锁。
设想 CPU 0 和 CPU 1 上各有一个线程,都关着中断,同时向对方发 IPI 然后自旋等待。CPU 0 收不到 CPU 1 的 IPI,CPU 1 也收不到 CPU 0 的,两个 CPU 永久卡死,而且没有任何东西能打破它,因为打破它需要的恰恰是中断。只要有一边中断是开的,它就能在自旋中响应对方的 IPI,把对方放走,死锁就不成立。
回到 do_notify_resume()。它的执行路径里有个一样的场景。
_TIF_NOTIFY_RESUME 分支路径会执行 task_work_run(),这个函数进而执行延迟的 fput(),某些文件(比如 perf 事件文件)的 release 路径就会调用 smp_call_function_single(),这个函数最终就会发一个 IPI 中断给目标 CPU。
work_pending 又是所有线程回用户态的公共路径,如果这里少一条 enable_irq,等于让每一个回用户态的线程都变成潜在的关中断等待者。只要系统里出现两个线程同时互等对方的时刻,死锁就必然发生。
内核对此的处理是一刀切:关中断状态下不允许调用任何可能睡眠或等待的函数。might_sleep() 检查到 irqs_disabled() 就打印 "BUG: sleeping function called from invalid context",在开发阶段就把这种场景扼杀在摇篮里。do_notify_resume() 的代码路径上处处都有这个检查。
注意,此时 x0 = pt_regs 的地址,x1 = thread_info.flags,刚好对应 do_notify_resume() 的两个参数。
这个函数在 arch/arm64/kernel/signal.c:
asmlinkage voiddo_notify_resume(struct pt_regs *regs,unsigned int thread_flags){if (thread_flags & _TIF_SIGPENDING)do_signal(regs);if (thread_flags & _TIF_NOTIFY_RESUME) {clear_thread_flag(TIF_NOTIFY_RESUME);tracehook_notify_resume(regs);}if (thread_flags & _TIF_FOREIGN_FPSTATE)fpsimd_restore_current_state();}
代码结构非常简单,一目了然。按 thread_flags 里的三个标志依次处理对应的任务。
TIF_NEED_RESCHED 不在这里处理,汇编里已经先处理掉了。
本文重点关注 _TIF_SIGPENDING 标志位,也就是 do_signal() 函数。后面两个标志位略过。
do_signal() 的整个实现比较长,放到下篇单独来分析它。我们接着往下看。
第 10 行:跳到 ret_to_user 继续。这是返回用户态前的最后一程。
b ret_to_userdo_notify_resume() 返回后不是直接 kernel_exit,而是跳到 ret_to_user:
ret_to_user:disable_irq // disable interruptsldr x1, [tsk, #TI_FLAGS]and x2, x1, #_TIF_WORK_MASKcbnz x2, work_pendingenable_step_tsk x1, x2no_work_pending:kernel_exit 0
这几条指令和 ret_fast_syscall 几乎一样,只是少了存 x0 和检查跟踪标志两步。它先关中断,再重新读一次 flags,再检查 _TIF_WORK_MASK。还有工作就再跳回 work_pending,没有了才 kernel_exit。
第 2 行:do_notify_resume() 一调用完就得立刻关掉中断。原因在前面第 2 节已经解释过了。
第 3 - 5 行:这个套路已经非常熟悉了。读出 flags,然后检查 _TIF_WORK_MASK 这几个 bit 位,有任何一个置位了就跳回上面的 work_pending 再走一次慢路径。
第 6 - 8 行:和快路径的最后两行一模一样。第 3 节已经详细分析过了。
这里有个问题值得思考:为什么要走 work_pending 循环,只处理一次不行吗?
这个问题可以拆分成两个子问题:
处理过一次后,这几个 bit 位为什么还会被再次置位? 如果真的置位了,置之不理可不可以?
让我们先再回看一下第 2 节里介绍这四个 bit 位的那张表。
对于第一个子问题,标志位本质上只是 thread_info 里的一块内存,这里的返回路径并没有对这块内存做任何互斥访问的措施。所以只要置位条件满足,这几个 bit 位完全有可能被再次置位。
至于每个 bit 位对应的置位条件,有很多种场景都能满足,这里不展开了。
我想重点聊聊第二个子问题:
TIF_SIGPENDING:如果 ret_to_user 里再次检测到这个标志置位了,说明又来了新的信号。旧的信号在返回用户态之前都处理了,新的信号没理由就不管了。为了保证信号送达的语义完整性,新来的信号也得在这处理。
TIF_NEED_RESCHED:如果 ret_to_user 里检测到这个标志置位了,说明更高优先级的线程正等着 CPU 资源,当前这个低优先级的线程的事情都得放放,必须调度出去让出 CPU。所以得处理。
TIF_NOTIFY_RESUME:这个标志的语义就是在线程回用户态之前执行一个回调,既然置位了,就说明有回调等着执行。所以也得处理。
TIF_FOREIGN_FPSTATE:这个标志置位说明浮点寄存器里不是即将运行的这个线程的数据,那必须得在返回用户态之前处理好。
可见,每个 bit 位背后对应的任务都是在返回用户态之前就必须要处理掉的。
进一步追问,跳出 work_pending 循环后,到真正返回用户态,还有一些代码要执行,万一在此期间又有标志置位了呢?
答案是返回用户态后再处理,但不会漏掉。
假设我们当前的线程运行在 CPU0 上,CPU 1 上的线程给我们发信号,它会把我们线程的 TIF_SIGPENDING 标志置位,这时我们可能正在执行 kernel_exit 的某条 ldp 指令。
CPU1 上的线程发现当前线程没睡,就去调用 kick_process():
voidkick_process(struct task_struct *p){int cpu;preempt_disable();cpu = task_cpu(p);if ((cpu != smp_processor_id()) && task_curr(p))smp_send_reschedule(cpu);preempt_enable();}
if 下一行的 smp_send_reschedule(cpu) 会给 CPU0 发一个重新调度的 IPI 中断。这个 IPI 到达时我们的中断是关的,并不会响应它,但它也不会丢失,而是挂在中断控制器里。
eret 一执行,PSTATE 恢复成用户态的 I = 0,中断放开,挂着的 IPI 立刻被响应。CPU0 可能连用户态的一条指令都还没执行就立刻进了中断异常流程。
IPI 从 el0_irq 进来,处理函数本身几乎什么都不做,但 el0_irq 的返回路径是 b ret_to_user,那里会重新读标志,看到 TIF_SIGPENDING 置位,便进 do_signal() 处理。
所以 kernel_exit 期间置位的标志并没有被漏掉,而是被延后处理了。
至此,整个返回流程只剩下 do_signal() 还未分析,这将是下篇的内容。