ARTICLE · 1051351
你熬夜读文档的时候,对手已经让AI几十秒读完了
很多人对AI的印象还停留在“问一句答一句”的聊天阶段。但今天的大模型,已经能在几秒内读完一份几百页的合同、一整年的财报、一整套技术文档,然后告诉你:重点在哪、风险在哪、问题在哪。
这不是科幻,这是正在发生的现实。
01 以前读文档靠人,现在读文档靠AI
先看一个真实场景。
一家企业的法务团队,过去审一份采购合同,需要逐条阅读、标注风险、比对模板,平均耗时2到3小时。遇到并购项目,几十份合同堆在一起,通宵是常态。
现在,他们把合同上传到AI系统,模型在几十秒内完成全文阅读,自动标出:付款条款异常、违约责任不对等、知识产权归属模糊、竞业限制过宽等风险点,并给出修改建议。
法务只需要复核AI标注的内容,时间从几小时压缩到十几分钟。
这不是个例。财务分析、技术文档检索、病历阅读、招投标文件审查——所有“需要大量阅读”的场景,都在被AI重新定义。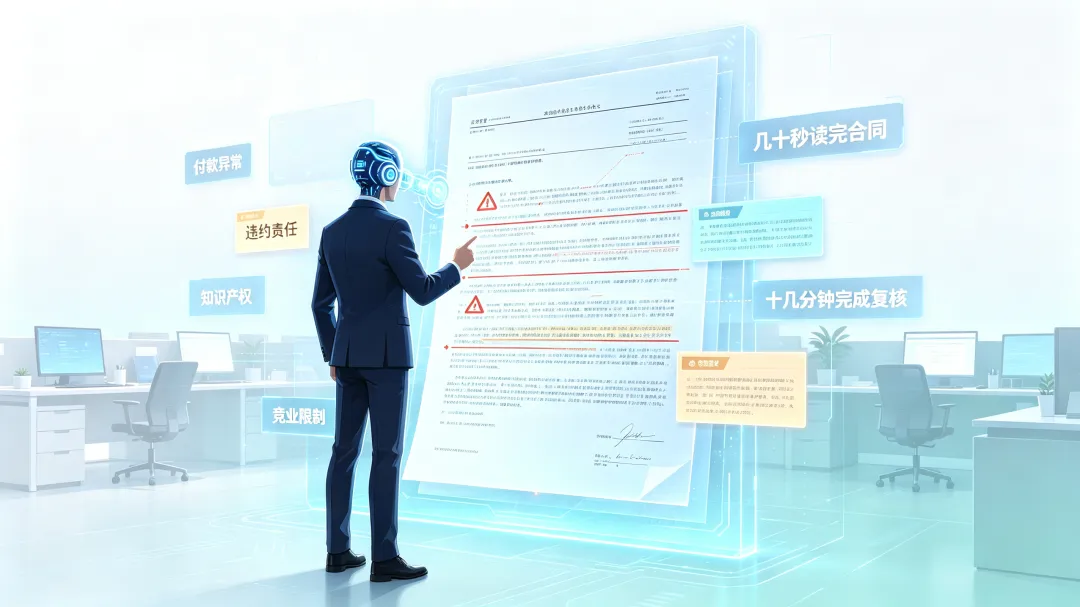
02 大模型凭什么能“读懂”长文档?
很多人会问:AI不就是搜关键词吗?它真的能“读懂”吗?
答案是:以前不能,现在能了。
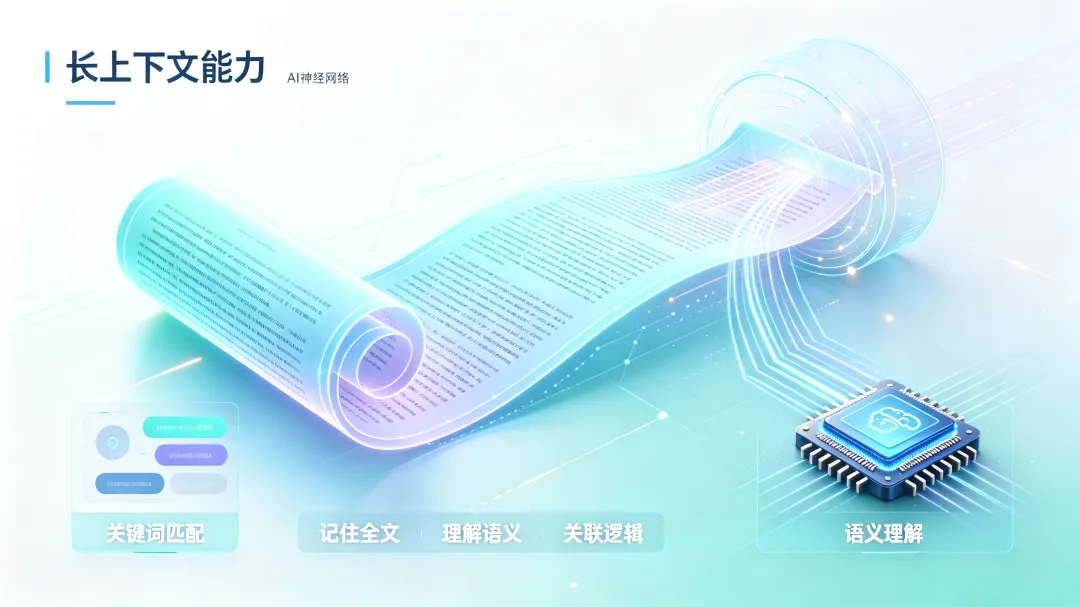
传统搜索的逻辑是“匹配关键词”。你搜“违约责任”,它找到包含这四个字的段落。至于这段话是什么意思、和上下文什么关系,它不管。
大模型完全不同。它的工作方式是理解语义。
当你把一份合同丢给大模型,它会:
逐段理解每一句话的含义
建立段落之间的逻辑关系
识别条款之间的冲突和呼应
判断哪些内容构成风险、哪些是标准表述
用自然语言告诉你结论
这背后依赖的是大模型的长上下文能力。
早期的模型只能记住几千个Token,大概相当于几页纸。文档稍长,它就“忘了前面说过什么”。而今天的主流大模型,上下文窗口已经扩展到几十万甚至上百万Token。
百万Token是什么概念?相当于一次性读完整本《三体》三部曲,或者一整套上市公司年报,或者一个中型项目的全部代码库。
能记住,才能读懂。
03 长文档理解,到底能用在哪些场景?
场景一:合同与法务审查
上传合同,AI自动识别风险条款、比对标准模板、生成审查意见。支持批量处理,几十份合同同时审,效率提升几十倍。
场景二:财报与研报分析
上传年报、季报、研报,AI提取关键财务指标、对比历史数据、总结经营变化、提示异常波动。投资者和分析师不用再逐页翻找。
场景三:技术文档与知识库问答
上传产品手册、技术规范、运维文档,AI构建知识库。员工提问,AI直接给出答案,并标注出处。新员工培训周期大幅缩短。
场景四:病历与医学文献阅读
上传病历,AI提取关键病史、诊断依据、用药记录。上传医学文献,AI总结研究方法、结论、局限性。辅助医生快速获取信息。
场景五:招投标文件审查
上传招标文件,AI提取资质要求、评分标准、关键时间节点。上传投标文件,AI检查是否逐项响应、有无遗漏。减少废标风险。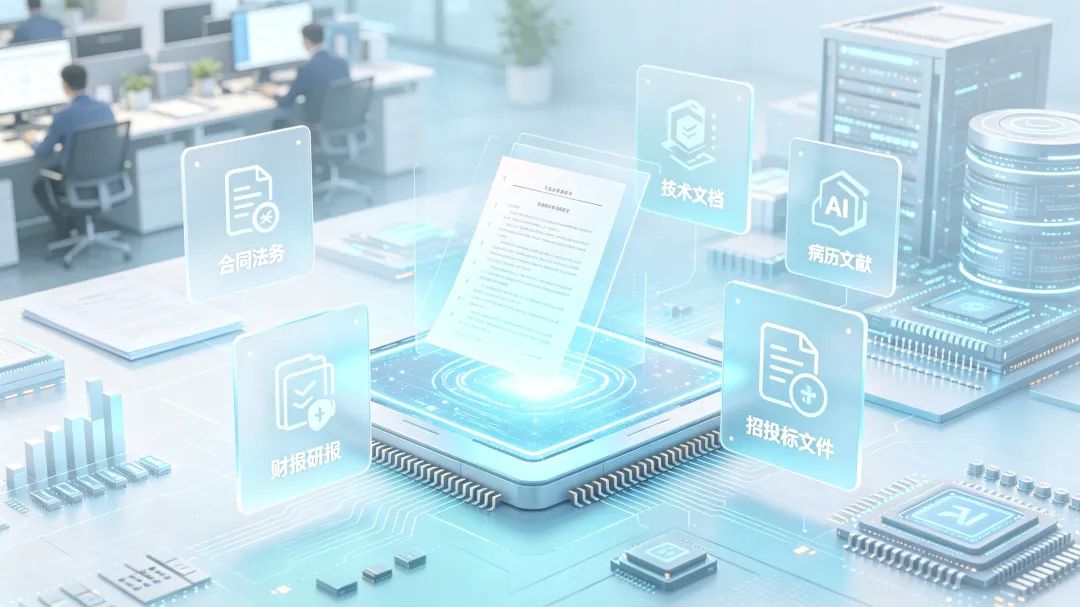
04 长文档理解背后,靠什么撑住?
大模型能读懂长文档,靠的是两层能力:
第一层:模型能力。
长上下文窗口、强语义理解、多轮推理——这些是模型本身的本事。
第二层:算力支撑。
百万Token的上下文意味着什么?意味着推理时的显存占用大幅增加,计算量成倍上升。一份长文档的推理请求,消耗的算力可能是普通对话的几十倍甚至上百倍。
如果算力不够,会出现什么情况?
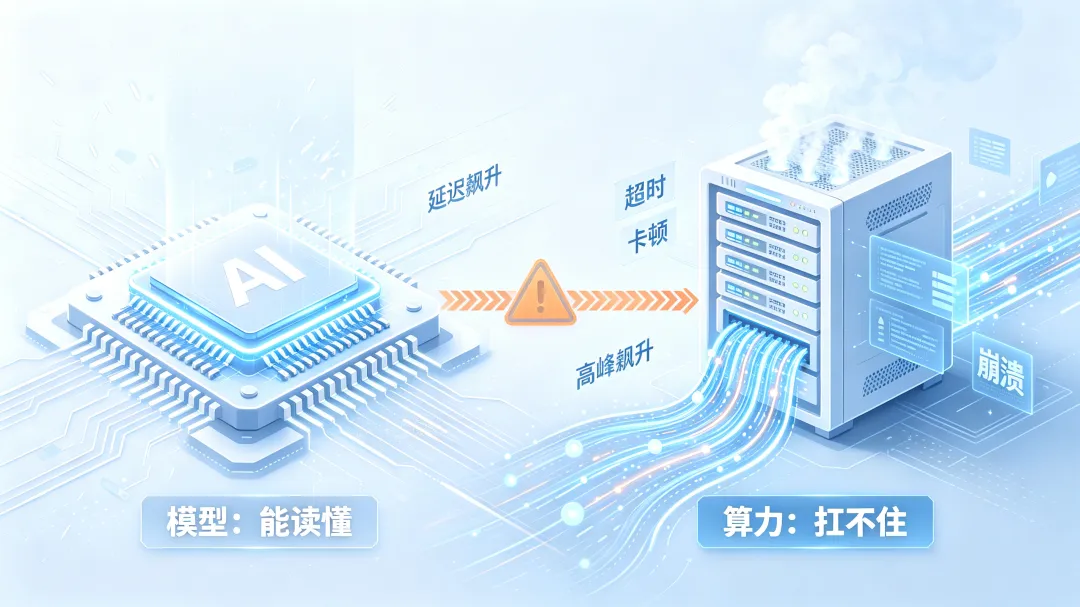
文档读到一半,超时了
多人同时上传,服务卡死了
高峰期使用,延迟从几秒飙到几十秒
模型决定了AI能不能读懂,算力决定了AI能不能稳定地读懂。
05 想让AI读懂文档,先问自己三个问题
第一,你的文档有多长?
几页的文档和几百页的文档,对算力的要求完全不同。先明确业务场景中的文档长度分布。
第二,你的并发有多高?
一个人用和一百个人同时用,是完全不同的负载。上线前必须知道:高峰期有多少人同时上传文档?
第三,你的延迟要求是多少?
法务审合同可以等30秒,客服问答不能超过3秒。不同场景对推理速度的要求不同,算力配置也不同。
这三个问题不回答清楚,AI文档理解系统上线后,大概率会遇到:能用,但不好用;平时能用,高峰就崩。
写在最后
AI不是只会聊天。
它能读合同、读财报、读病历、读代码、读任何你不想逐页翻的文档。它能把几小时的工作压缩到几分钟,能把“找信息”变成“直接拿答案”。
但前提是:模型选对,算力撑住。
模型决定能力上限,算力决定体验下限。
硅普科技 · AI算力压测与性能调优
针对长文档理解、知识库问答、多模态推理等场景,提供算力压测、性能瓶颈排查与调优方案。测出集群极限,找到性能瓶颈,让AI文档理解系统不仅“能用”,更“好用、稳定、扛得住”。