ARTICLE · 1056198
Jev 火了:当 AI 不再聊天,开始为软件做判断
Jev 火了:当 AI 不再聊天,开始为软件做判断
凌晨,一条客户消息弹出来:“支付接口一直失败,明天活动就要开始了,麻烦尽快处理。” 系统需要立刻判断:这是账单问题,还是技术故障?紧急程度有多高?可以自动分流,还是应该让人工先看一眼? 这类看似不起眼的小判断,正是新模型 Jev 想解决的问题。它不是另一个陪人聊天的 GPT,而是为软件里的分类、路由和风险判断而设计。 2026 年 9 月 15 日,TypeSafe AI 正式介绍了 Jev,称其为首个公开的 System One 模型。这里的“System One”借用了“快思考”的意象:不是先写出一大段分析,再让程序费劲地从文字里找结论,而是把当下的状态和事先定义好的问题交给模型,让它返回软件能直接使用的结构化判断。TypeSafe AI 官方发布文章 一句话讲清楚:聊天模型把结果说给人听,Jev 把判断交给软件使用。 想象一个很普通的工作日。客服后台又来了几百条消息:有人询价,有人申请退款,有人的支付接口坏了,也有人只是问了一句发票在哪里下载。 人扫一眼就能大致分流。软件却没那么容易写规则:“出现退款两个字就交给售后”显然不够,因为用户可能说的是“我不需要退款”;“出现失败就算技术故障”也不对,因为失败的可能是付款、登录或者优惠券。 于是很多团队让大语言模型读消息,再写一段分析。问题来了:程序最终要的往往不是分析,而是一个动作——交给技术支持、转账单团队、标记紧急,或者先让人工看一眼。 这时,写得越多不一定越有用。系统还得提取答案、检查格式、处理模棱两可的表述。对于一天发生几十万次的小判断,这些额外步骤会积累成时间和成本。 Jev 切入的正是这个缝隙:把“说给人听的回答”,换成“交给软件用的判断”。 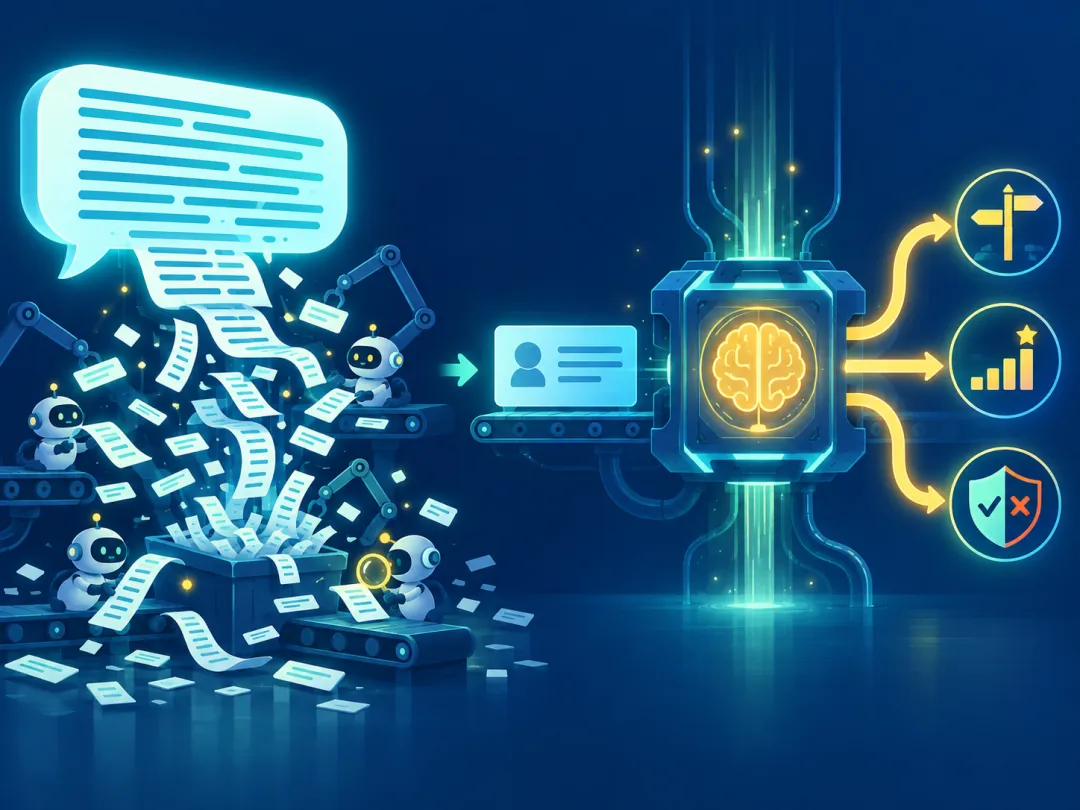
官方把 Jev 的问题分成三类。名字有点技术味,但意思很直白。TypeSafe 三种问题类型说明 第一类,Choice:在给定的选项里选一个。 比如一条客户消息该去“账单”“技术”还是“销售”队列。系统提前列好可选项,模型在这些选项中判断,并给出各选项的概率。它不能凭空造出一个不存在的部门。如果真实世界可能超出这些选项,就应该预留“其他/无法判断”,别把每条消息硬塞进某个队列。 第二类,Score:判断处于哪种程度。 比如一条投诉是“普通咨询”“明显不满”,还是“强烈愤怒”。这不是拍脑袋给个满分 100 的数字,而是先由人定义好每个等级的含义,再让模型判断它落在哪里。结果可以处在两个等级之间。 第三类,Noul:判断一个说法有多大可能成立。 “这条消息是否在催促尽快处理?”“这段文字是否包含个人信息?”这类问题可以得到一个从 0 到 1 的值。越接近 1,越倾向于“是”;接近 0.5,则意味着答案不明朗。 这三种判断可以围绕同一条消息同时提出。于是,一个客服系统不仅知道该把问题送到哪里,也能知道用户是否焦急、是否涉及敏感内容、需不需要升级处理。 但这里有个容易被误解的地方:**Jev 给出判断,不等于它自己执行动作。**谁能退款、谁能删除数据、哪种情况必须人工复核,依然应由业务规则和权限系统控制。 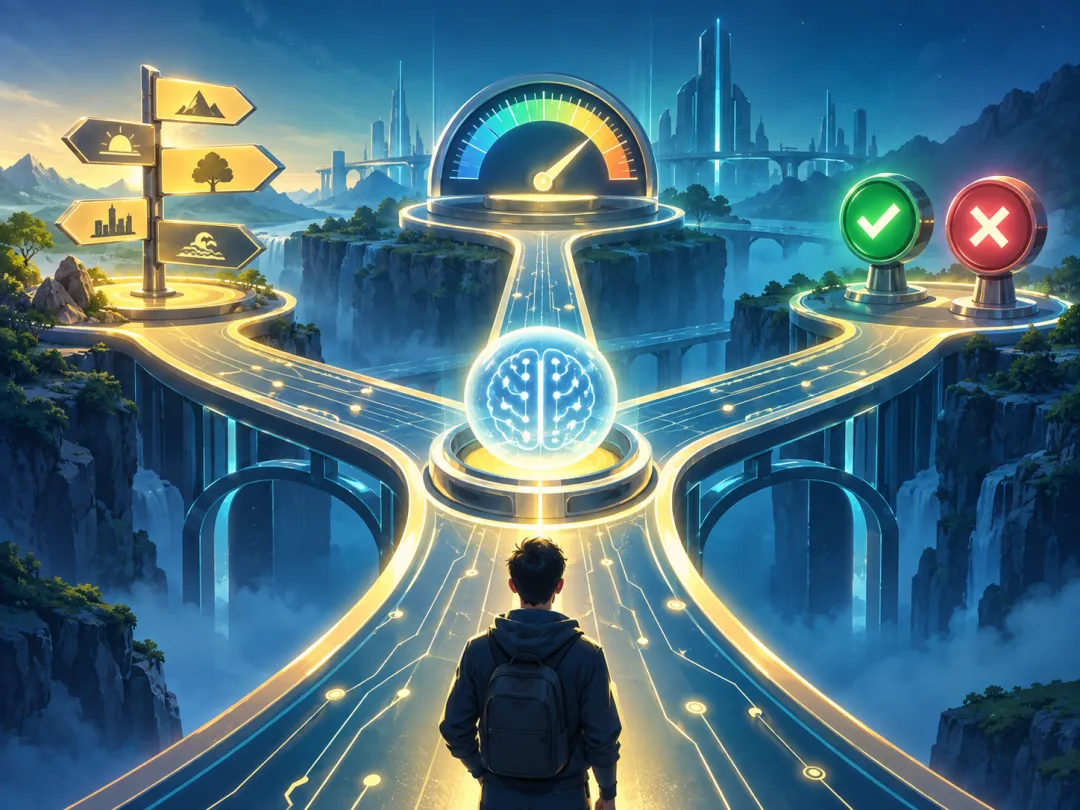
大家对 AI 的担忧,往往不是它完全不会回答,而是它答得很像那么回事,结果却错了。 假如系统收到一条含糊的售后消息。模型说“交给技术团队”,听起来已经有结论;但如果它同时认为“账单团队”也很可能合适,软件就不应该像收到一条铁律那样直接执行。 Jev 的 Choice 和 Score 会返回各选项或等级的概率分布,以及概括这种分布是否集中的 confidence(置信度);Noul 则直接返回“这个说法为真”的概率,没有独立的置信度字段。TypeSafe 不确定性说明 区别不只是多了一个数字,而是软件终于可以设计三条路:判断足够明确、后果可控的,自动处理;有疑问的,请用户补充或确认;涉及钱、隐私和重要权益的,交给人工审核。 **注意:confidence 不是正确率保证。**一次判断即使看起来很笃定,也可能错。分界线设在哪里,不能抄一个通用数字;要拿自己的真实业务样本验证,尤其要看“高信心但判断错误”的案例有多少。 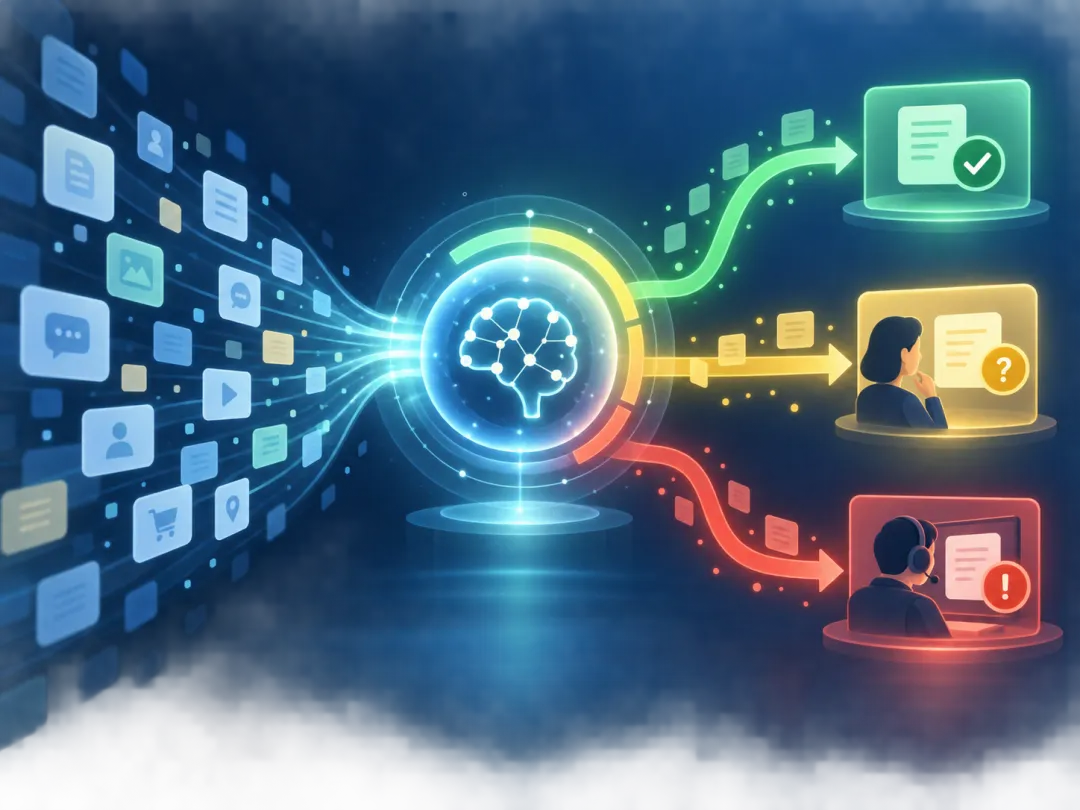
普通聊天模型的目标,是一个词接着一个词生成内容。你要它解释、创作、写代码,这种自由度很宝贵;但只为判断“选 A 还是选 B”,再生成一段话,未必经济。 TypeSafe AI 表示,Jev 采用面向结构化判断的模型设计、并行输出方式,以及称为 RLCD 的训练方法——它希望模型给出的概率更能反映真实的不确定性。官方公布的单次响应时间区间为 70~500 毫秒,并展示了特定工作流里的速度和成本优势。TypeSafe AI 官方发布文章 这些数字值得关注,但不要直接翻译成“你的业务上线后一定快上百倍”。网络距离、问题长度、选项设计、额外审核,以及原有系统本来用的是什么方法,都会改变最终效果。官方也承认,其工作流评测中的高倍数收益很可能处于实际收益的较高一端。 更重要的是,两类模型解决的并不是同一个问题。 解释一份复杂合同、生成一份产品方案、处理开放式问题,仍然需要擅长语言和推理的模型。Jev 更适合在明确的候选项和业务边界内,反复做范围较窄、可检验的判断。 如果规则本来就能精确表达,比如“金额大于某值必须二次审批”,直接写规则更简单,也更可靠。无需为了“用了 AI”而给每个分支都接一个模型。 如果你不是开发者,可能暂时不会像打开聊天软件那样直接使用 Jev。但你每天用到的服务,可能会越来越多地出现这种“看不见的 AI”。 邮件被自动归类,客服请求被更快地送到合适的人手里,购物平台发现异常交易后要求确认,办公助手判断下一步该搜索资料还是提醒你补充信息……背后需要的,并不总是一篇漂亮的回答,而是大量小而准确的决定。 Jev 把一个值得讨论的问题摆到了台面上:AI 的进步,未必每次都表现为“更会说话”。有时,它表现为软件在该判断的时候,知道自己能判断到什么程度。 我更愿意把它看成一种分工,而不是替代:大模型负责解释和创造,决策模型负责在清楚的边界里快速判断,代码和人负责最终的约束与兜底。 它现在还很新,真正的可靠性需要长期、独立地在各种场景里检验。但“让 AI 的不确定性进入软件设计”,这个方向,值得认真看一眼。 如果是你,最想把工作里哪一种重复的小判断交给 AI?欢迎在留言区聊聊。
一、你每天都在做的小判断,恰恰是软件最难自动化的部分
二、它究竟会做什么?记住三个动作就够了
三、真正有价值的,也许是它敢说“不确定”