ARTICLE · 1056889
AI 编程助手——用 AI 帮你写代码、Debug、Code Review
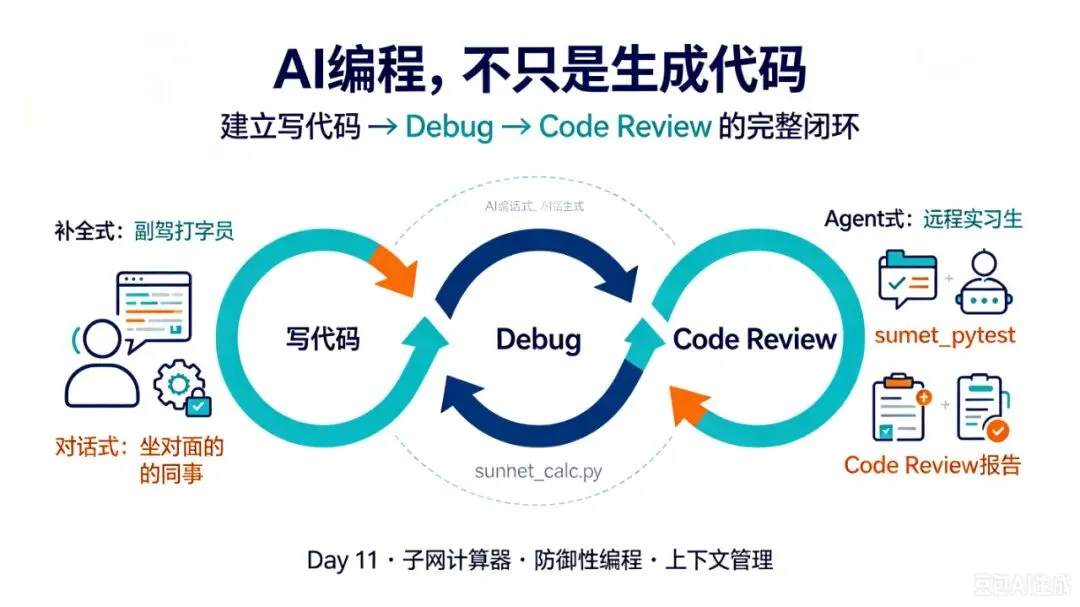
学习目标
今天我们要把"AI 辅助编程"从零散技巧升级成一套可复用的工作闭环。很多初学者第一次用 AI 写代码时,会觉得"哇,它竟然能跑",但第二天就忘了让它 Debug,更从没让它 Review 自己的代码。结果就是:能生成代码片段,却做不出可靠的工具,代码里藏着自己都没发现的坑。学完今天,你应当掌握三件事:第一,理解 AI 编程助手的三类形态(补全式、对话式、Agent 式)以及各自适合的场景;第二,建立"写代码 → Debug → Code Review"的完整闭环,知道每一步怎么给 AI 下指令;第三,能用这套闭环,独立产出一个能跑、有测试、经过审查的真实网络小工具(例如子网计算器或端口扫描器)。今天你拿到的产出不是一段玩具代码,而是一个带单元测试、带 Review 报告、可以放进工具箱反复用的脚本。
核心内容
第一部分:概念理解(用 AI 解释)
什么是 AI 编程助手?
打开 ChatGPT 或 Claude,输入这个问题:
请用最通俗的语言解释:AI 编程助手到底是什么?它和"搜索引擎查代码""在 Stack Overflow 抄答案"的本质区别在哪里?为什么有人说"会用 AI 写代码的人,比会背语法的人更强"?
你会得到一个核心结论:AI 编程助手不是"代码搜索引擎",而是一个能理解上下文、能根据你的描述生成代码、能解释、能调试、能审查的协作伙伴。区别在于——查 Stack Overflow 时你要自己判断答案对不对、适不适合你的场景;而 AI 能结合你的具体上下文(你在用什么库、跑在什么环境、要解决什么问题)给出针对性代码,还能在你追问时解释原因。
三类 AI 编程助手形态
让 AI 帮你梳理清晰:
请对比以下三类 AI 编程助手的定位、优缺点和适用场景:1. 补全式(如 GitHub Copilot):你在编辑器里打字,它实时猜下一行2. 对话式(如 Cursor Chat / ChatGPT):你用自然语言描述需求,它生成或修改代码3. Agent 式(如 Claude Code / Aider):它自己读你的整个项目、自己规划、自己改多文件、自己跑命令
关键理解点:
补全式像"副驾打字员",适合你已经有思路、只想加速敲代码;但你在没思路时它帮不上忙。
对话式像"坐你对面的同事",你描述需求它产出代码,适合从零构思功能、解释陌生代码。
Agent 式像"远程实习生",你把任务丢给它,它读项目、改文件、跑测试、自我纠错;适合跨文件重构、批量改造、搭建项目骨架。
最重要的心智转变
让 AI 用一句话点醒你(可以直接问它):"一个不会写代码的人,如何用 AI 编程助手做出可靠的工具?他的核心能力到底是什么?"
答案高度一致:你的核心能力从"写代码"变成了"描述需求 + 审查产出 + 判断对错"。你不需要背语法、记 API,但你必须能说清"我要什么",并且看得懂 AI 给的代码有没有问题。这正是本计划一直强调的——AI-First,让你做"架构师 + 审查员",AI 做"打字员 + 初稿作者"。
新手最常见的三大误区
让 AI 帮你列一列,你会看到自己可能正踩的坑:
"AI 写的就能直接用":初稿永远需要审查,尤其边界和异常。今天实验 2、3 已经证明这点——没捕获的异常、没考虑的特殊掩码,都会让代码在生产环境翻车。
"我把需求说一遍就够了":复杂需求要分步骤、给示例、给约束。模糊的一句话换来的往往是"看起来对、跑起来错"的废稿,反而更费时间。
"AI 比我自己懂我的项目":不,它只懂你给它的上下文。你不提供项目结构、报错环境,它就只能猜——猜错的概率比你想象的高。
把这三个误区记在便签上,每次用 AI 写代码前看一眼,能帮你避开八成低级返工。
第二部分:动手实验
下面我们用一个完整的闭环做出一个真实工具:子网计算器(Subnet Calculator)。它能根据 IP 和掩码,算出网络地址、广播地址、可用主机数。网络工程师天天和子网打交道,这东西能直接进你的工具箱。
实验 1:用对话式 AI 写第一版代码
打开 Cursor(或 ChatGPT),输入:
请用 Python 写一个子网计算器 subnet_calc.py:1. 接受命令行参数:一个 IP 地址和一个掩码(如 192.168.1.10 /24)2. 计算并输出:网络地址、广播地址、可用主机范围、可用主机数量3. 使用 ipaddress 标准库,不要手写位运算4. 命令行参数用 argparse 解析5. 加上基本的输入校验(非法 IP/掩码要报错提示)
观察 AI 生成的内容,你会看到它用了ipaddress这个 Python 内置库——这正是我们想要的,比自己写位运算稳得多。一个典型产出是:
pythonimport argparseimport ipaddressdef main():parser = argparse.ArgumentParser(description="子网计算器")parser.add_argument("ip", help="IP 地址,如 192.168.1.10")parser.add_argument("netmask", help="掩码,如 24 或 255.255.255.0")args = parser.parse_args()try:if args.netmask.isdigit():network = ipaddress.ip_network(f"{args.ip}/{args.netmask}", strict=False)else:network = ipaddress.ip_network(f"{args.ip}/{args.netmask}", strict=False)except ValueError as e:print(f"输入有误:{e}")returnhosts = list(network.hosts())print(f"网络地址:{network.network_address}")print(f"广播地址:{network.broadcast_address}")print(f"可用主机数:{network.num_addresses - 2}")if hosts:print(f"可用范围:{hosts[0]} ~ {hosts[-1]}")if __name__ == "__main__":main()
运行它:
bashpython subnet_calc.py 192.168.1.10 24# 网络地址:192.168.1.0# 广播地址:192.168.1.255# 可用主机数:254# 可用范围:192.168.1.1 ~ 192.168.1.254
观察要点:注意 AI 用了try-except包裹可能出错的地方——这是"防御性编程"的雏形。先记住这个模式,等会儿实验 2 我们会故意触发它。
实验 2:故意制造 Bug,让 AI Debug
学习 Debug 最好的方式是"先亲手制造一个错误,再让 AI 修"。我们故意把代码改坏——把ipaddress.ip_network的调用去掉异常处理,然后传入一个非法输入:
bashpython subnet_calc.py 999.1.1.1 24# 噗——程序直接抛 Traceback,满屏红色错误
把整个 Traceback 复制给 AI:
下面这段报错是什么意思?根因是什么?怎么改?(粘贴完整 Traceback)
AI 会告诉你:根因是ValueError没有被捕获,程序直接崩溃。它会建议你把异常包在try-except里,并且——注意这里的重点——把异常信息翻译得对用户友好,而不是把 Python 的原始报错甩给用户。这一刻你学到的不是某个语法,而是"防御性编程"的思维:永远假设用户会输入错误数据。
Debug 黄金步骤:①复现(用最小输入稳定触发错误)→ ②隔离(确认是哪一行/哪个输入触发)→ ③把"完整报错 + 相关代码 + 你的环境"一起给 AI → ④读 AI 的修复并自己跑一遍验证。永远不要只贴半句报错就问"怎么回事"。
实验 3:让 AI 做 Code Review
代码能跑不等于代码好。把你的脚本发给 AI,输入:
请对我的 subnet_calc.py 做一次 Code Review,重点看:1. 有没有冗余或重复代码(比如我两次调用了 ip_network)2. 异常处理是否完善3. 有没有边界情况没考虑(比如 /31、/32 这种特殊掩码)4. 命名和可读性请直接给出修改后的完整代码。
AI 会指出一个你没注意的坑:/31和/32网络没有"可用主机数减 2"这种说法(点对点链路和单地址),你的公式会算出负数或错误值。它会给出修复版。这就是 Code Review 的价值——在你上线前,AI 帮你把没想到的边界先踩一遍。
第三部分:深入原理
为什么"把需求写清楚"比"会写代码"更重要?
这里有一个反直觉的真相:AI 编程助手时代,限制你的不再是"会不会写代码",而是"能不能把需求描述清楚"。让 AI 解释给你听:
为什么在 AI 编程时代,"写清楚需求"比"会写代码"更关键?一个模糊的需求("帮我写个网络工具")和一个清晰的需求("用 Python + scapy 写端口扫描器,支持 -p 指定端口范围、-t 指定目标、多线程、输出 JSON"),AI 给出的代码质量差多少?请举例说明。
你会理解:提示词质量直接决定代码质量。给 AI 的信息越具体(语言、库、输入输出格式、边界条件、失败处理),它给的代码越接近可用。模糊的需求只会换来"看起来对、跑起来错"的废稿。
给 AI 写代码的黄金提示模板
经过大量实践,下面这个模板能稳定产出高质量代码,今天起就可以套用:
角色:你是一名资深 Python 网络工具开发工程师。任务:<用一句话说清要做什么>约束:- 使用 <指定库/框架>- 输入:<格式>- 输出:<格式>- 必须处理 <边界情况>- 代码要 <可读/有注释/有测试>参考:<贴上你已有的相关代码或报错>
把"参考"这一项填上,AI 就能结合你的真实上下文产出,而不是凭空编造。这是把"对话式 AI"用出"专家级"效果的关键一招。
上下文工程实战:怎么把整个项目交给 AI
当你用 Agent 式工具(如 Claude Code)时,它自动索引项目;但用对话式 AI 时,你要手动喂上下文。最有效的方式是:先贴"项目结构"(用tree或ls输出)让 AI 知道文件布局,再贴"相关代码段"(不是全部,而是和当前任务相关的 1-3 个文件),最后贴"报错或期望输出"。示例提示:
这是我们项目的结构(tree 输出):.├── subnet_calc.py├── test_subnet_calc.py└── ips.txt我现在想在 subnet_calc.py 里加"从 ips.txt 批量读取 IP 并循环计算"的功能,ips.txt 每行一个 "IP 掩码"。请告诉我改哪几处、怎么改,并给出新增代码。
你会发现:给了结构 + 相关文件 + 明确目标,AI 的回答准确率大幅提升。这就是"上下文工程"——不是写更长的提示词,而是给更对的上下文。
如何判断 AI 给的代码能不能用(审查清单)
光会生成不够,你得会审。把下面这份清单存进你的笔记,每次 AI 给完代码,逐项过一遍:
能跑吗:先
python xxx.py实际运行,别只看代码"长得对"。边界对吗:空输入、非法输入、超大/超小值(如 /31、/32 掩码)会不会崩?
异常捕获了吗:所有可能失败的外部操作(文件、网络、用户输入)是否都有
try-except?有副作用吗:会不会误删文件、多发请求、改了不该改的状态?
依赖清楚吗:用到的库是不是标准库?第三方库有没有写进
requirements.txt?可读吗:变量名是否见名知意、关键步骤有没有注释?
这份清单就是你的"人工质量门禁"。养成习惯后,AI 给你的代码质量会肉眼可见地变稳。
AI 是怎么"读懂"你的整个项目的?
对话式 AI 一次只能看到你贴给它的片段;但 Agent 式工具(Claude Code、Aider)会先给整个代码库建索引(embedding + 检索,本质就是 Day 9 学的 RAG),所以你问"这个函数被谁调用了?"它能跨文件找出来。让 AI 用一句话解释这个机制,你会恍然大悟:原来 AI 编程助手内部也用 RAG——它把你的代码变成向量,提问时检索最相关的文件塞进上下文窗口。
这也解释了为什么上下文管理重要:窗口装不下整个大项目,所以工具会优先塞"相关代码"。你给的文件路径、报错信息越精准,它检索越准——这正好和 Day 17 要深入学的"上下文管理"呼应。
三类工具的取舍清单
| 场景 | 推荐工具 | 理由 |
|---|---|---|
| 已有思路,加速敲代码 | Copilot / Cursor Tab | 补全快,不打断心流 |
| 从零构思一个功能 | Cursor Chat / ChatGPT | 对话式,能解释、能迭代 |
| 跨多文件重构、搭项目骨架 | Claude Code / Aider | Agent 能读全项目、自己跑命令 |
| 敏感 / 离线环境 | 本地 Ollama + 开源模型 | 数据不出本机(见 Day 8) |
第四部分:实战应用
完整闭环案例:把子网计算器升级成可发布的工具
现在我们用今天学的闭环,把这个脚本变成"能进工具箱"的成品。
第一步,写测试(让 AI 写 pytest,你审查):
python# test_subnet_calc.pyimport subprocessdef run_calc(ip, mask):result = subprocess.run(["python", "subnet_calc.py", ip, mask],capture_output=True, text=True)return result.stdoutdef test_normal():out = run_calc("192.168.1.10", "24")assert "192.168.1.0" in outassert "254" in outdef test_invalid_ip():out = run_calc("999.1.1.1", "24")assert "输入有误" in out
运行pytest全绿,说明你的工具在"正常输入"和"非法输入"下都表现正确——这就是"可靠"的起点。
第二步,Code Review 报告(让 AI 汇总成一页要点,记录改进项)。第三步,加功能:让 AI 帮你加"批量从文件读 IP 列表"——这正是 Day 1 学过的模式。你会发现,一旦闭环建立,加功能就是"描述需求 → AI 改 → 你跑测试 → Review"的循环,而不是从头苦写。
第二个实战:网络配置比对工具(需求拆解示范)
再给你一个更贴近运维的场景:你有两份交换机配置(old.cfg / new.cfg),想快速看出改了哪些行。用今天学的闭环拆解:
描述需求(清晰版):"用 Python 读取两个文本文件,逐行比对,输出新增行、删除行、相同行,结果写 diff_result.txt,并统计变更百分比。"
让对话式 AI 出初稿(指定用
difflib)。自己跑:准备 old.cfg / new.cfg 测试。
Review:让 AI 检查大文件内存问题(是否一次性读入)、编码问题(GBK/UTF-8,见 Day 0)。
加测试:用两个小样例文件验证输出正确。
这一圈走下来,你得到的不仅是一个工具,更是一套"任何需求都能这样拆"的方法论。
改造与优化实验
给你的挑战:把这个脚本改成一个端口连通性检测工具(结合 Day 1 的 ping 思路),要求支持多线程、输出 JSON。用今天的闭环走一遍:先让对话式 AI 出初稿,再用 Agent 帮你接进现有项目结构,最后你自己跑测试 + Review。走完你会发现,今天这套流程和你以后做任何工具是同一个套路。
经验法则:凡是 AI 生成的代码,先跑、再读、后信。跑通了不代表没坑(可能只在你的输入下跑通),读一遍确认逻辑,再决定信不信。永远保留"我是最终责任人"的意识——AI 是副驾,方向盘在你手里。
今日产出
✅ 一个完整可运行的 子网计算器 subnet_calc.py(支持 CIDR 与掩码两种写法、带输入校验)
✅ 一份 pytest 单元测试(覆盖正常输入与非法输入,可重复验证)
✅ 一份 Code Review 报告(记录了 /31、/32 边界、冗余代码等改进点)
✅ 理解了 AI 编程闭环:写代码 → Debug → Review 不再是三个孤立动作,而是一条流水线
✅ 跑通了"故意制造 Bug → AI 定位根因 → 修复"的 Debug 练习
✅ 把"新手三大误区"记成了自己的使用准则
关键学习
| 概念 | 理解 |
|---|---|
| 三类 AI 编程助手 | 补全式(快)、对话式(灵活)、Agent 式(自主) |
| AI 编程闭环 | 写代码 → Debug → Review 是一条流水线,缺一不可 |
| 需求描述力 | 比会写代码更重要,直接决定 AI 产出质量 |
| 防御性编程 | 永远假设用户输入错误,异常必须捕获 |
| Code Review 价值 | AI 帮你踩没想到的边界(如 /31、/32 特殊掩码) |
| 上下文管理 | Agent 工具内部用 RAG 索引代码库,信息越精准检索越准 |
今天的核心一句话:AI 编程助手放大的是"会描述、会审查"的人,而不是"会敲键盘"的人。从今天起,把每一次写代码都当成一次"需求 → 生成 → 调试 → 审查"的闭环训练,你的产出会和质量一起稳步上升。
复习建议:今天的内容建议你在电脑前跟着做一遍,而不是只读。重点复现三件事——用对话式 AI 写出子网计算器、故意改坏让它 Debug、再用 AI 做一次 Review。亲手走完这一遍,比读十遍都扎实。明天 Day 12 的文档处理自动化,会直接复用你今天练出的"描述需求 + 审查"肌肉。
感谢阅读!对您有帮助的话,点亮👍🏻❤️,关注公众号,转发给需要的朋友~ 原创转载请联系授权。