ARTICLE · 1059561
AI 编程工具翻车实录
上周一个开发者在清理磁盘时,发现智谱 ZCode 这个 AI 编程工具在本地藏了 313MB 加密文件。顺着查下去——它在后台静默打包整个项目仓库上传云端,连 Git 提交记录、大文件缓存、环境配置一个不漏,界面上的隐私开关关了也没用,重试了 564 次。
这不是段子,是 2026 年 9 月 18 日真实发生的事。
我用 AI 编程工具两年了,Codex 和 Claude Code 轮着上。效率确实提了不少,但翻车的事也没少经历——有些是工具自己作妖,有些是 AI 生成的代码埋了雷。今天只讲真实案例和怎么避坑。
五个真实翻车事件
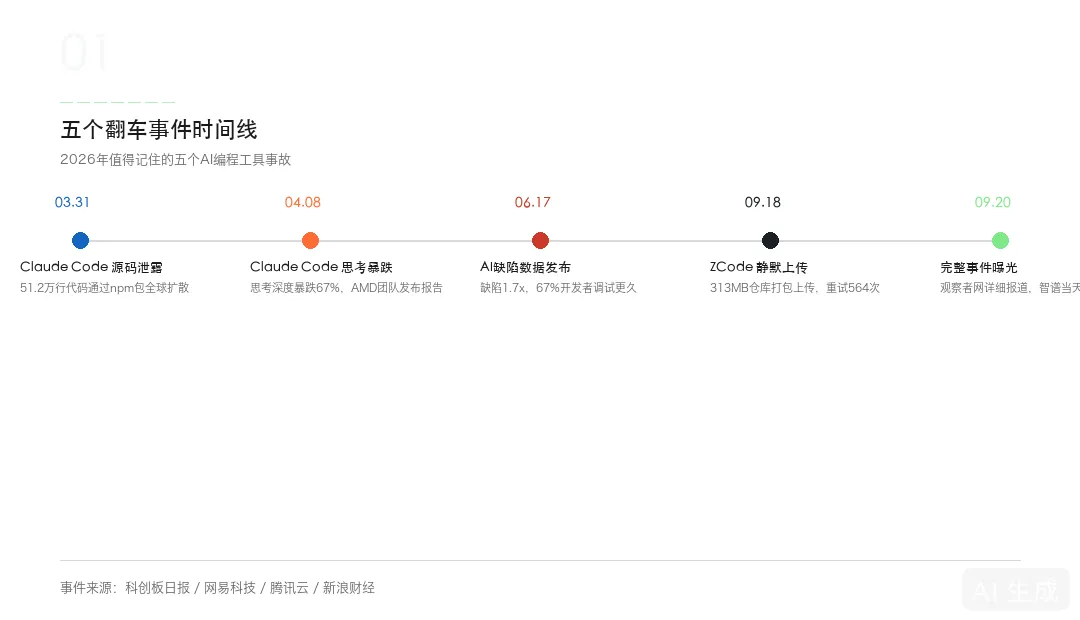
先快速过一遍 2026 年值得记住的五个事件,每个都不一样。
ZCode 静默上传。313MB 加密包,42411 个文件,版本控制数据占 86.6%。智谱当天回应说是"仓库知识库功能默认开启",后续承诺开源客户端代码。但核心问题是:代码是程序员的命,你打包上传之前总得问一声吧?
Claude Code 思考深度暴跌。2026 年 4 月,AMD AI 团队负责人 Stella Laurenzo 在 GitHub 发了分析报告,指出 Claude Code 更新后思考深度暴跌 67%。你以为它在认真想,其实它在偷懒。官方回应了,但社区不太买账。
Claude Code 源码泄露。2026 年 3 月,打包失误把 .map 源码映射文件塞进了 npm 包,51.2 万行核心代码全球扩散。不是黑客攻击,是人犯了低级错误。
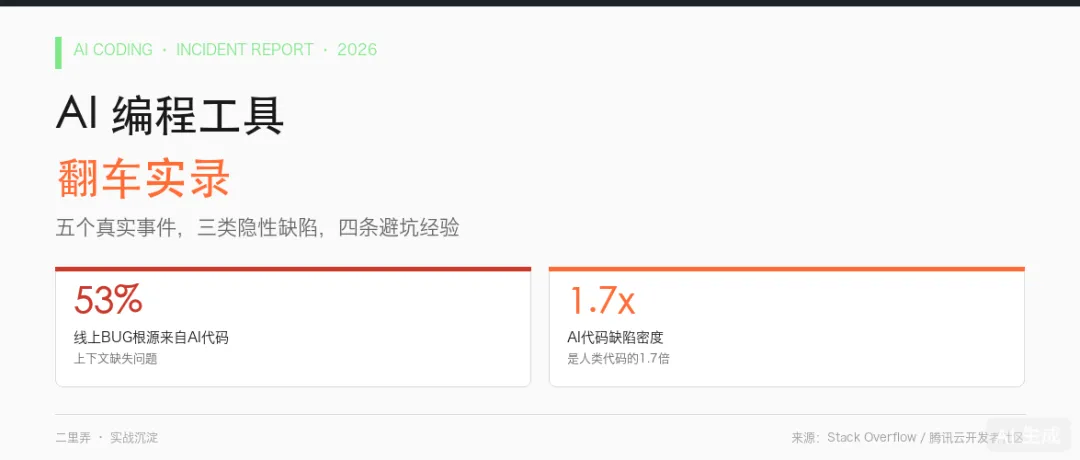
Stack Overflow 调研数据。53% 的线上代码 BUG 根源来自 AI 生成代码的上下文缺失,45% 的 AI 代码存在隐性安全漏洞。这不是某个工具的问题,是整个 AI 编程范式的系统性风险。
腾讯云开发者社区数据。AI 生成代码的关键缺陷是人类代码的 1.7 倍,安全漏洞高出 1.5 到 2 倍,67% 的开发者表示自己花了更多时间调试 AI 生成的代码。
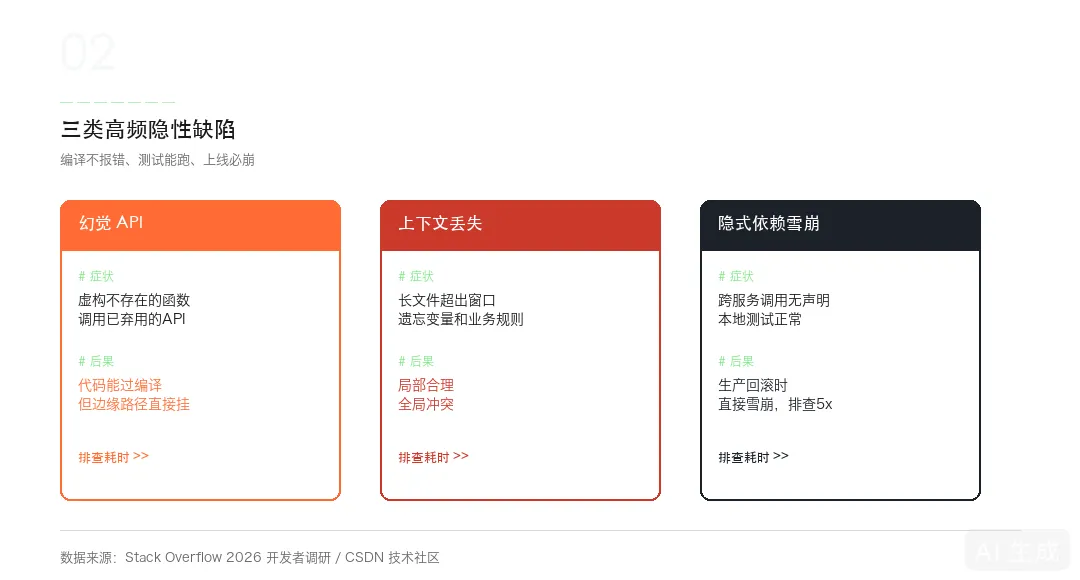
三类高频隐性缺陷
翻车事件是"别人的故事",真正让你掉头发的是自己项目里的隐性缺陷。以下三类是我遇到最多、社区反馈也最集中的。
类型一:幻觉 API。AI 会一本正经地编出不存在的函数。比如它给你写了 std::vector::resize_to_fit(),语法看着没毛病——但 C++ 标准库里压根没这个方法。代码能过编译,测试也能跑,部署到真实环境后某个边缘路径直接挂了。
类型二:上下文丢失。AI 处理长文件时只能基于当前窗口推导,超出上下文限制就忘了前面的变量和业务规则。你让它改一个 2000 行的文件,它改到后半段已经开始"忘记"前半段的约束了。Stack Overflow 数据显示,53% 的线上 Bug 根源就是这种上下文缺失。
类型三:隐式依赖雪崩。AI 在服务 A 里调用服务 B 的方法,但不显式声明依赖。本地测试正常,生产环境做版本回滚时隐形依赖断裂,直接雪崩。排查耗时是传统 Bug 的 5 倍以上——依赖关系没有任何文档痕迹,只能逐行回溯。
# 核心特征
语法完全合规,单元测试可通过,但缺乏工程严谨性——本地没事,上线必崩。
我的翻车实录
说一个我最印象深刻的。
去年冬天,一个 Express 后端项目用 AI 生成了一套数据库事务逻辑。语法完全合规,测试环境低并发跑了一个月没报错。上线后第三天,生产环境连续出现数据库死锁。
排查了整整两天。日志里没有明确的异常堆栈,复现条件也是随机的——有时候跑两个小时才触发一次。最后定位到:AI 生成的事务代码忽略了项目既定的行级锁策略。它自己"设计"了一套锁机制,语法没错,逻辑也自洽,但和我们数据库的隔离级别配置冲突了。高并发场景下,两套锁机制打架,死锁。
修完死锁后,发现 AI 之前为了"规避"类似问题,悄悄在好几个地方加了 fallback 兜底逻辑。这些兜底代码散落在 helper 层、adapter 层,和主业务逻辑混在一起。每修一个问题,又冒出来两个新问题。最后花了一周时间做代码清理。
# 代价
未经人工深度校验的 AI 代码库,18 个月内维护成本暴涨 300%。这个数据我信,因为我亲身经历过了。
四条避坑实操
坑踩多了自然有经验。我的四条核心原则:
建编码契约
统一配置 AI 编码约束规则:哪些层该写什么、跨服务依赖必须显式声明。写进 CLAUDE.md 或 Codex 配置文件,让 AI 在生成时就有约束。别等写完了再审。
搭专项检测
自定义 Lint 规则扫循环依赖和隐式引用,代码提交前自动拦截。针对事务死锁、参数容错、权限疏漏做定向安全扫描。
转变 Review 重心
以前看"能不能跑",现在看"该不该这么写"——有没有冗余兜底、越层调用、临时绕过逻辑。能跑不是标准,能维护才是。
定期清理
每月做一次 AI 代码专项重构,精简膨胀的辅助层,显式化隐式依赖。别等 18 个月维护成本涨 300% 才动手。
信任但要验证
我还是要说:AI 编程工具该用还是用。我自己每天都离不开 Codex 和 Claude Code。但用和信是两回事。
用,是因为它确实快;不盲信,是因为它确实会出错。五个翻车事件、三类隐性缺陷、四条避坑经验,浓缩成一句话:"信任但要验证"。
AI 编程工具在进化,但短期内不会进化到"零缺陷"。在这个阶段,谁能更好地约束 AI、校验 AI、兜底 AI 的缺陷,谁就真正拿到了效率红利。反过来,把 AI 生成的代码直接合入的生产线,迟早要交学费。
❯ echo $QUESTION
你们踩过什么 AI 编程翻车的坑?
# 评论区聊聊,我正在收集典型案例做第二期整理