ARTICLE · 1061241
会聊天的 AI 干不了活? 你可能缺了 ReAct
帮我查一下三家竞品的近期表现,整理成一份带结论的对比报告。
但面对这个任务,它大概率会卡住——它既不真的去"查数据",也没法真的"把三家的结论对比出来"。它只是在凭记忆编,编得越流畅,你越难分辨真假。
——这可能是过去两年里,很多人对生成式 AI 最大的失望:它很会"想",却很少真的"做"。
而让 AI 从"会想"跨到"会做"的那一步,核心就藏在一个叫 ReAct 的词里。
ReAct是什么:Reason + Act
ReAct 是 Reasoning(推理)和 Acting(行动)的合体。
它的核心信条只有一句:让模型边想边做,用真实世界的反馈来修正自己的推理。
听起来平平无奇,但却是三次思维范式变迁的产物。
先来看看每种范式之间的差距:
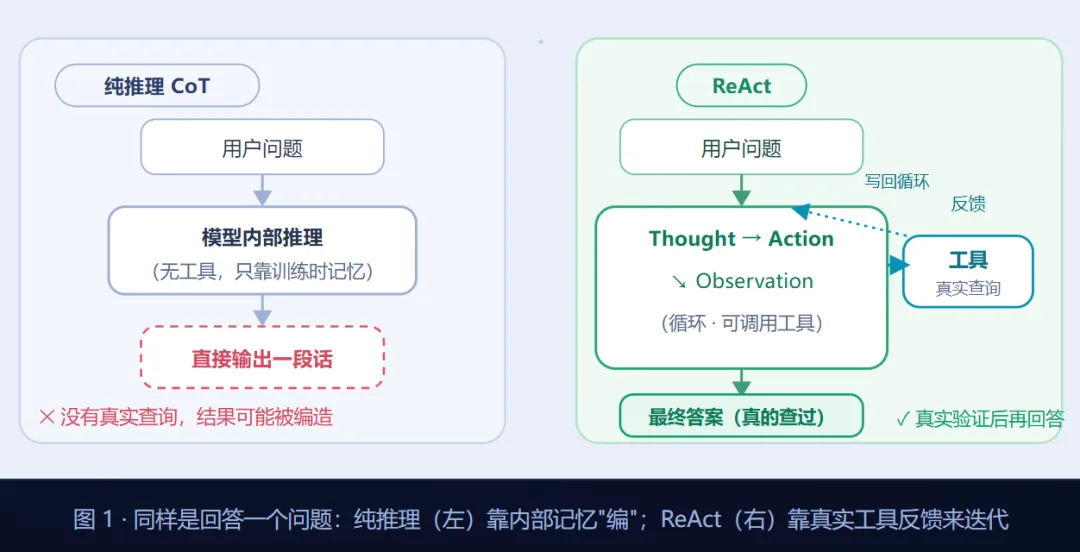
同样是回答一个问题,纯推理靠内部记忆编,ReAct 靠真实工具反馈来迭代。
两者的差别,可以用"点外卖"来类比。
纯推理模式的模型,像是一个不看菜单、只凭记忆回答"这家好不好吃"的人;
而 ReAct 会先想吃什么 → 真的打开 App 查 → 看评价 → 再决定。
区别不在"谁更聪明",而在于它有没有被允许调用真实世界里的工具。
核心循环:「想—做—看」
把"点外卖"翻译成机器的语言,ReAct 就是一个「想—做—看」三拍子的循环。这几乎是所有 Agent 架构的公共底座:
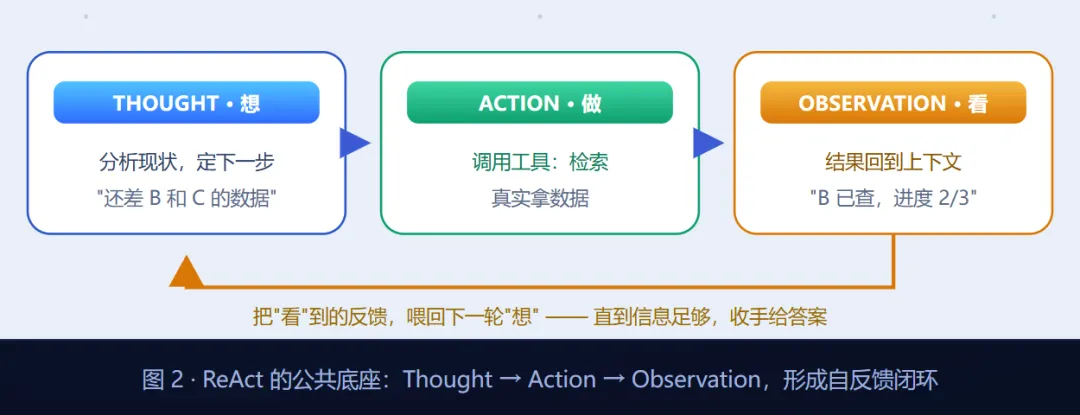
回到竞品报告的例子,把这段循环走一遍:
1 「想」Thought:我要出报告,得先拿到三家数据——按顺序查 A、B、C。
2 「做」Action:调用"检索工具",真的去数据里查 A 公司的信息。
3 「看」Observation:工具返回 A 的真实数据,写入上下文。
然后,再想一遍:
"进度 1/3,还差 B 和 C",于是再做、再看。直到三家齐了,它判断信息已充分,才切换动作给出最终答案,收工。
关键不在于它"一步到位",而在于它自动掌握了:
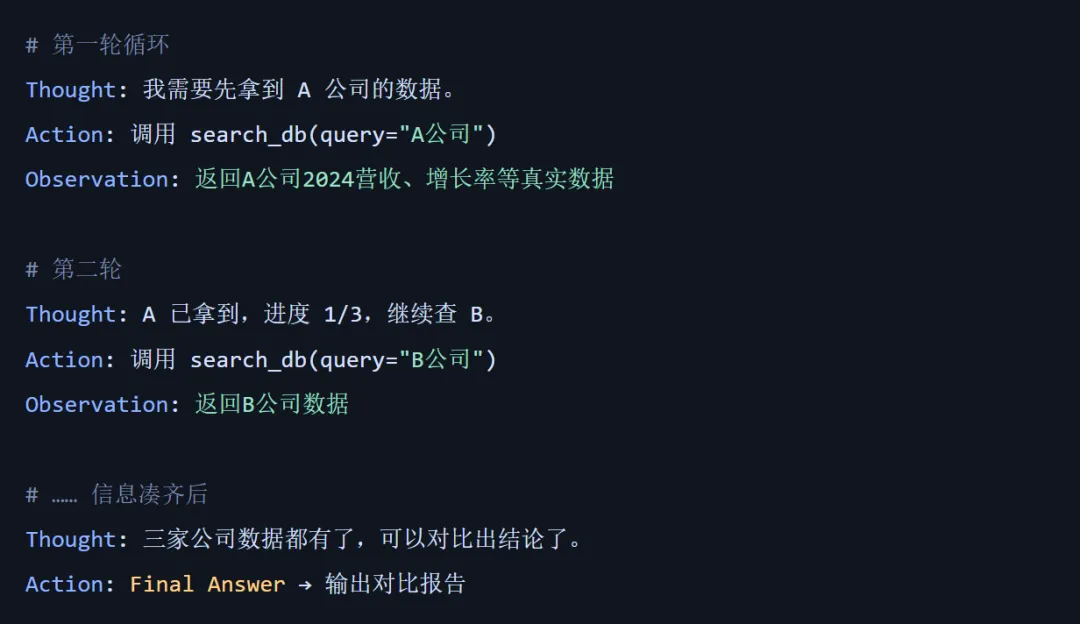
一次完整的执行轨迹
如果把它每一轮的"内心活动"拉出来看(这也是平台上可观测到的那一层),大致是这样一段不断增长的过程:
工程化系统:循环变机器
如果以为 ReAct 只是"一个高级提示词技巧",就低估它了。
在真实平台里,它是一套被工程化的系统。至少包含下面这些基础设施。
工程上,平台不会让模型在对话里自由发挥,而是把推理和工具执行拆成两个可独立调度、可中断、可观测的结点,再用一张执行图串起来,配一个 should_continue 类的判断分支:
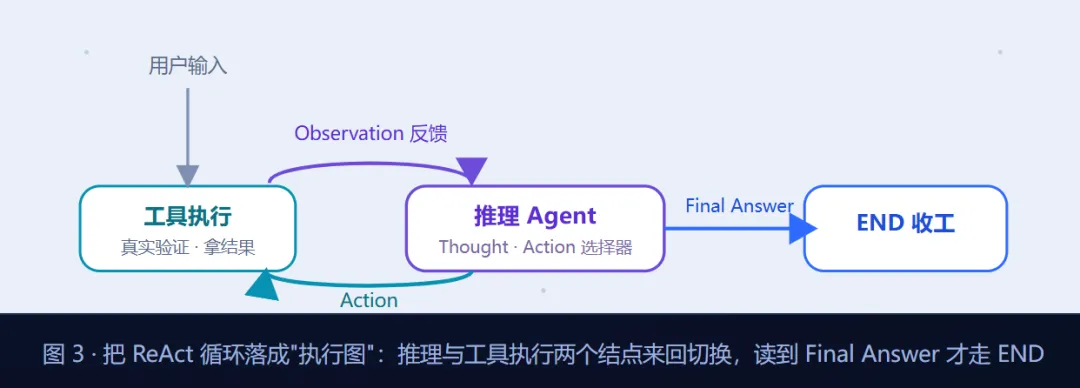
这种"图"的好处是每一步都可回放:它想了什么、调了哪个工具、拿到什么结果、在第几步收手,全部留痕。
出了问题,回放轨迹就能定位——这就是工业级与 demo 级的差别。
模型凭什么知道"该调这个工具而不是那个"?靠的是平台为每个工具写的描述(description)+ 参数结构(schema)。
描述写得越清楚,模型越不容易用错:
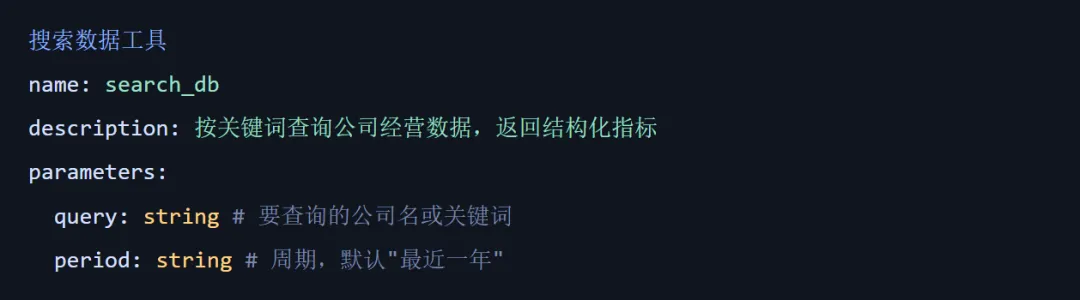
甚至可以在描述里写明"当用户想要 XX 时就调用我"。工具描述本身,就是调节 Agent 行为的关键旋钮。
这也是为什么好的平台都强调"工具即能力、描述即策略"。
前面说过纯推理会"凭空编"。要让它"查真实资料",经典做法是把文档切碎、转成向量存进向量库,查询时做相似度召回(Retrieval),再把命中片段喂给模型去生成(Generation)。这一套即缩写为 RAG。
ReAct 的一个 Action,很多时候就是在触发这种检索。
另一种路线:Function Calling
现在很多平台聊 Agent,除了 ReAct,还会提到 Function Calling(也叫 tool-calling)。
它们是两种让模型"调用工具"的技术路线,各有取舍。
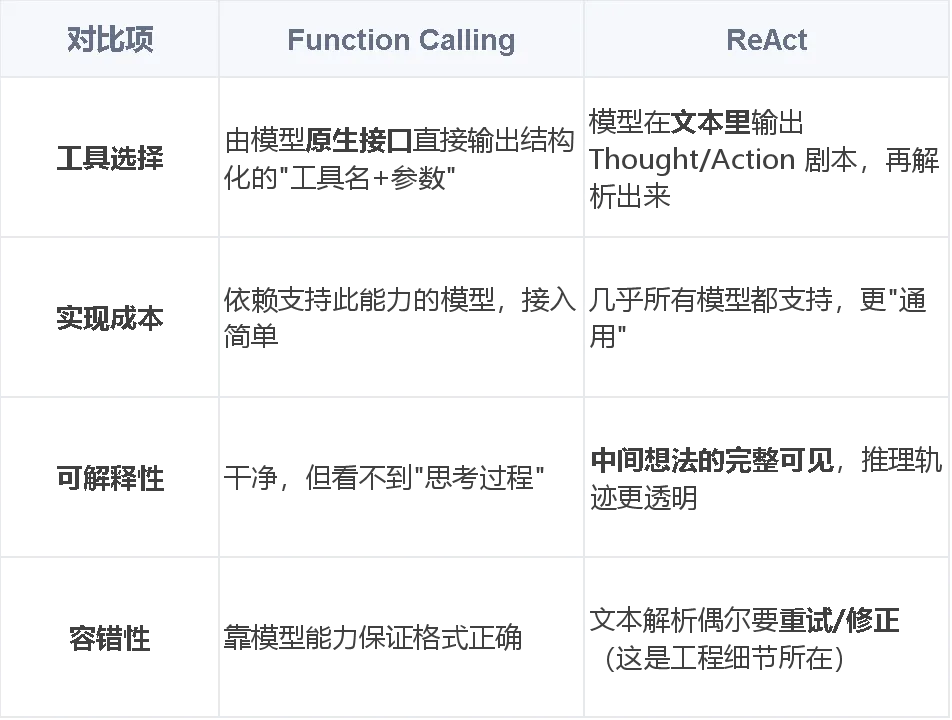
成熟平台的做法常常是两者可切换:同一个 Agent,既可以用 Function Calling,也可以切到 ReAct。用一个配置项就能选"大脑的工作方式"。这对落地场景很实用:追求干净结构选前者,需要可见推理过程选后者。
落地的五道挑战
讲到这里,可能有人想:"不就是循环吗,直接写提示词让它转起来不就行了?"
真上手立刻会撞到五堵墙——而这五堵墙,恰恰是平台工程价值的全部所在。
模型容易在某个问题上反复打转。平台强制设最大执行步数,到点上限就离开循环去收尾,避免空转烧钱、超时。
循环越长上下文越膨胀,模型越早失忆。平台在上下文超阈值时自动压缩摘要,让任务做到最后仍记得初衷。
工具一多,模型可能乱调。平台会在调用前要求模型自述调用理由,让每一步决策可解释、可追责。
工具会失败、会超时。平台内置错误捕获与重试,把"调用失败"转换成一条可读的反馈,喂回模型继续想办法。
高风险动作要人把关。平台让循环暂停 → 等人工确认 → 再继续,机器能办事,关键处由人拍板。
ReAct 要落地到"放心用",难点不在"转发一次工具调用",而在这些看不见的护栏里。它把"能跑"变成"能可靠地跑"。
复杂需求:任务拆分
单靠上文的循环,一次只能踏踏实实回答“一个问题”。
但真实需求往往是复合的,比如“做一份三家竞品对比报告”,背后藏着查资料、逐个分析、横向对比、按模板成稿等好几步。
若把这一整件事直接丢进一次循环,模型的思路会在上下文里越滚越乱、顾此失彼。
所以平台在调度层多做了一件关键的事:任务拆分(Task Decomposition)。
先把大需求拆成一组边界清晰的子任务,再判断它们的先后与并行关系,派发给对应角色执行,最后把各步结果汇总成一份交付。规划器就是其中的“总装车间”:
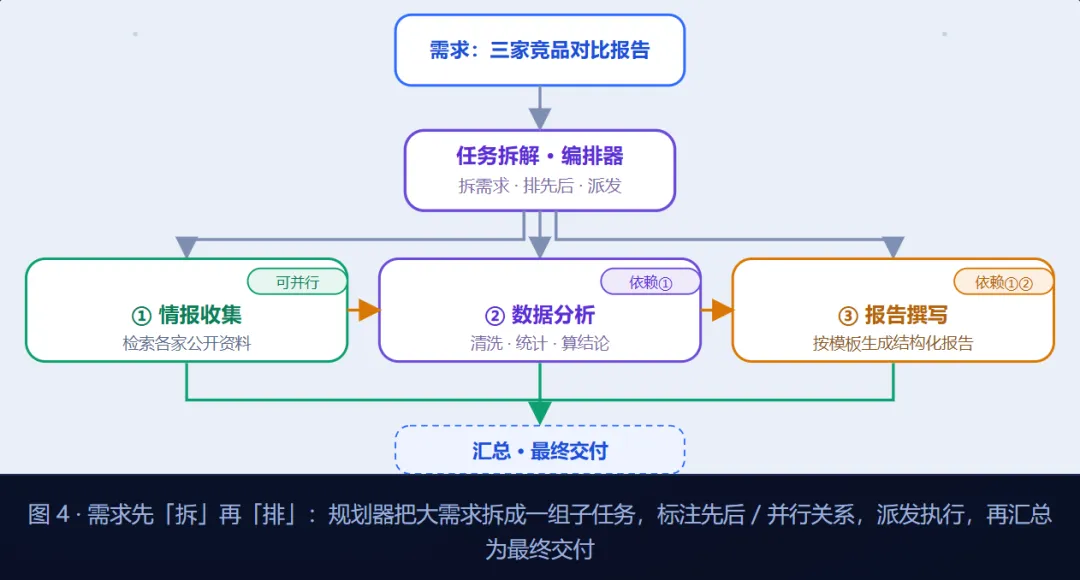
注意每个子任务框里:跑的都是前面讲的「想—做—看」循环。
这里的分工很清晰:
任务拆解负责“组织”任务,ReAct 负责“执行”单个任务。
两层配合,才能既做大又做稳;一旦哪个角色失败或超时,也能在拆解层单独重试,不必整条链重来。
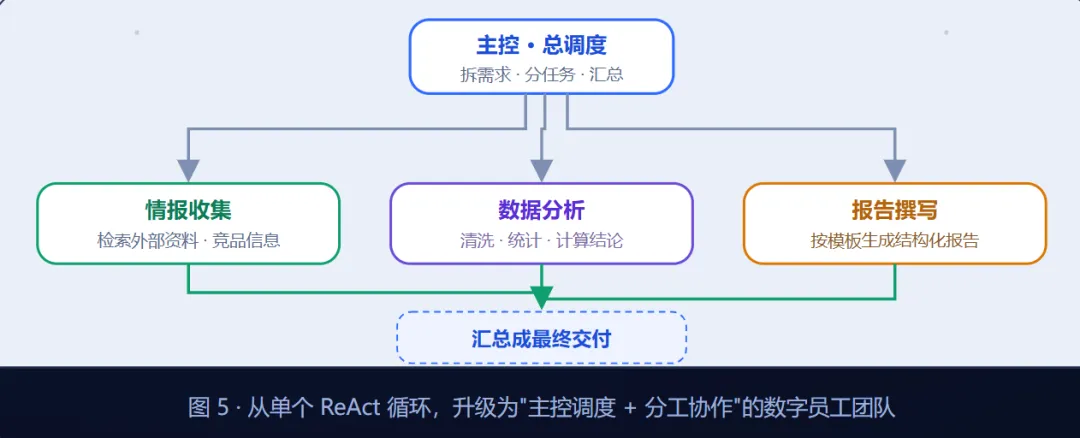
数字员工团队
再往上走一步。
单个任务的循环跑通只是起点,真正的平台级能力是把它变成可编排、可复用、可协同的组织单元。想象这样的执行图:
ReAct 的原理,一页纸就讲得完。
难的是让它在真实业务里稳定、安全、可解释地循环上千次,
不跑偏、不失忆、不失控。
这正是平台的价值所在:与其自己从零去搭一套"会卡死、会忘词、不可管"的循环,不如把循环的护栏、上下文管理、工具编排与审批,交给一个把基础能力认真打磨过的平台。
下一次,当你需要的不再是一个会聊天的模型,而是一个会办事、且靠得住的数字员工,不妨先问一句:它有没有一套真正的「想—做—看」循环?背后有没有靠谱的工程在托底?
Thought(想)→ Action(做)→ Observation(看),循环往复,
直到信息足够,给出最终答案。
让 AI 从"会想",变成"会做"。
