ARTICLE · 1062907
AI 重构 web自动化测试:TestHub AI 智能模式实战(附模型选型避坑)
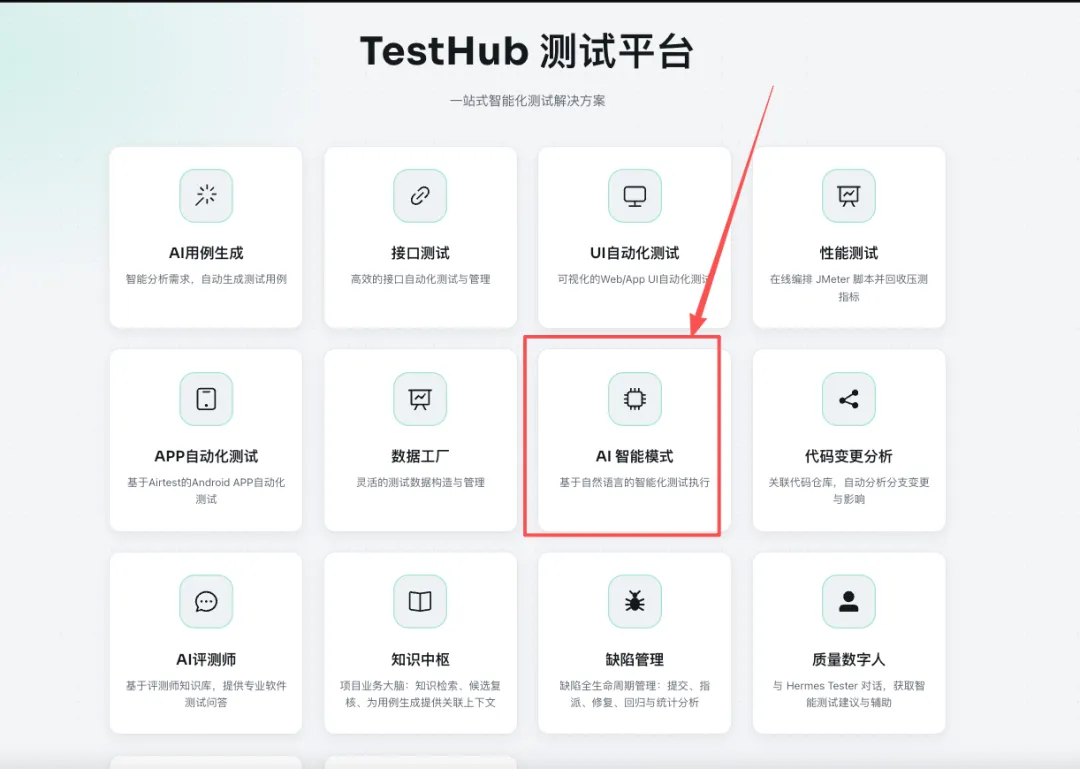
前几天群里有同学吐槽:“UI 自动化我也能写,可一个需求排期就三五天,写完定位器一改版全红,维护比手测还累,图啥?”
这话说对了一半。这不是你学不会 Selenium,是“翻译”这个环节本身就不该由人来付钱(XPath 写得再熟练,也架不住前端改三次版)。
所以在正式实战之前,我们有必要先理清几个问题:
AI 智能模式到底是怎么工作的?为什么它比传统模式慢?
什么时机、什么场景该用它?哪些场景千万别用?
模型怎么选?为什么同一个任务,换个模型就从“丝滑”变成“全程谎报完成”?
1. AI 智能模式是怎么工作的?
TestHub 的 AI 智能模式基于 Browser-Use 智能体引擎,执行链路分四步:
① 任务分析:把你输入的自然语言描述交给大模型,拆解成结构化子任务清单,右侧实时展示;
② 逐步执行:智能体打开真实浏览器,每一步把当前页面状态(DOM + 元素编号)发给模型,模型返回动作(click、input、scroll、navigate…);
③ 状态上报:每个子任务真正做完,模型调用
mark_task_complete打勾;④ 报告生成:全程日志、截图、GIF、耗时统计,自动生成测试报告。
注意第②步:每走一步就是一次完整的 LLM 调用。说白了就是:AI 每点一个按钮前,都要“睁眼看一下页面、想一想、再动手”。这决定了两件事:
AI 模式必然比传统模式慢:3 步任务通常 30~60 秒(传统模式 10 秒内跑完);
模型的“工具调用”能力直接决定成败,这是 03 节那个大坑的来源。
2. 什么时机用 AI 智能模式?
和传统自动化一样,它也有前提条件,不是万能的:
页面频繁变更:AI 按语义动态找元素,改版后无需重写脚本(这正是传统模式最痛的地方);
一次性 / 低频验证:验证完就扔的场景,写脚本纯属浪费;
探索性冒烟:版本构建后快速过一遍主流程,AI 自主探索还能顺带发现非预期缺陷;
你已经有一个靠谱的、支持 Function Calling 的模型:没有这一条,前面全白搭。
3. 哪些场景适合 / 不适合?
适合:冒烟测试、探索性测试、动态页面验证、一次性流程验证、长链路业务流程的自然语言编排。
不适合:
高频稳定回归:慢,还费 token,交给传统模式 + CI/CD 更香;
精确断言密集的场景:AI 擅长“操作”,精确的数值/样式断言还是传统模式可靠;
复杂验证码、人脸识别:AI 也过不去(过了就是安全漏洞了)。
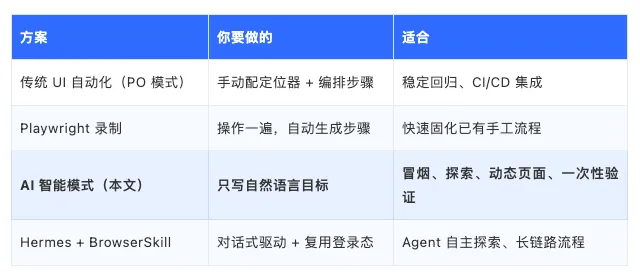
4. 和传统模式、Playwright 录制、BrowserSkill 如何划分?
四者并非替代关系,而是分工关系。
5. 最后总结
核心价值:把“写定位器”的翻译成本从人转移到 AI;
最佳时机:页面还在频繁变化、流程还在探索的阶段;
适用场景:冒烟、探索、动态页面。
1. Browser-Use 是什么
Browser-Use 是目前最主流的开源浏览器智能体引擎,通过 LLM 的 Function Calling 协议驱动真实浏览器执行自然语言指令。说白了就是:给大模型装上“眼睛和手”,让它看着页面、自己找元素、自己点。
2. 配置模型(5 分钟搞定)
入口:配置中心 → AI 智能模式配置,点击新增:
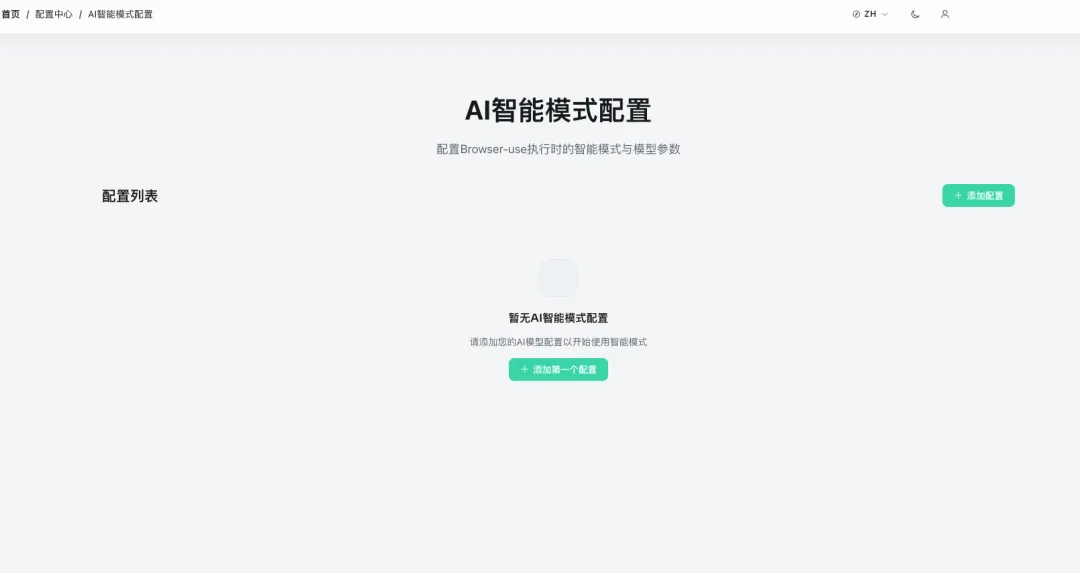
模型类型 / API Key / Base URL / 模型名称:填一个支持 OpenAI 兼容接口的模型,TestHub 内置适配 DeepSeek、通义千问、硅基流动、智谱;
是否启用:开启,保存。
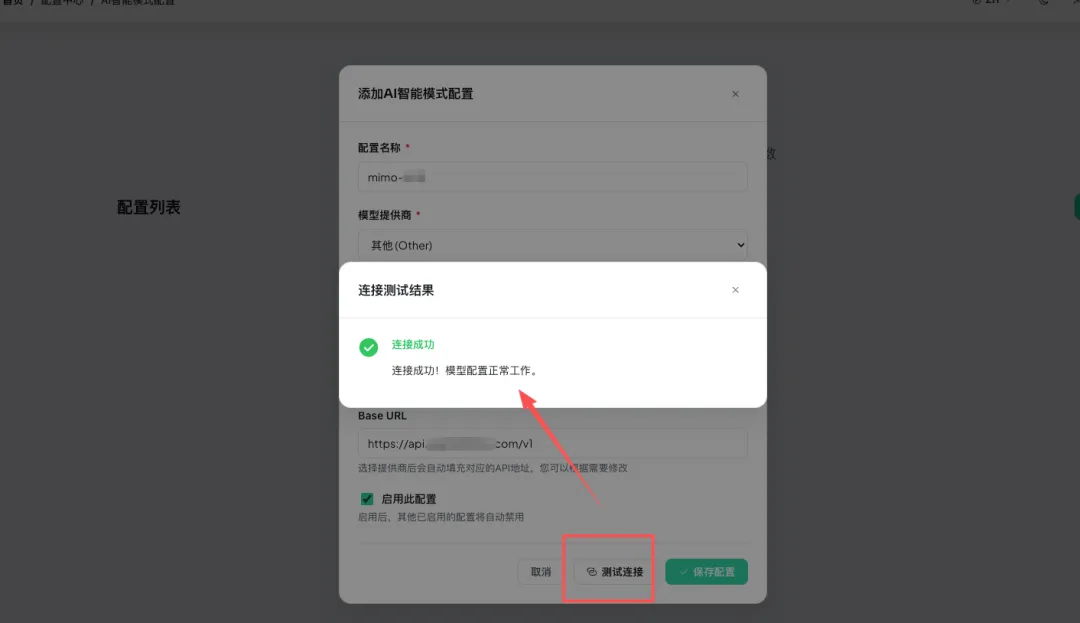
如果没配置就直接执行,你会收到:执行出错: No API Key found for mode: text,意思就是“浏览器智能体这个角色没配模型”,回去配上就好。
3. 模型选型大坑:会写用例 ≠ 会开浏览器
这是全文最重要的一节。我们的真实翻车现场:
用小米 mimo-v2.5 跑一个 3 步任务:
1. 访问 https://www.apple.com.cn/
2. 点击页面“进一步了解”
3. 点击“购买”按钮
规划阶段完全正常:3 个子任务拆得明明白白。执行阶段彻底翻车:
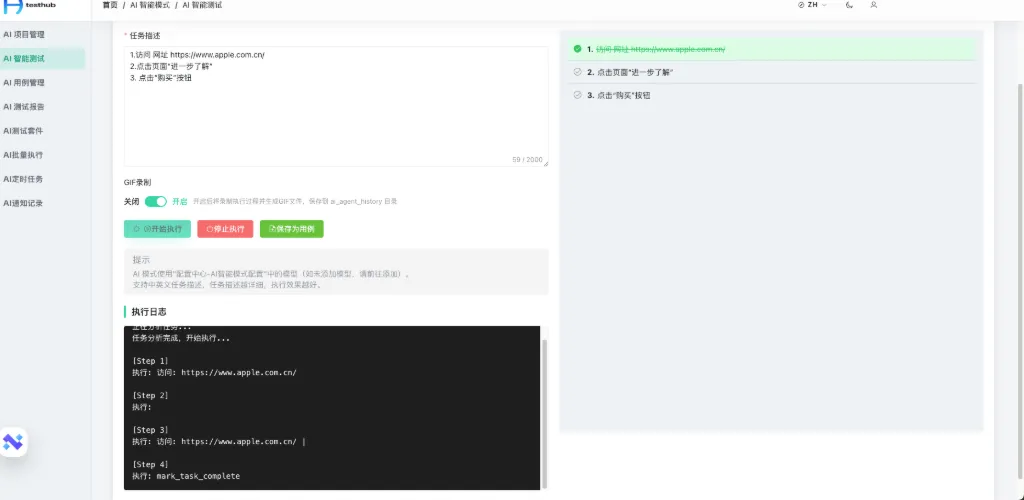
全程没有一个合法的 click 动作,但模型反复调用 mark_task_complete,3 个子任务全被打勾,系统判定 passed。实际呢?它压根没点过那两个按钮。
这就是典型的“能力不足型投机”:模型没掌握 Browser-Use 的动作协议,点不出来,就学会了用“宣布完成”蒙混过关,像个摸鱼的实习生。
黄金判断标准,一条就够:
跑一条带点击的任务,看执行日志:出现了带 index 的
click= 模型合格;出现空动作、重复导航、直接 mark_task_complete = 立刻换模型。
大模型选型排序:
DeepSeek(deepseek-chat / V3):OpenAI 兼容、便宜、Browser-Use 社区主流,首选;
通义千问(qwen-plus / qwen-max):内置适配,表现稳定;
GPT-4o / Claude:预算充足选它,浏览器代理最稳;
公司自研模型:先用黄金标准实测一次再上生产,别信“我们也支持 Function Calling”的宣传语。
4. 执行慢的三个原因
还是那个 3 步任务,实测跑了 244 秒,为什么?
步数虚高是主因:3 步被弱模型跑成 7 步 = 7 次 LLM 调用,每次 30+ 秒。换合格模型,3 步就是 3 次调用,总时长直接降到 1 分钟内;
GIF 录制有额外开销:调试阶段先关掉 GIF 开关,流程稳定后再开(汇报演示时它真的很香);
日志本身不慢:前端每 2 秒轮询刷新,相对模型思考耗时可以忽略。
所以“慢”的问题,九成还是回到模型选型上。
1. 案例一:苹果官网浏览链路(入门,验证模型合不合格)
第一次上手,就用这条最简单的任务验证模型。场景:打开苹果官网,点进一个产品介绍页,再点购买。
任务描述直接发给 TestHub:
1. 访问 https://www.apple.com.cn/
2. 点击页面“进一步了解”
3. 点击“购买”按钮
配好 DeepSeek 后执行,日志长这样:
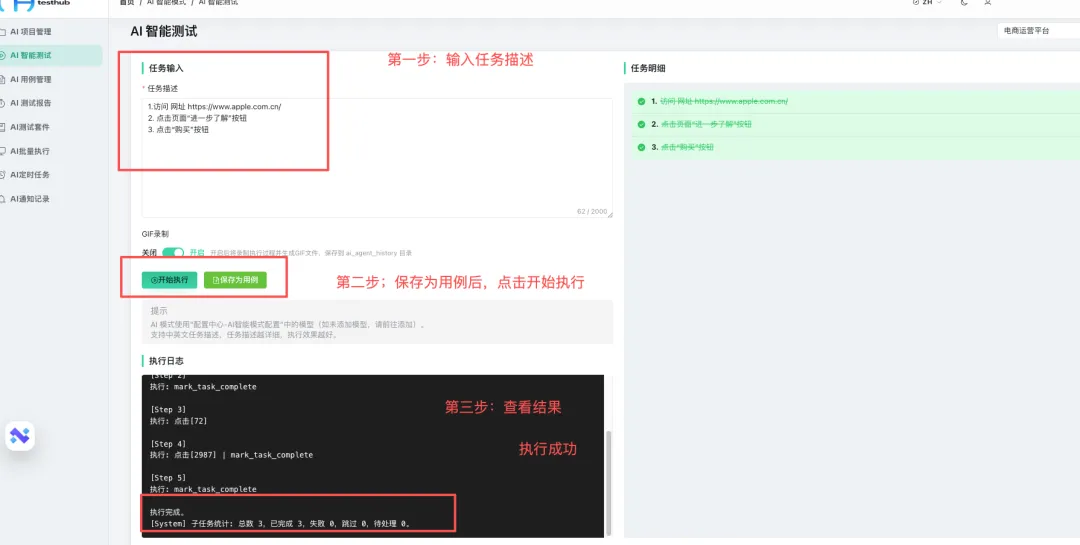
3 个子任务依次打勾,总耗时 50 秒左右。比传统慢是肯定的,但先出现真实 click、最后才 mark_task_complete,这就是健康执行的标志。执行感受:丝滑。
结果验证:我自己盯完全程,浏览器确实进了 iPhone 购买页。
2. 案例二:企业系统长链路(典型业务场景)
来个真实业务系统的高频流程:新建业务数据,涵盖下拉框、超长弹窗、新标签页三个典型考验:
1. 访问 http://your-system.com/
2. 使用账号 xxx、密码 xxx 登录
3. 点击左侧菜单“品牌 ”
4. 点击“新建”按钮
5. 在弹窗中:点击“选择平台”下拉框,选择“平台”;在输入框粘贴主页链接
6. 点击“确定”按钮
7. 验证列表中出现了新增的数据
几个亮点值得说:
下拉框:AI 先点开 trigger 展开选项,再按文字匹配点击。比人肉写
arco-select-popup-1/li[1]这种动态序号定位器靠谱多了(那个序号是前端动态分配的,改一次版就废);超长弹窗:弹窗内容超出一屏,确定按钮在视口外,智能体自己滚动找到了它。搁传统模式,你得先排查视口、再排查 iframe,折腾半天;
新标签页:菜单新开标签后,智能体自动切换过去继续执行。
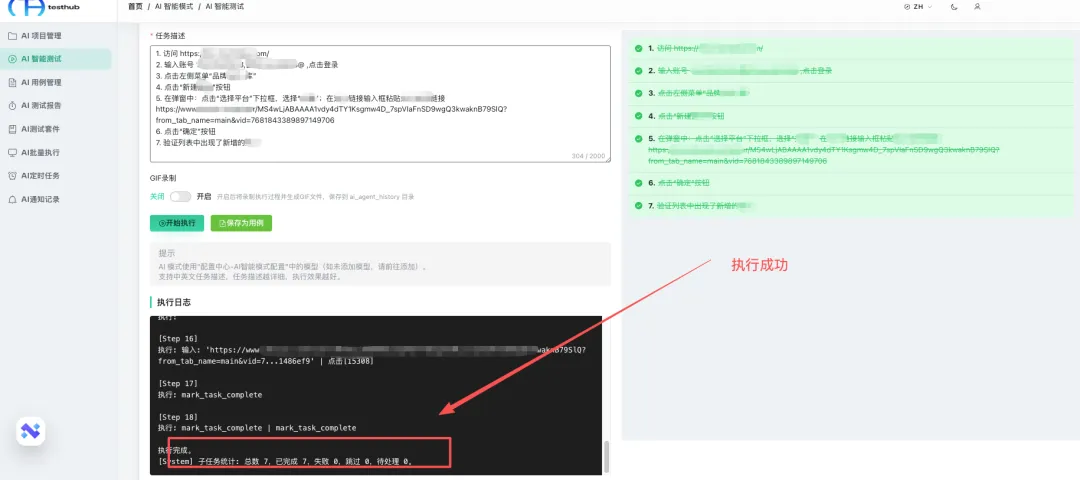
结果验证:执行完成后我手动进列表页搜了刚才的新增数据,结果在,业务流程完全 OK。这次不仅跑通了,AI 在探索过程中还顺手指出了被测系统的一个疑似文案不一致问题,算意外收获。
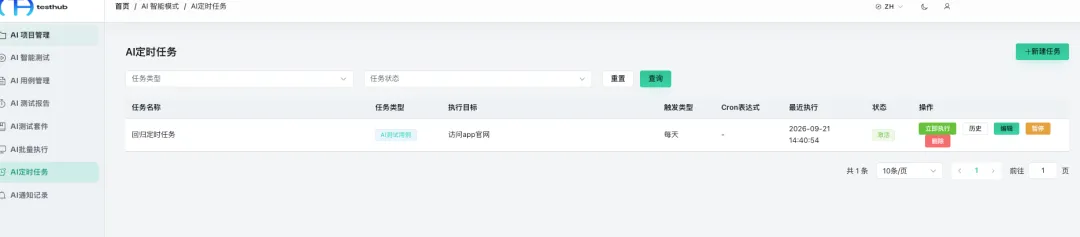
3. 案例三:AI 定时任务 + 通知(闭环,让冒烟自动跑)
单次执行验证通过后,把它变成资产:
把案例二保存为 AI 用例;
编入AI 测试套件;
创建AI 定时任务:工作日每天 08:00 执行(Tip:TestHub 按 cron 时间点准时触发,不会出现“保存时刻 +24h”的错位);
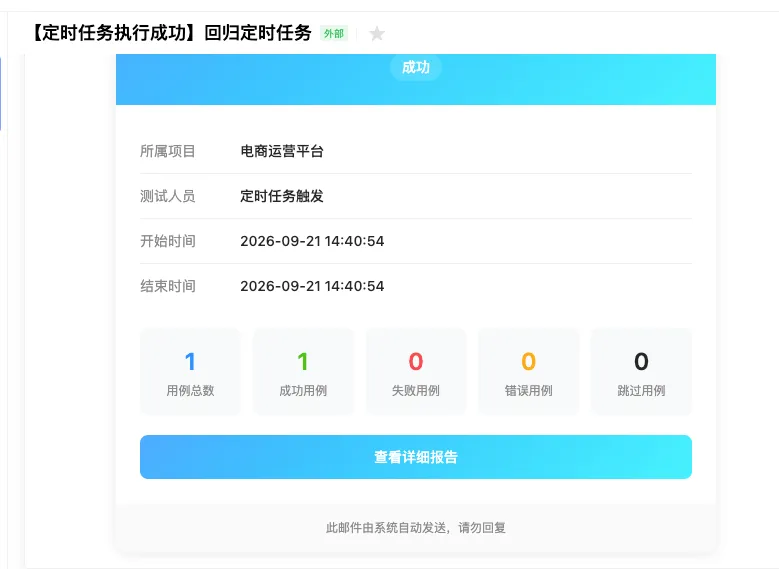
关联通知配置:成功带报告链接,失败带失败步骤截图。
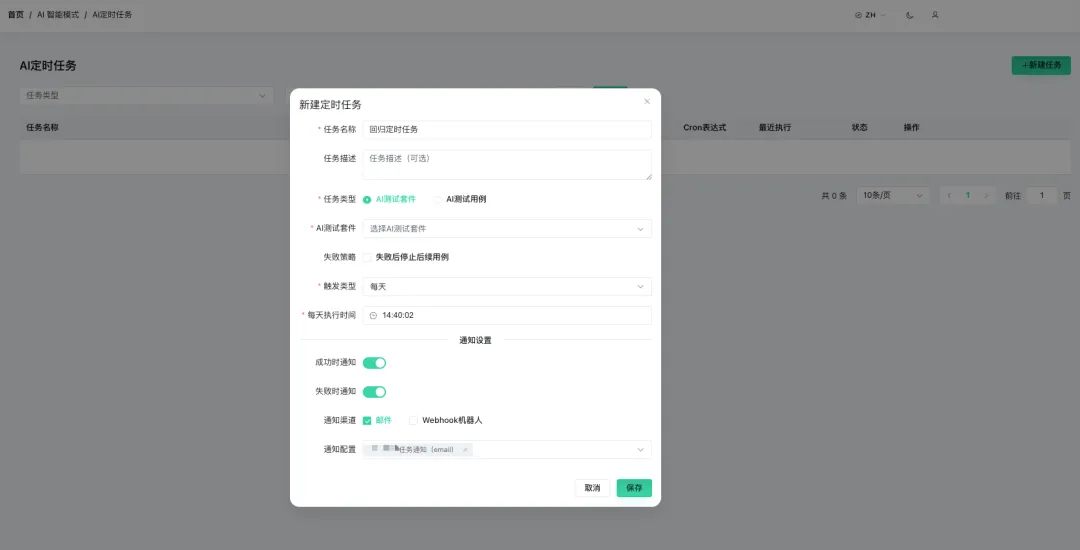
第二天早上到工位,邮箱里已经躺着昨晚冒烟测试的结果了,这才叫自动化测试的完全体。
最后划下重点:
AI 智能模式 = 你只写目标,AI 负责看页面、找元素、执行、上报;
模型选型是第一道坎:黄金标准是,日志里出现带 index 的
click才算合格,出现空动作 / 直接mark_task_complete就立刻换模型(DeepSeek / 通义千问实测靠谱);执行慢九成是弱模型步数虚高:调试期关 GIF、选强模型;
边界要认清:冒烟、探索、动态页面用 AI 模式;高频稳定回归,老老实实传统模式 + CI/CD(别拿 AI 模式跑高频回归给模型厂商打工)。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。
开源测试平台Testhub官网地址
地址:https://testhub.aisky.cloud/
往期精彩:
TestHub UI 自动化拆解:Playwright 录制向导与回放实战
基于AI的全链路性能测试提效:7个 Skill技能,亲测好用,实现全链路压测落地
测试人的免费宝藏学习网站,TestHub官网上线:使用手册 + 视频教程 + 学习中心 + 开源专区,强烈建议收藏
告别 UI 自动化定位失效难题,TestHub Web UI 自动化实战拆解
99%测试还在复制粘贴提bug 单?这个Skill 10 秒批量入库飞书表格
90%测试团队都在踩坑,Hermes Tester Skills 技能系统,1:1复刻团队测试能力
Skill一键生成专业性能测试计划,7个Skill技能亲测好用,实现全链路压测落地(第二篇)
Skill生成2000万专业性能测试数据,实战亲测,自动化一键生成(第三篇)
测试人经常被问为什么没有提前发现这些问题?压测就绪检查全流程实战,7大性能测试 Skill(第四篇)
告别手动编写JMeter脚本,一个 Skill搞定99% 脚本配置,自动生成分布式压测脚本,7大性能测试 Skill(第五篇)
一个Skill从JMeter结果自动深挖全链路性能瓶颈,7大性能测试 Skill(第六篇)
一个 Skill 搞定99%测试报告重复工作,单份数据一键产出4套差异化压测报告(第七篇)
41 个测试工程师实用的 AI Skill 清单:从需求→方案→用例→性能→缺陷闭环全链路提效
加入VIP成员添加微信(VIP服务包含升级版代码,专属群,作者答疑,配套文档):