ARTICLE · 1065357
01. AI 与大模型基础 | Agentic AI
01. AI 与大模型基础 | Agentic AI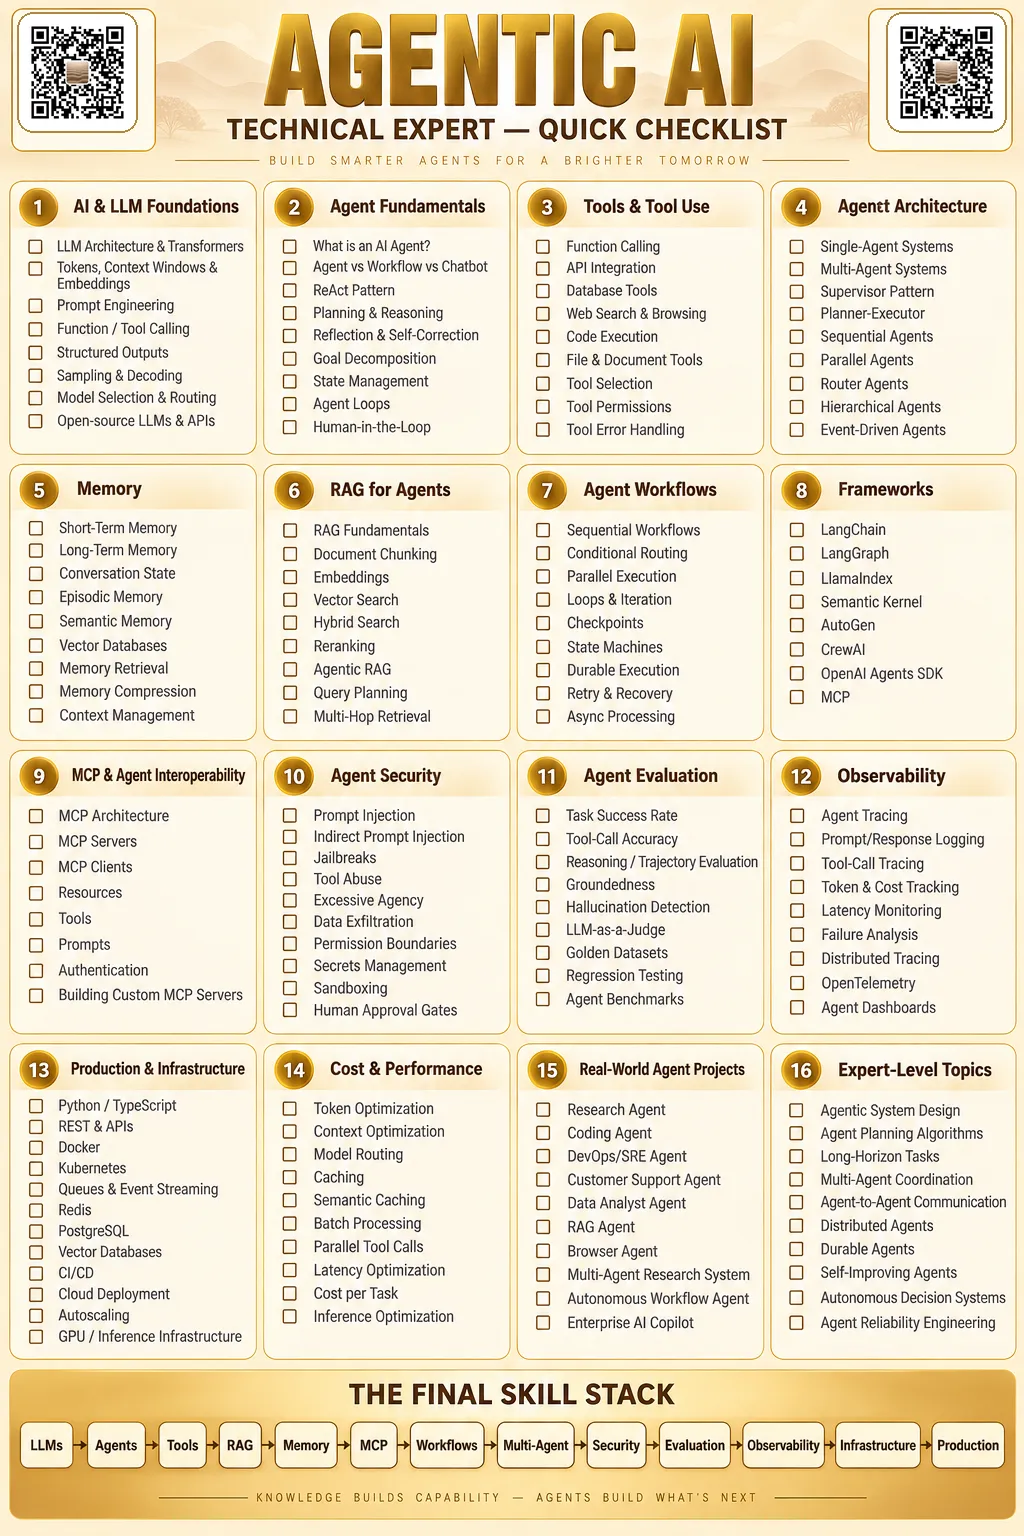
明天的荣耀必将感谢今天全力以赴的自己! 加油,陌生人,祝你越来越好!!
网宁AI出品,欢迎关注+订阅
2026 @ www.netning.com
概览
板块目录
1.1 LLM Architecture & Transformers(大模型架构与 Transformer) 1.2 Tokens, Context Windows & Embeddings(词元、上下文窗口与嵌入) 1.3 Prompt Engineering(提示词工程) 1.4 Function / Tool Calling(函数/工具调用) 1.5 Structured Outputs(结构化输出) 1.6 Sampling & Decoding(采样与解码) 1.7 Model Selection & Routing(模型选择与路由) 1.8 Open-source LLMs & APIs(开源大模型与 API)
01 AI 与大模型基础
大模型(LLM)是所有 Agent 的"大脑"。本板块讲清它的底层结构与最常用概念,是理解后续一切的地基。
1.1 LLM Architecture & Transformers(大模型架构与 Transformer)
- 一句话定义: 现代大模型几乎都基于 Transformer 架构——一种靠"注意力机制"处理序列的神经网络。
- 为什么需要: Transformer 解决了旧模型(RNN)难并行、记不住长距离依赖的问题,让"大规模预训练"成为可能。
- 生活化类比: 像开会时你会自动把注意力分配给"最相关的发言人"——注意力机制就是让模型对每个词分配"该关注谁"的权重。
- 关键术语: Attention(注意力)/ Self-Attention(自注意力)/ Decoder-only(仅解码器,GPT 类主流结构)/ Parameters(参数量)。
- 工作原理: 输入文本 → 切成 token → 转成向量 → 多层注意力反复"看上下文" → 预测下一个 token,循环生成。
- 入门 Demo(伪代码):
tokens = tokenize("今天天气")for layer in transformer_layers: tokens = self_attention(tokens) + feed_forward(tokens)next_token = predict(tokens) # 很可能是 "不错" - 应用案例: GPT、Claude、Llama 等所有主流对话模型。
🎯 记忆卡:Transformer = 靠"注意力"读懂上下文、逐字预测下一个词的网络。 ✅ 自测三问:① 它比 RNN 强在哪? ② 注意力机制在做什么? ③ "参数量大"意味着什么?
1.2 Tokens, Context Windows & Embeddings(词元、上下文窗口与嵌入)
- 一句话定义: Token 是模型处理文本的最小单位;上下文窗口是它一次能看的 token 上限;Embedding 是把文本变成一串数字向量。
- 为什么需要: 模型不认识"字",只认识数字。懂 token 才能算成本与长度;懂 embedding 才能做搜索与记忆。
- 生活化类比: Token 像"乐高积木块",上下文窗口像"你桌子有多大能摆多少块",Embedding 像给每个词发一张"语义坐标身份证"。
- 关键术语: Token(词元,约 0.75 英文词/1 汉字)/ Context Window(上下文窗口,如 128K)/ Embedding(嵌入向量)/ Vector(向量)。
- 常见误区: token ≠ 单词也 ≠ 字符;中文 1 字 ≈ 1~2 token。窗口用满会显著增加费用与延迟。
- 入门 Demo(伪代码):
n = count_tokens("Hello 世界") # 估算长度与费用vec = embed("猫") # -> [0.12, -0.03, ...] 1536 维sim = cosine(embed("猫"), embed("小猫")) # 值高 = 语义相近 - 应用案例: 计费与截断控制;语义搜索、RAG、记忆检索都依赖 embedding。
🎯 记忆卡:Token 是计价单位,窗口是容量上限,Embedding 是语义坐标。 ✅ 自测三问:① 为什么要关心 token 数? ② 上下文窗口满了会怎样? ③ Embedding 能用来做什么?
1.3 Prompt Engineering(提示词工程)
- 一句话定义: 通过精心设计给模型的输入(指令、示例、格式要求)来稳定地拿到想要的输出。
- 为什么需要: 同一个模型,提示写得好坏效果天差地别;它是"不改模型也能提效"的最低成本手段。
- 生活化类比: 像给新来的实习生交代任务——说清角色、给个范例、讲明交付格式,他就干得又快又对。
- 关键术语: System Prompt(系统提示,设角色规则)/ Few-shot(给几个示例)/ Chain-of-Thought(让它一步步想)/ Role(角色)。
- 最佳实践: 说清角色与目标、给出输出格式、给正/反例、复杂任务让它先分步推理。
- 入门 Demo(伪代码):
prompt = "你是资深翻译。把中文译成英文,只输出译文。示例:你好->Hello。输入:今天天气不错"llm(prompt) # -> The weather is nice today - 应用案例: 几乎所有 LLM 应用的第一层优化;Agent 的系统提示决定其行为边界。
🎯 记忆卡:提示词工程 = 用"会交代任务"的方式让模型稳定输出。 ✅ 自测三问:① System Prompt 和普通输入有何不同? ② Few-shot 是什么? ③ 复杂任务为何要让它"分步想"?
1.4 Function / Tool Calling(函数/工具调用)
- 一句话定义: 让模型不直接答,而是输出"要调用哪个函数、传什么参数",由程序执行后把结果再喂回它。
- 为什么需要: 模型本身不会查库、发邮件、算数;工具调用让它能"动手做事",是 Agent 的核心能力。
- 生活化类比: 像医生(模型)不亲自化验,而是开检验单(工具调用),拿到化验结果再下诊断。
- 关键术语: Tool/Function Schema(工具定义)/ Arguments(参数)/ Tool Result(工具返回)/ JSON。
- 工作原理: 把工具"说明书"给模型 → 模型选工具并生成参数 → 程序执行 → 结果回传 → 模型据此继续。
- 入门 Demo(伪代码):
tools = [{name:"get_weather", args:{city:"string"}}]resp = llm("北京天气?", tools)if resp.tool_call: # -> get_weather(city="北京") result = run(resp.tool_call) llm("根据结果回答", context=result) - 应用案例: 天气/查询助手、订单机器人;是第 3 板块「工具」的基础。
🎯 记忆卡:工具调用 = 模型开"任务单",程序去执行再把结果还给它。 ✅ 自测三问:① 为什么模型需要工具? ② Schema 的作用是什么? ③ 工具结果如何影响下一步?
1.5 Structured Outputs(结构化输出)
- 一句话定义: 强制模型按指定 schema(如 JSON)输出,而非自由散文,方便程序解析。
- 为什么需要: 程序需要稳定字段才能接着处理;自由文本容易解析失败、格式漂移。
- 生活化类比: 像让人"填表格"而不是"写作文"——字段固定,机器一读就懂。
- 关键术语: JSON Schema(结构定义)/ Validation(校验)/ Constrained Decoding(约束解码,强制符合格式)。
- 入门 Demo(伪代码):
schema = {name:"string", age:"number"}resp = llm("提取:张三 25 岁", output_schema=schema)# 保证得到 {"name":"张三","age":25},可直接 parse - 常见误区: 只在提示里说"输出 JSON"并不可靠;应使用模型的结构化输出/约束解码能力。
- 应用案例: 信息抽取、表单填充、Agent 的工具参数生成。
🎯 记忆卡:结构化输出 = 让模型"填表",程序稳定可解析。 ✅ 自测三问:① 为什么要结构化输出? ② 只在提示里要求 JSON 够吗? ③ 举一个用它的场景。
1.6 Sampling & Decoding(采样与解码)
- 一句话定义: 模型每步会给出很多候选 token 的概率,采样策略决定"怎么挑下一个词"。
- 为什么需要: 同样的提示,采样参数决定输出是稳定严谨还是发散有创意。
- 生活化类比: 像点菜——temperature 低是"每次都点招牌菜"(稳定),高是"闭眼随机尝鲜"(多样)。
- 关键术语: Temperature(温度,越高越随机)/ Top-p(核采样)/ Top-k / Greedy(贪心,永远取最高概率)。
- 一表看懂:
temperature=0 → 确定、可复现,适合抽取/代码temperature=0.7 → 平衡,适合对话temperature=1.2 → 发散、有创意,适合头脑风暴 - 入门 Demo(伪代码):
llm("写广告语", temperature=1.0) # 每次不同 - 应用案例: 需要稳定的抽取/评测用低温;文案/创意用高温。
🎯 记忆卡:温度越高越"放飞",越低越"守规矩"。 ✅ 自测三问:① temperature 控制什么? ② 抽取任务该用高温还是低温? ③ Greedy 是什么意思?
1.7 Model Selection & Routing(模型选择与路由)
- 一句话定义: 根据任务难度和成本,把请求分发给不同规模/价格的模型。
- 为什么需要: 大模型强但贵慢,小模型便宜快;全用大模型浪费钱,全用小模型质量差。
- 生活化类比: 像医院分诊——小毛病找全科(小模型),疑难杂症才转专家(大模型)。
- 关键术语: Router(路由器)/ Frontier Model(旗舰大模型)/ Small Model(小模型)/ Fallback(降级备选)。
- 入门 Demo(伪代码):
model = "small-cheap" if is_simple(task) else "big-smart"resp = llm(task, model=model) - 应用案例: 客服系统简单问题走小模型、复杂问题升级;成本优化(详见第 14 板块)。
🎯 记忆卡:模型路由 = 按任务难易"分诊"到合适模型,省钱又保质。 ✅ 自测三问:① 为什么不全用最强模型? ② Fallback 有什么用? ③ 怎么判断该用哪个模型?
1.8 Open-source LLMs & APIs(开源大模型与 API)
- 一句话定义: 既可调用闭源模型的云端 API,也可自己部署开源模型(如 Llama、Qwen)。
- 为什么需要: API 上手快、免运维;开源模型可私有化部署、数据不出门、可微调、长期成本可控。
- 生活化类比: 云 API 像"打车"(省心按次付费),自托管开源像"自己买车"(前期投入大但可控自由)。
- 关键术语: API(云端调用接口)/ Open-weight(开放权重)/ Self-hosting(自托管)/ Inference Server(推理服务,如 vLLM)。
- 选型对比:
云 API:省心、最强模型、按量付费、数据出门开源自托管:可控/私密/可微调,但需 GPU 与运维 - 入门 Demo(bash):
curl localhost:8000/v1/chat/completions -d '{"model":"qwen","messages":[...]}' - 应用案例: 隐私/合规敏感的企业内部 Agent 常选开源自托管;快速原型多用云 API。
🎯 记忆卡:要省心用云 API,要可控/私密就自托管开源。 ✅ 自测三问:① 云 API 的最大缺点是什么? ② 什么场景必须用开源自托管? ③ 自托管需要准备什么资源?
相关内容
一张图看懂Agentic AI 16大板块148个技术点 AI Agent 工程认知全景 一张图看懂 LLM、AI Agent、Agentic AI DeepSeek Harness 新手极简入门指南 AI领域专业英语术语-架构篇
下一板块 → 【02-智能体基础】
—— END ——