ARTICLE · 1067537
Upscale AI:用5亿美元和一张白纸,重写AI数据中心网络的规则
当所有人都在卷GPU算力时,有一群人发现:真正卡住AI集群脖子的,不是算力,而是网络。Upscale AI——这家成立不到一年、估值已飙至20亿美元的硅谷独角兽——正用一颗名为 SkyHammer™ 的定制化交换芯片,向NVIDIA的NVSwitch发起正面挑战。
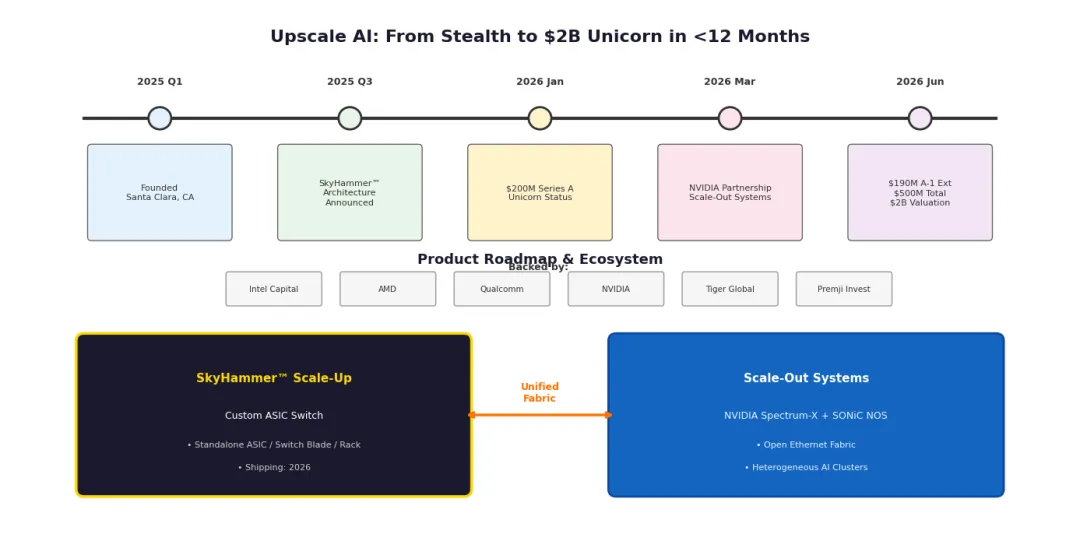
一、公司速览:从隐身到独角兽,只用了不到12个月
Upscale AI 于2025年在加州Santa Clara成立,由前Auradine高管 Barun Kar(CEO)和 Rajiv Khemani(Executive Chairman)创办。团队核心来自Cisco、Broadcom、NVIDIA等网络与芯片巨头。
其融资节奏堪称疯狂:
2025年初:$1亿美元种子轮
2026年1月:$2亿美元A轮,Tiger Global与Premji Invest领投,直接跻身独角兽
2026年6月:追加$1.9亿美元A-1轮,总融资达5亿美元,估值20亿美元
投资方名单极具深意:Intel Capital、AMD、Qualcomm、Tiger Global、Premji Invest——以及 NVIDIA。连"被挑战者"都成为了股东,足见AI网络赛道的战略价值。
Upscale AI的自我定位非常清晰:全球第一家 pure-play AI 网络公司。不做GPU,不做XPU,只做一件事——让AI集群里的所有加速器、内存和存储,像一台机器一样协同工作。
二、产品全景:不是算力芯片,是AI网络的"高速公路"
Upscale AI的产品线分为两层,恰好对应AI数据中心的两大网络域:
1. SkyHammer™ —— Scale-Up 核心交换ASIC
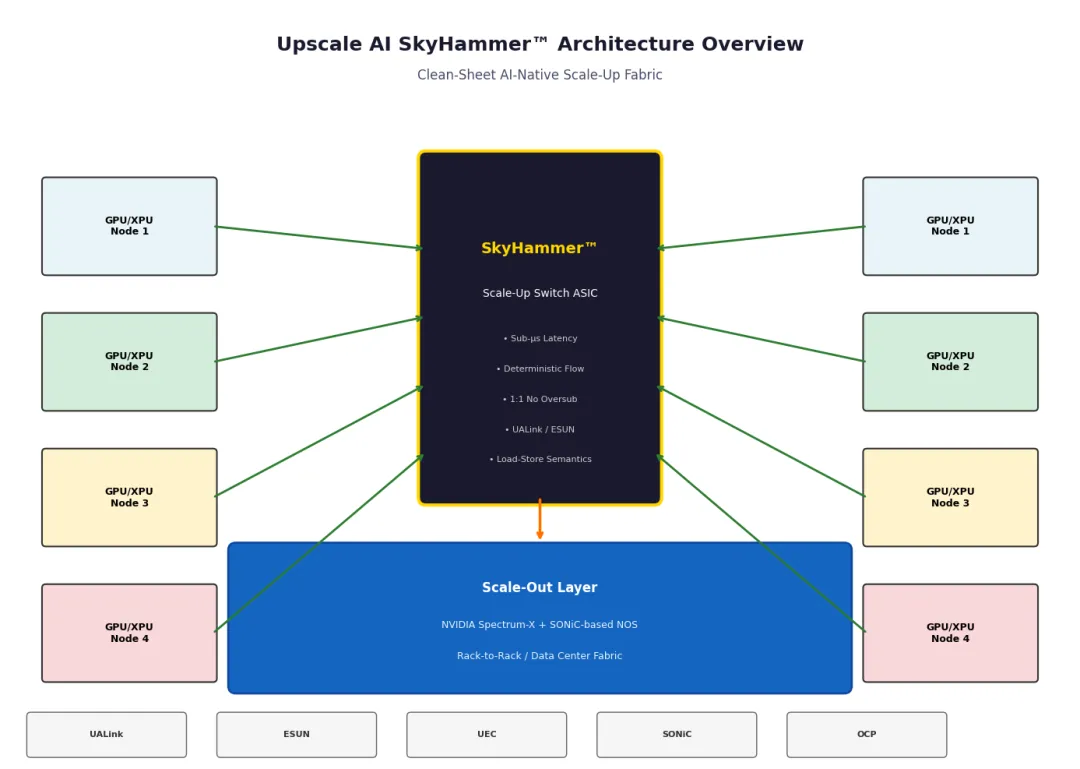
这是Upscale AI的"核武器",一颗从零设计的定制化交换芯片,直接对标NVIDIA NVL72机架中的NVSwitch。
SkyHammer的定位是机架内高速互联:把同一机架内的GPU、XPU、内存和存储,通过纳米秒级延迟的load/store语义网络,融合成一个统一的、同步的、无阻塞的计算单元。
产品形态三种:
独立ASIC:供超大规模客户自研系统集成
交换刀片:集成到第三方机架系统
整机架系统: turnkey交付
2. Scale-Out 系统 —— 基于NVIDIA Spectrum-X的开放以太网
有趣的是,Upscale AI在Scale-Out(机架间/数据中心级互联)领域选择了与NVIDIA合作:采用NVIDIA Spectrum-X以太网交换芯片,叠加自研的AI优化版SONiC网络操作系统。
这种"既竞争又合作"的策略,让Upscale AI在Scale-Up领域挑战NVLink生态,同时在Scale-Out领域借助NVIDIA的成熟硅片快速落地。
三、架构深度:Clean-Sheet 设计的六个核心选择
SkyHammer不是"改良版交换机",而是为AI负载重新发明的网络原语。其架构设计体现了极端的领域专用思维:
1. 内存语义 Load-Store 架构
传统网络基于"报文转发"语义,而SkyHammer采用内存语义——将网络视为CPU/GPU的扩展内存总线,直接支持load/store操作。这彻底改变了加速器之间的通信范式。
2. 亚微秒级确定性延迟
SkyHammer的往返延迟(RTT)目标为 500–700纳秒。作为对比,传统数据中心交换机在AI集体通信场景下往往达到微秒甚至数十微秒级。这种确定性延迟是万亿参数模型同步训练的关键。
3. 单级拓扑假设
架构设计假设Scale-Up域内任意两个GPU之间仅经过一次交换跳数(single-stage topology)。这极大简化了ASIC的转发逻辑、缓存设计和流控机制——不需要复杂的多跳路由,只为"扁平、高速、可预测"而生。
4. 1:1 无超额订阅
传统交换机常采用超额订阅(oversubscription)来降低成本,但AI集体通信(AllReduce、AllGather)要求任何时刻任何端口都能获得标称带宽。SkyHammer坚持严格的1:1带宽保证,网络永远不会成为瓶颈。
5. 零丢包无损 fabric
摒弃传统的PFC(Priority Flow Control)拥塞控制,采用链路级重传(link-level retry)机制。结合确定性流控,实现真正的零丢包网络——昂贵的GPU不会在等待网络重传中空转。
6. 多协议灵活语义
SkyHammer原生支持 UALink、ESUN、UEC 等开放互联标准,且架构具备"灵活语义"——可以在不重新流片的情况下适配新协议版本。这是对AI互联标准混战局面的精准押注。
四、跑分与性能指标:网络芯片的"算力"怎么比?
需要明确:SkyHammer尚未正式出货(计划2026年发布),因此没有第三方MLPerf式跑分。但Upscale AI公布的架构级性能指标,已足够让网络工程师兴奋:
| 往返延迟 | |||
| 带宽保证 | |||
| 丢包率 | |||
| 拓扑跳数 | |||
| 协议支持 | |||
| 遥测粒度 |
特别值得关注的是集体通信加速:SkyHammer内置了类似NVIDIA SHARP的in-network computing能力,可以在交换节点上直接执行Reduce操作,大幅减少数据搬运量。
五、封装与系统:从硅片到机架的全栈思维
SkyHammer的封装和系统策略,体现了"芯片即系统"的设计理念:
芯片级
定制化ASIC:非FPGA/商用交换芯片改装,从晶体管级别为AI负载优化
先进工艺:虽未公布具体制程,但鉴于500-700ns延迟目标和2026年出货计划,预计采用先进FinFET工艺(推测5nm级或更先进)
高集成度:单芯片需集成大量SerDes、灵活协议解析引擎、telemetry处理单元
系统级
低损耗PCB/背板设计:单级拓扑要求信号完整性做到极致
统一机架供电与散热:与计算节点协同的电源和散热架构
光/电互联混合:机架内短距可能用电,跨机架用光
软件级
SONiC-based NOS:基于微软开源SONiC深度定制,超大规模客户零学习成本
AI优化调度:与GPU调度器协同,网络感知任务放置
Upscale AI强调:SkyHammer无法独立运行,必须与GPU/XPU协同工作。这决定了其封装和系统设计的核心约束——它是一颗"协处理器",服务于计算集群的同步需求。
六、设计难点:为什么这颗芯片难做?
SkyHammer的clean-sheet设计听起来美好,但工程实现面临多重挑战:
难点1:全栈协同的复杂度
从晶体管→芯片→PCB→机架→软件,每一层都必须为"亚微秒确定性"服务。传统网络公司做芯片、芯片公司做系统,Upscale AI要求一个团队同时精通所有层级,任何一环的妥协都会击穿延迟承诺。
难点2:开放标准 vs 极致性能的平衡
支持UALink、ESUN、UEC多协议,意味着芯片必须保留足够的可编程灵活性。但灵活性往往以面积、功耗和延迟为代价。SkyHammer的"灵活语义"设计如何在硅片面积和性能之间取舍,是核心商业秘密。
难点3:与NVIDIA生态的竞合关系
NVIDIA既是Upscale AI的投资方,又是其Scale-Up领域的直接竞争对手(NVLink/NVSwitch)。Upscale AI需要在"借助NVIDIA的Scale-Out生态获客"和"在Scale-Up领域打破NVLink垄断"之间走钢丝。
难点4:缺乏第三方基准验证
目前所有性能数据均为架构目标或内部测试。在2026年产品正式出货前,Upscale AI必须说服超大规模客户:一颗初创公司的芯片,能在可靠性上媲美Cisco、Arista、Broadcom的成熟产品。
难点5:协议标准的"鸡生蛋"困境
UALink和ESUN生态尚未成熟。SkyHammer的成功不仅取决于自身硅片质量,还取决于AMD、Intel、Qualcomm等盟友能否推出足够多支持这些协议的GPU/XPU。
七、工程师学习点:SkyHammer教会我们什么?
无论Upscale AI最终成败,其设计方法论都值得每一位芯片和系统工程师深思:
1. 领域专用架构(DSA)的极致实践
SkyHammer把"做减法"做到了极致:砍掉所有企业级特性、砍掉多跳路由、砍掉超额订阅。每个晶体管都必须为AI负载"赚钱"。当你设计ASIC时,先问:这个特性我的目标工作负载真的需要吗?
2. 确定性优于平均值
AI训练不 care 平均延迟,care 的是尾延迟(P99/P999)和确定性。SkyHammer的每一个设计选择(单级拓扑、链路级重传、1:1带宽)都服务于"最坏情况可预测"。这对实时系统和加速器互联设计极具启发。
3. 开放标准是最好的护城河
Upscale AI选择拥抱UALink/ESUN/UEC,而非自建私有协议。在AI基础设施领域,开放性本身就是一种竞争壁垒——客户害怕被NVIDIA锁定,愿意为"可选项"支付溢价。
4. 网络是计算堆栈的一级公民
传统数据中心把网络视为"管道",Upscale AI把网络视为计算资源的延伸。load/store语义、in-network computing、微秒级遥测——这些理念正在重新定义"网络"在系统架构中的位置。
5. 全栈思维 > 局部优化
SkyHammer的竞争力不在某一项单点技术,而在"硅片-系统-软件-机架"的纵向打通。对硬件工程师的启示:不要只优化你的RTL,要优化你的RTL在机架里跑起来的样子。
结语:网络战争,才刚刚开始
Upscale AI的野心不止于做一颗更好的交换芯片。它试图重新定义AI基础设施的底层规则:从"以GPU为中心"转向"以网络为骨架"的异构计算生态。
当NVIDIA用NVLink编织封闭帝国时,Upscale AI用5亿美元和一张白纸,赌的是开放标准+极致性能能够撕开一道口子。2026年,SkyHammer硅片即将出货——那将是检验这场豪赌的第一张考卷。
对于工程师而言,无论Upscale AI成败,它都已经证明了一件事:在AI时代,网络不再是"连接计算"的配角,而是"定义计算"的主角。