ARTICLE · 1070095
AI 前沿|WorkBuddy 实战③|告别复制粘贴!AI与Obsidian双向自动流转
完成前面两期,我们已经搭好 WorkBuddy 工作台底座,也建立起 ima 云端素材知识库。但实际工作流里还横亘着一道很折磨人的鸿沟:AI 产出内容和本地笔记库之间的割裂。
很多人的日常操作是,在 WorkBuddy 得到整理好的方案、思考纪要,手动全选复制,粘贴进 Obsidian;写完 Obsidian 的灵感、待办、项目笔记,又要再复制粘贴回 AI 对话窗口,请求进一步加工。反复复制、来回切换窗口,大量时间消耗在搬运内容上。更麻烦的是,一旦对话关闭,AI 产出就留在会话记录,无法沉淀进本地双链库;写在 Obsidian 里的待办任务,也很难直接驱动 AI 去执行调研、整理、检索等动作。
这一期修炼清单 03,我们打通WorkBuddy 与 Obsidian 双向链路,实现 AI 内容自动落笔记库、Obsidian 笔记内的想法与待办可以反向交给 Agent 处理,砍掉 80% 手动复制粘贴操作,把云端 AI 能力和本地双链笔记真正融合为一套完整工作流。

搞懂底层逻辑:
为什么要做双向流转

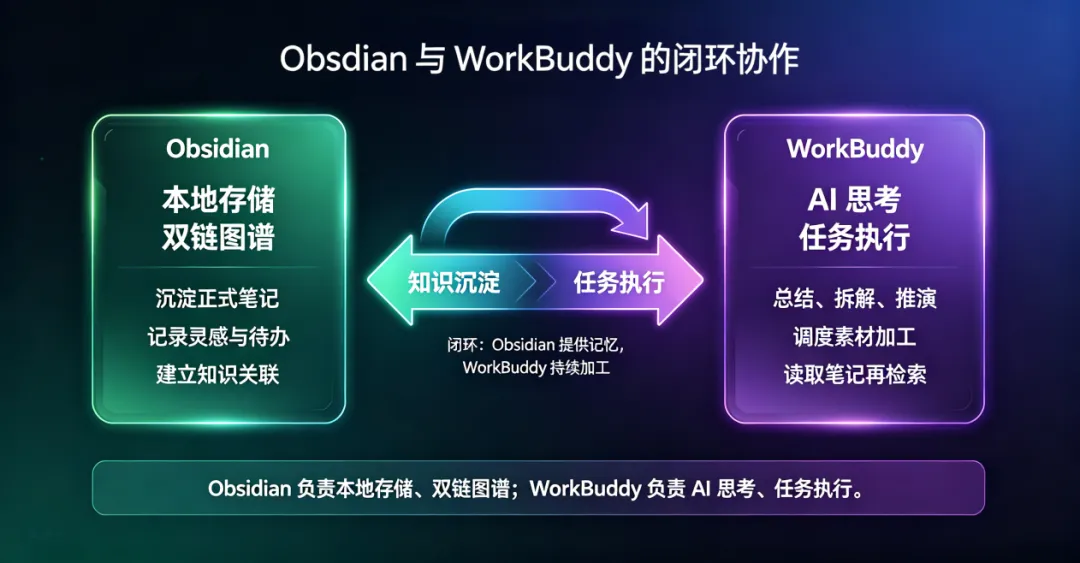
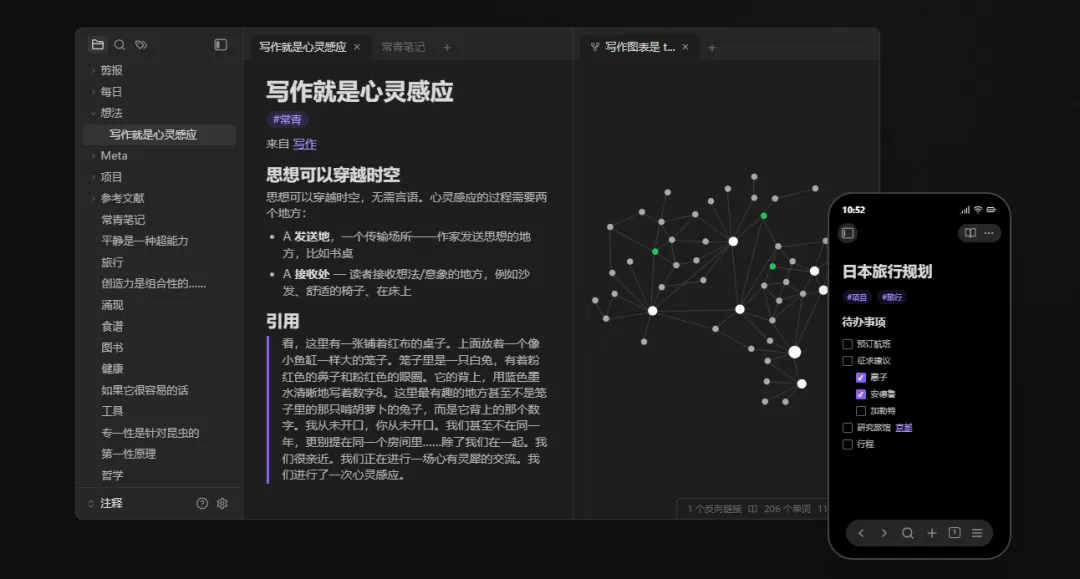
Obsidian 的优势在于本地 Markdown 文件、双向链接、知识图谱,数据完全保存在你的电脑,不受平台限制。但它本身缺少强大 AI 代理能力,不擅长联网调研、批量整理素材、自动执行任务。
WorkBuddy 作为 AI 代理,擅长思考、调研、处理批量任务,但会话内的内容是临时的,如果不主动沉淀,对话结束就容易丢失。
核心不是简单实现“AI 写笔记”,而是建立双向闭环:✅正向:WorkBuddy 输出的纪要、方案、摘要,自动写入 Obsidian vault,自动生成双链、标签✅反向:读取 Obsidian 笔记里的项目记录、灵感、待办条目,把内容输入给 WorkBuddy,驱动 AI 完成对应的任务 |
很多人踩坑就在这里:只做到单向 AI 写入笔记,忽略反向读取笔记驱动 Agent,并没有真正释放这套组合的价值。

实操配置,打通 WorkBuddy 访问 Obsidian

第一步:确认 Obsidian 库(Vault)本地路径
打开 Obsidian,把鼠标悬浮左下角库名称,即可看到完整本地文件夹路径,复制保存这一串路径,后续配置会用到。
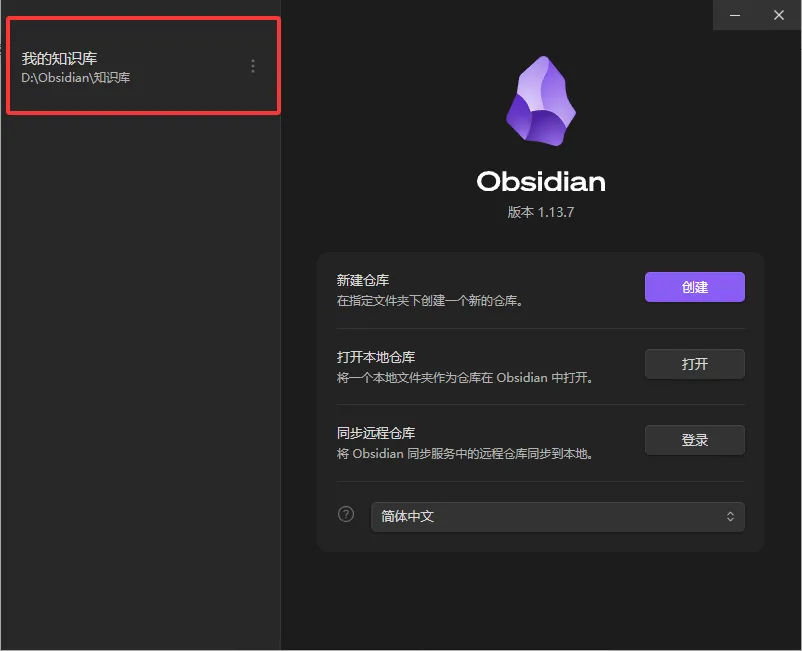
重点:Obsidian vault 本质就是电脑普通文件夹,全部笔记都是.md文件,Agent 就是通过访问文件夹实现读写操作。 |
第二步:在 WorkBuddy 配置目录权限
进入 WorkBuddy 连接器 / 工作空间设置,把刚才复制的 Obsidian 库路径加入授权目录。
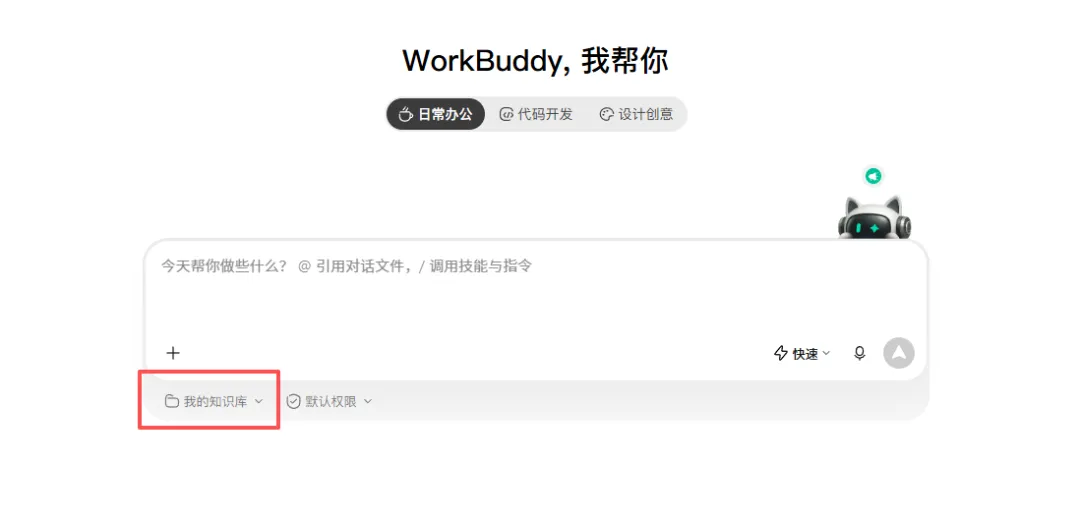
⚠️避坑:只授权 Obsidian vault 文件夹,不要授权电脑全盘目录,缩小权限范围,规避误操作风险。 |
第三步:连通测试
在 WorkBuddy 对话框发送测试指令:
读取 Obsidian 库根目录,列出文件夹下前 5 篇笔记文件名。 |
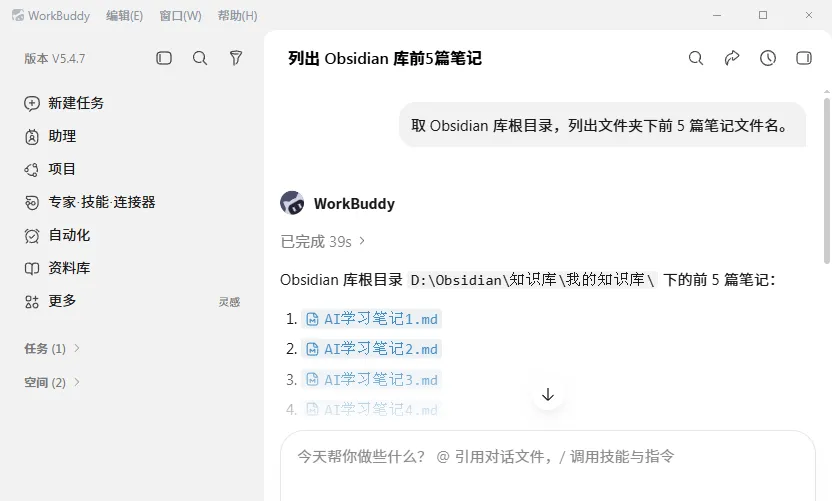
如果正常返回笔记名称,代表读取链路已经通了。接下来测试写入,建议先建立一个我的知识库文件夹,所有 AI 生成内容优先写入草稿箱,确认内容无误,再手动移入正式笔记目录,不要让 AI 直接修改正式历史笔记。
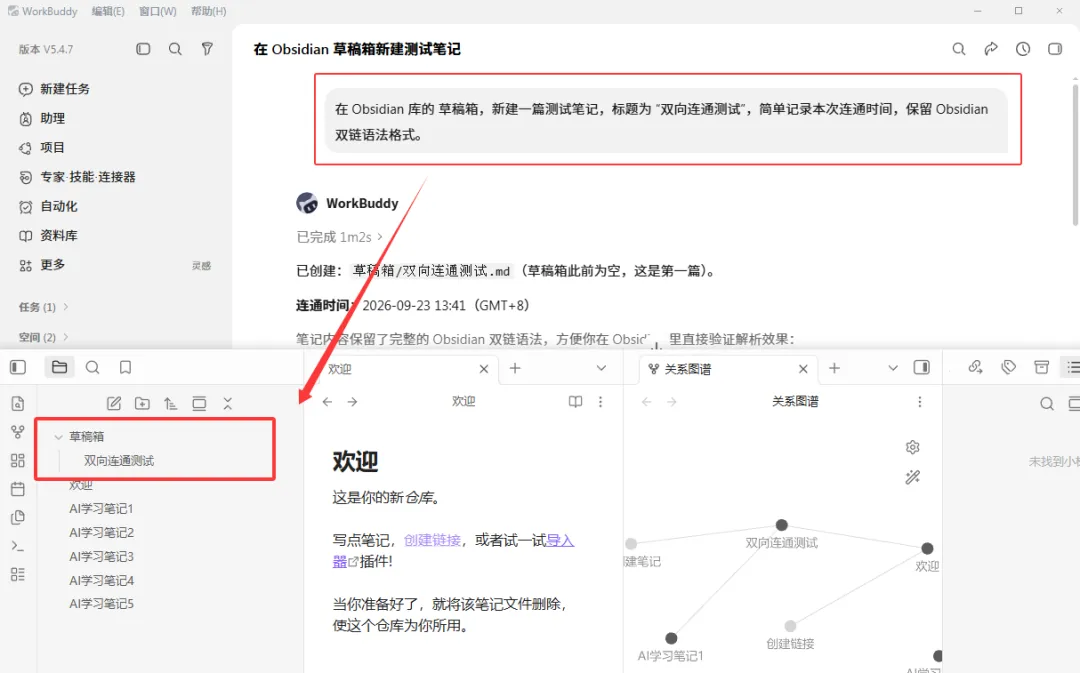
测试写入指令示例:在 Obsidian 库的 草稿箱,新建一篇测试笔记,标题为 “双向连通测试”,简单记录本次连通时间,保留 Obsidian 双链语法格式。 |
写完之后切回 Obsidian,刷新库,能够看到这篇新建笔记,说明写入链路正常。

正向工作流:AI 产出自动沉淀进 Obsidian

链路打通之后,我们就可以告别复制粘贴。不管是会议纪要拆解、资料总结、方案草稿、读书笔记,直接让 WorkBuddy 完成任务之后,把结果直接输出写入 Obsidian 草稿箱。
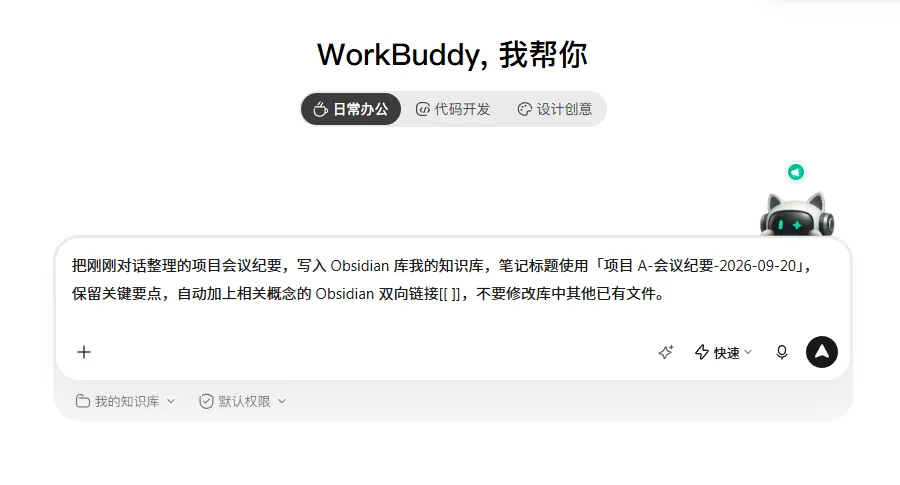
场景示例 1:会议纪要自动落笔记
把刚刚对话整理的项目会议纪要,写入 Obsidian 库我的知识库,笔记标题使用「项目 A‑会议纪要‑2026‑09‑20」,保留关键要点,自动加上相关概念的 Obsidian 双向链接[[ ]],不要修改库中其他已有文件。 |
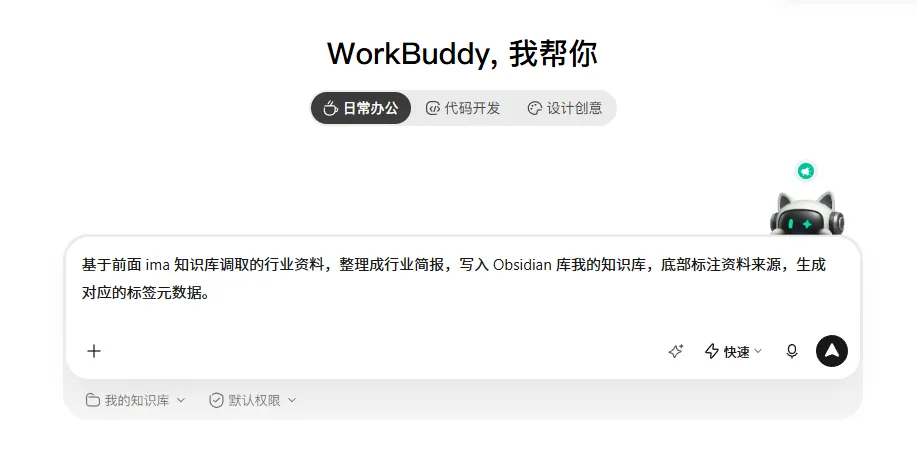
场景示例 2:素材整理自动生成笔记
基于前面 ima 知识库调取的行业资料,整理成行业简报,写入 Obsidian 库我的知识库,底部标注资料来源,生成对应的标签元数据。 |
重要原则:
1. AI 生成全部优先进草稿箱,人工审阅之后,再归档正式目录;
2. 指令中明确要求保留 YAML 标签、双链语法,防止 AI 破坏笔记原有格式;
禁止让 AI 直接批量修改旧笔记,避免出现断链、元数据丢失问题。

反向工作流:读取 Obsidian 笔记,驱动 AI 执行任务

这是大多数教程会忽略的半环:Obsidian 笔记中的内容反向喂给 WorkBuddy,触发 AI 行动。
你的 Obsidian 里面会存大量:项目想法、零散灵感、待办清单、半成品思考。以前你需要复制出来提问,现在可以直接让 WorkBuddy 读取笔记完成工作。
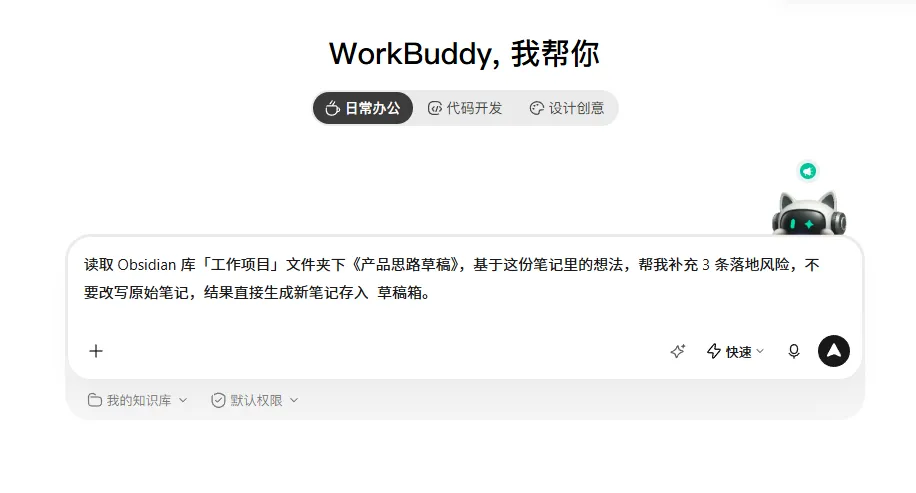
示例 1:读取笔记,完善方案
读取 Obsidian 库「项目 A」文件夹下《产品思路草稿》,基于这份笔记里的想法,帮我补充 3 条落地风险,不要改写原始笔记,结果直接生成新笔记存入 草稿箱。 |
示例 2:识别笔记内待办,驱动 AI 执行调研
读取 Obsidian 库中本周待办笔记,筛选标记为#AI执行的条目,完成对应的资料调研,调研结果输出新笔记写入草稿箱。 |
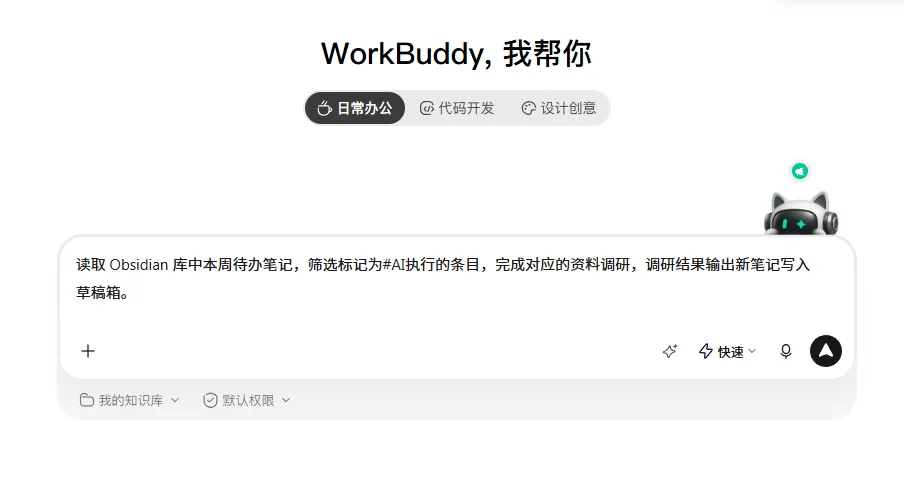
关键提醒:指令设置“只读原始笔记,不改动原文”。原始思考草稿尽量保持人为书写原貌,AI 输出全部生成新文件,做到人与 AI 产出分开,防止 Agent 改写你的一手思考记录。

完整闭环:ima + WorkBuddy + Obsidian

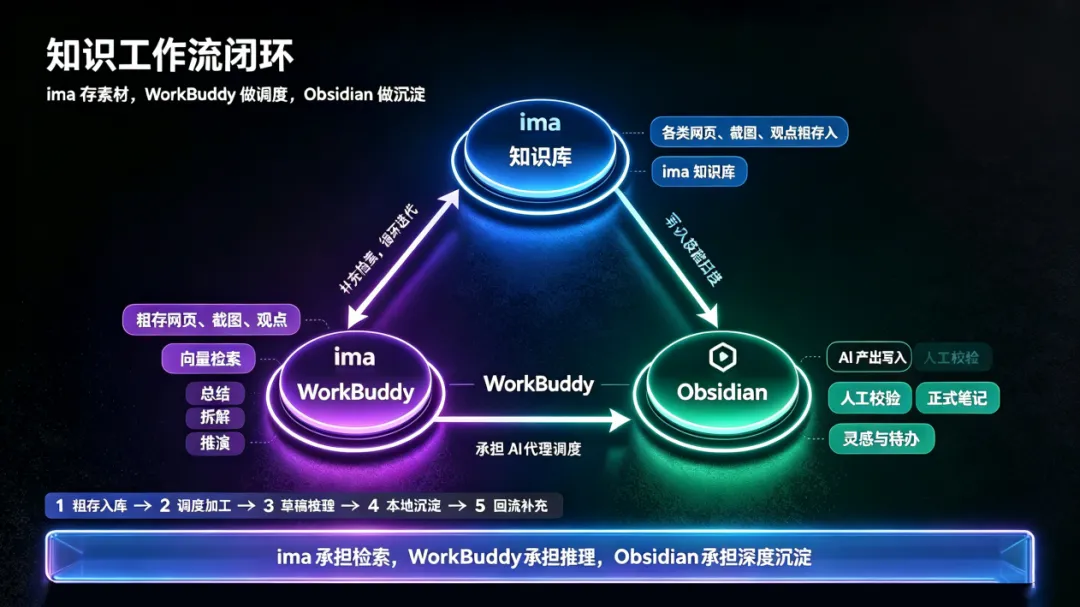
结合前面两期内容,整套完整链路已经成型:
1. 各类网页、截图、观点粗存入 ima 知识库;
2. WorkBuddy 从 ima 调取素材,做总结、拆解、推演;
3. AI 产出写入 Obsidian 草稿箱,人工校验,归档到正式本地笔记;
4. 在 Obsidian 记录灵感、待办;
5. WorkBuddy 读取 Obsidian 笔记,再回到 ima 检索补充素材,循环迭代。
ima 承担云端素材存储与向量检索;WorkBuddy 承担 AI 代理调度;Obsidian 承担本地深度沉淀、双链图谱。三者各司其职,不重复做相同的事情。

高频踩坑清单,实操一定要看

❌坑 1:直接给 AI 开放全部笔记修改权限,让它批量改写旧笔记
风险:双链断裂、frontmatter 标签被覆盖、历史笔记被篡改。解法:AI 只允许写草稿箱,正式笔记由人手动处理归档。 |
❌坑 2:Obsidian 软件和 WorkBuddy 同时编辑同一个文件
风险:文件冲突,内容丢失。解法:AI 写入期间,避免 Obsidian 正在编辑同一篇笔记,写完之后在 Obsidian 刷新查看结果。 |
❌坑 3:不区分草稿与正式库,AI 生成内容直接混入核心知识库
长期下来笔记库大量 AI 垃圾内容,和自己一手思考混杂,无法分辨。 |
❌坑 4:追求全自动化,完全交给 AI 处理一切
AI 擅长整理、检索、格式处理,但核心思考判断仍然要由人完成,自动化只是减少搬运劳动,不是替代思考。 |
什么时候适合这套双向工作流
✅适合:项目管理、会议沉淀、读书笔记、方案草稿,经常在 AI 和笔记软件来回切换的人。❌不适合:希望一键全自动生成完整知识库,完全不想人工审阅内容的用户。
Obsidian 与 WorkBuddy 双向流转,本质解决的不是 “写笔记” 的问题,而是解决工具之间的割裂。把人从复制粘贴这种无意义搬运工作释放出来,把精力留给思考、判断、筛选。
ima 负责海量原始素材收纳,WorkBuddy 负责 AI 加工执行,Obsidian 负责本地深度沉淀与知识网络,三部分串联,一套完整 AI 知识工作流就搭建完毕。
你平时在 AI 工具和笔记软件之间,还有哪些重复搬运的痛点?欢迎评论区交流。
👉下篇预告:第 05 期|WorkBuddy 实战④|自然语言操控 Excel,把表格处理交给 Agent