ARTICLE · 1075461
315KB压到约5KB!这个MCP插件专治上下文爆炸
点击蓝色“架构文摘”关注我哟
加个“星标”,每天上午 11:08,干货推送!

不知道大家AI编程的时候是否也遇到,用 Claude Code、Cursor、Copilot 这类工具写真实项目,最烦的不是模型笨。
是上下文被工具输出吃掉。
gh issue list 返回 59KB JSON,测试日志几十 KB,Playwright 快照 56KB。单次看都不大,几十轮后会被反复重发。Token(大模型处理文本的计量单位)就这么被烧掉。
更大的问题是压缩失忆。上下文一满,Agent 开始总结、丢弃原文。你刚讲清的项目结构、刚踩过的坑,下一轮可能又要重讲。
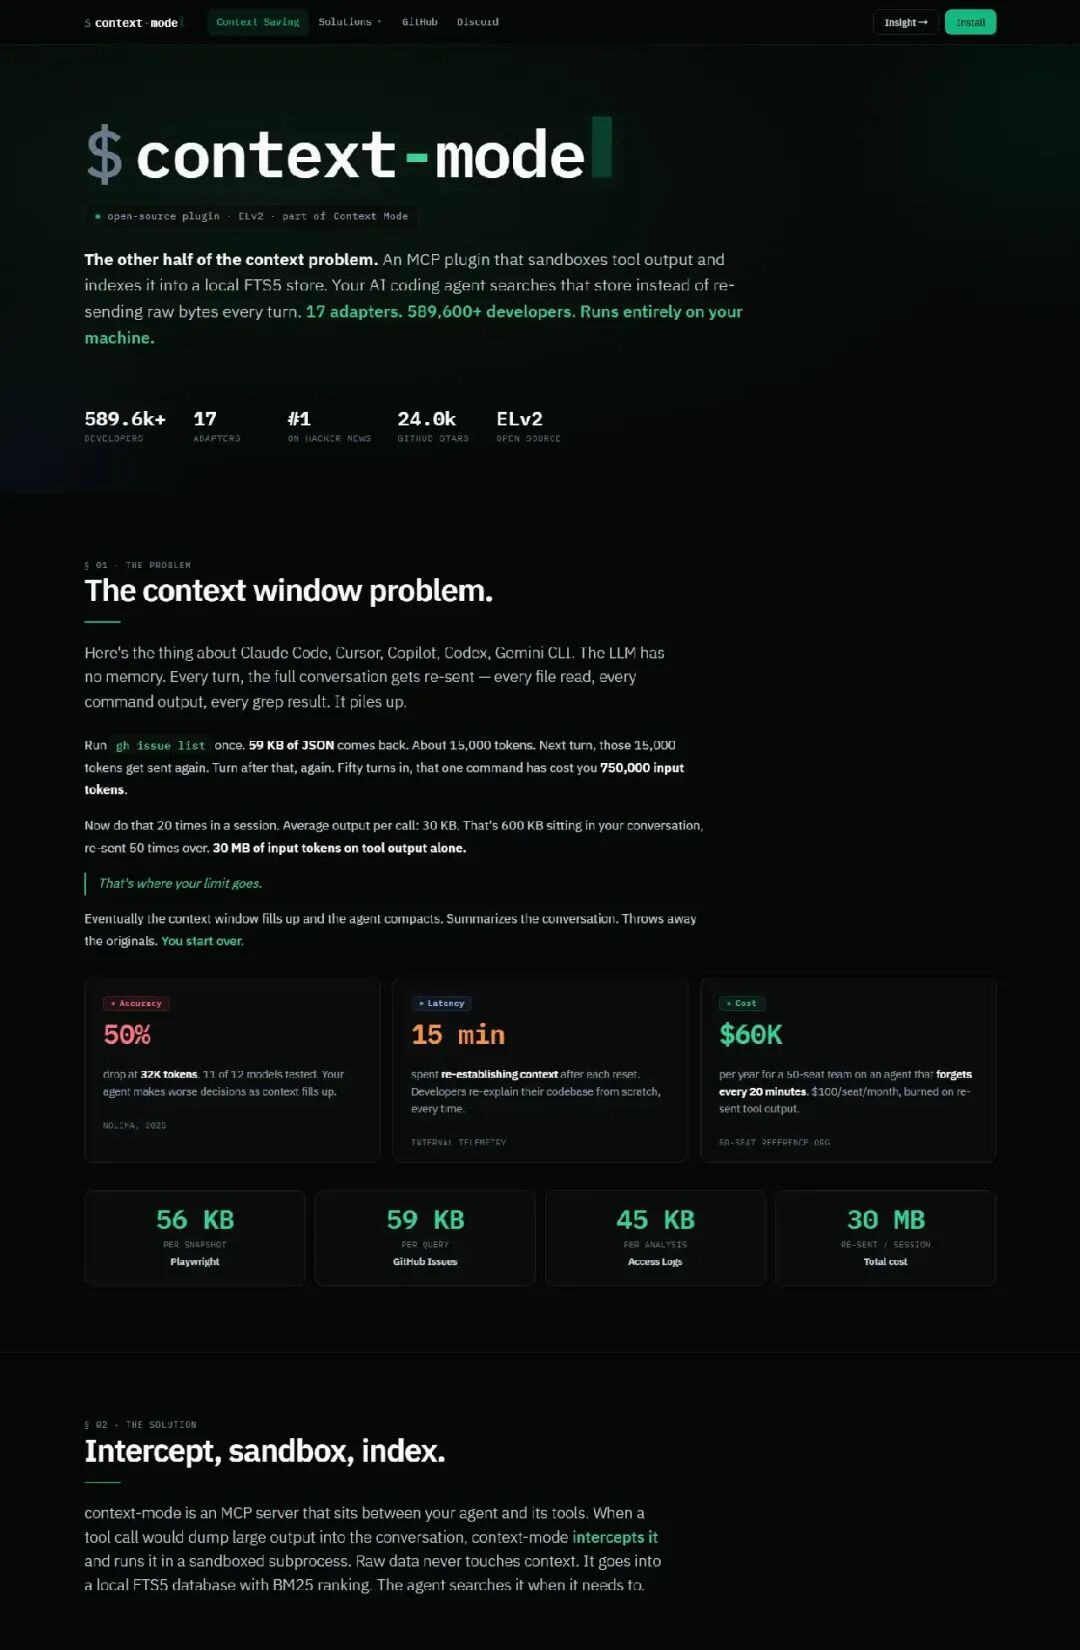
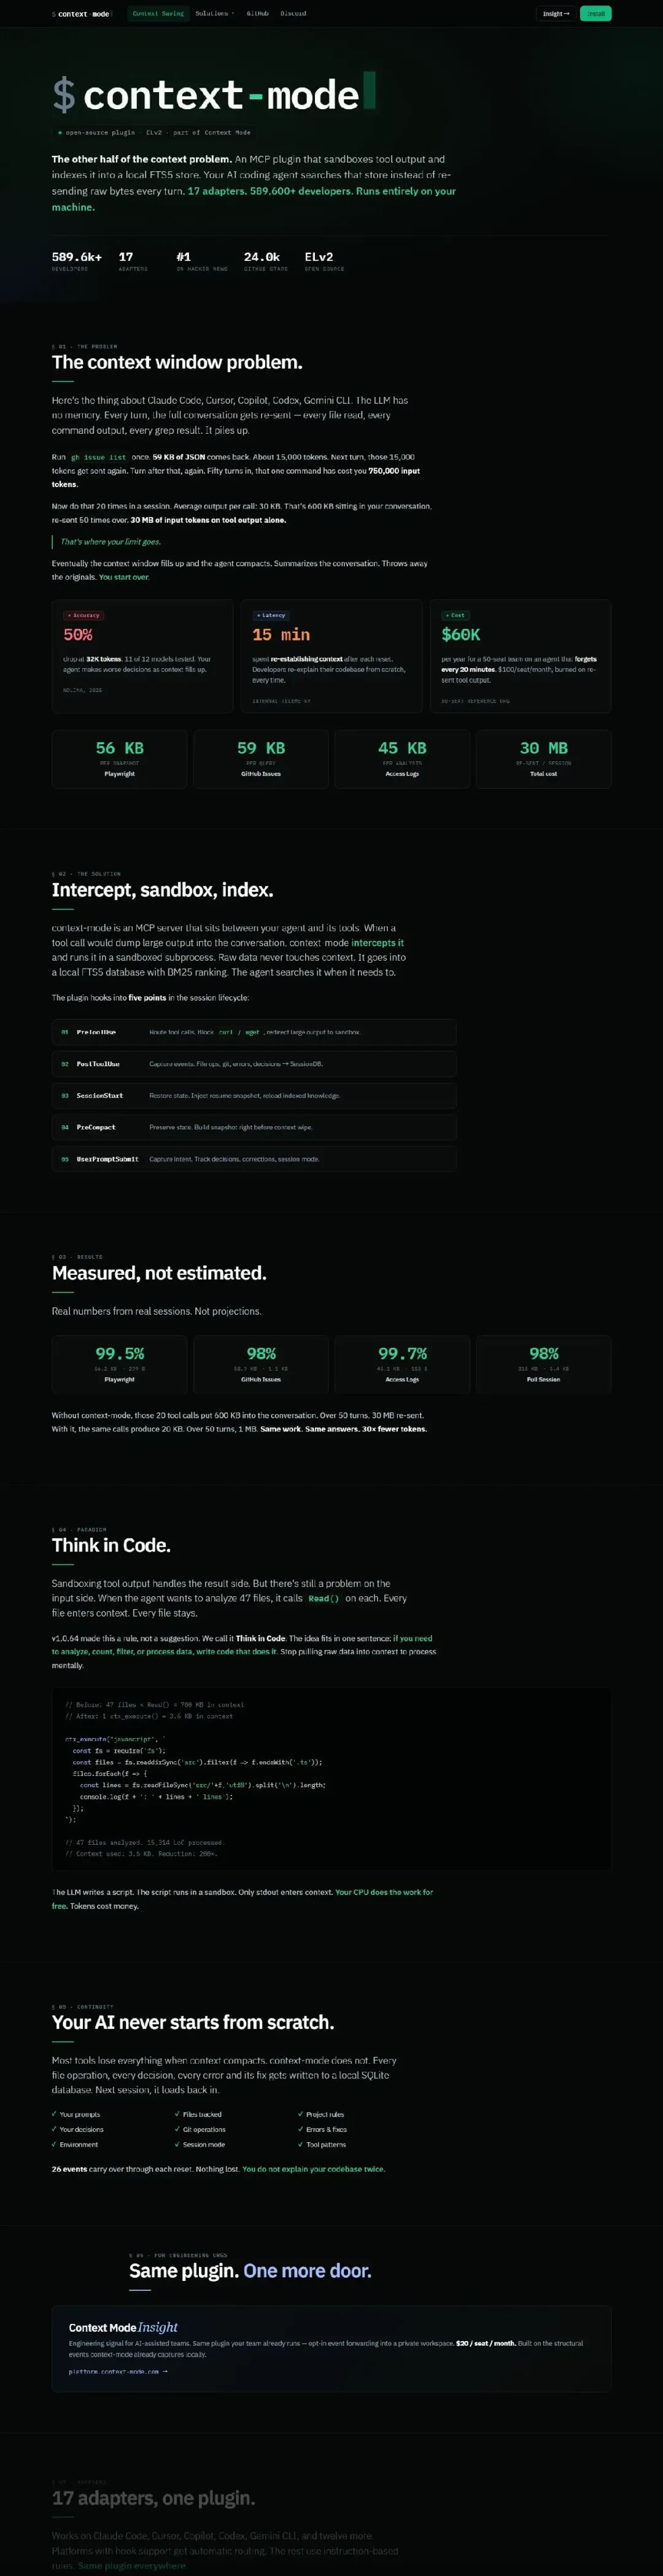
context-mode 把这件事搬到 MCP(模型上下文协议)和 hooks 层处理。截至今天,GitHub API 显示它有 23,997 Star;README 徽章标注 Hacker News 首页榜首、570+ 分。
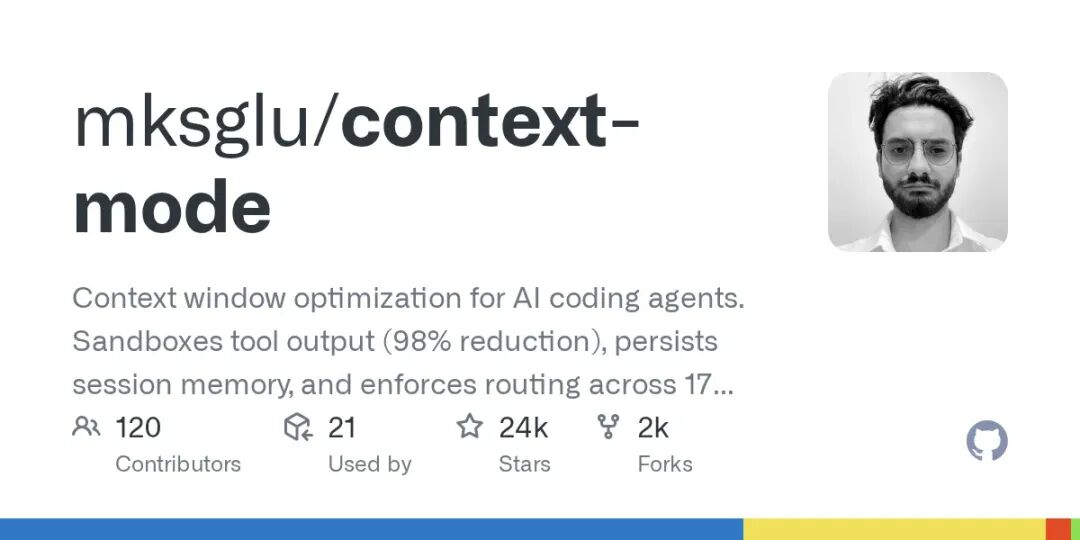
先说明下:我没有复现它全部 21 个 benchmark,下面的性能数字来自官方 README、BENCHMARK.md 和 docs/platform-support.md。
一、它到底解决什么问题?
context-mode 是一个 MCP 服务器 + hooks 层。
它插在 AI 编程 Agent 和工具之间:工具输出先进沙箱或本地索引,只有摘要、指针、检索结果进入上下文。
和传统做法最大的区别在这里:
Prompt 工程:求模型“少读点、省着点” context-mode:直接改变数据流向,不让原始数据进上下文
二、3 个核心亮点
1. Sandbox:先把“原始字节”挡在门外
官方 BENCHMARK.md 用真实工具输出做了 21 个场景:总原始数据 376KB,进入上下文 16.5KB,整体节省 **96%**。
其中结构化数据处理子集是 315KB → 5.5KB,节省 **98%**。官网页面写作约 5.4KB,差异来自四舍五入。
几个直观数据:
Playwright 页面快照:56.2KB → 299B GitHub Issues:58.9KB → 1.1KB nginx 访问日志:45.1KB → 155B 大型 JSON API:7.5MB → 0.9KB
它不是简单截断。原始内容会进本地 SQLite,上下文里只保留摘要或索引指针。
2. Think in Code:分析交给 CPU,不把文件塞进脑子
这是我觉得最有工程味的设计。
旧流程是:模型读 47 个文件 → 自己数行数、找规律 → 上下文塞满。
新流程是:模型写一个脚本 → 沙箱执行 → 只把 stdout 放回上下文。
官方示例里,47 次 Read、约 700KB,变成 1 次 ctx_execute()、3.6KB。
这类优化不靠“模型更聪明”,靠工作流改道。
3. Session Continuity:压缩后不再从零开始
它会记录文件编辑、git 操作、任务、错误和用户决策。
对话被压缩前,hooks 捕获状态;压缩后,用 SQLite FTS5 + BM25 检索把相关内容找回来。FTS5 是 SQLite 的全文检索模块,BM25 是排序算法。
简单说:上下文可以丢,索引还在;会话可以断,关键决策还能找回来。
三、架构差异:不是插件,是上下文路由器
普通 AI 编程工具的数据流很简单:
Agent 调工具 → 工具返回原始输出 → 原始输出进上下文 → 下一轮继续重发
context-mode 把中间加了一层:
Agent 调工具
  ↓
hooks 在 PreToolUse / PostToolUse / PreCompact 拦截
  ↓
大输出进沙箱执行,或索引进 SQLite FTS5
  ↓
上下文只拿到摘要、指针、检索片段
  ↓
压缩后按会话事件和 BM25 结果恢复状态
这套架构的关键不是“压缩率”,而是三件事:
其一,重复发送变少了。 原始输出不再每轮占着上下文。
第二,精确内容还能找回来。 文档、代码示例、API 片段走索引检索,不靠模型脑补。
第三,路由可以统一。 对 curl、wget、rm -rf 这类命令,有 hooks 的平台可以阻断或重定向到沙箱。
 `
四、如何部署
官方通用安装路径是:
npm install -g context-mode
context-mode doctor
多数平台要求 Node.js ≥ 22.5 或 Bun。Claude Code 插件路径更省事:
/plugin marketplace add mksglu/context-mode
/plugin install context-mode@context-mode
/context-mode:ctx-doctor
跑通后可以试试:
context-mode index . --source project:demo
context-mode search "authentication middleware" --source project:demo
context-mode insight
它的工具分两类:
ctx_execute/ctx_execute_file/ctx_batch_execute:适合日志、测试输出、CSV、构建结果ctx_index/ctx_fetch_and_index/ctx_search:适合文档、API 参考、MCP 工具签名
选型原则很简单:要汇总统计,用执行;要精确原文,用索引。
五、企业团队怎么落地?
这部分才是它和普通“省 token 小技巧”的区别。
1. 改造思路:先管数据流,再管风格
不要一上来全员强推。先选 1-2 个真实团队,把高输出工具列出来:日志、测试、构建、Issue 列表、网页快照、MCP 返回。
然后定规则:
大输出必须进沙箱 文档类内容必须进索引 危险命令必须阻断或重定向 会话压缩前必须保留关键决策
2. 批量部署:开源本体没有 Fleet Console
这是实话。
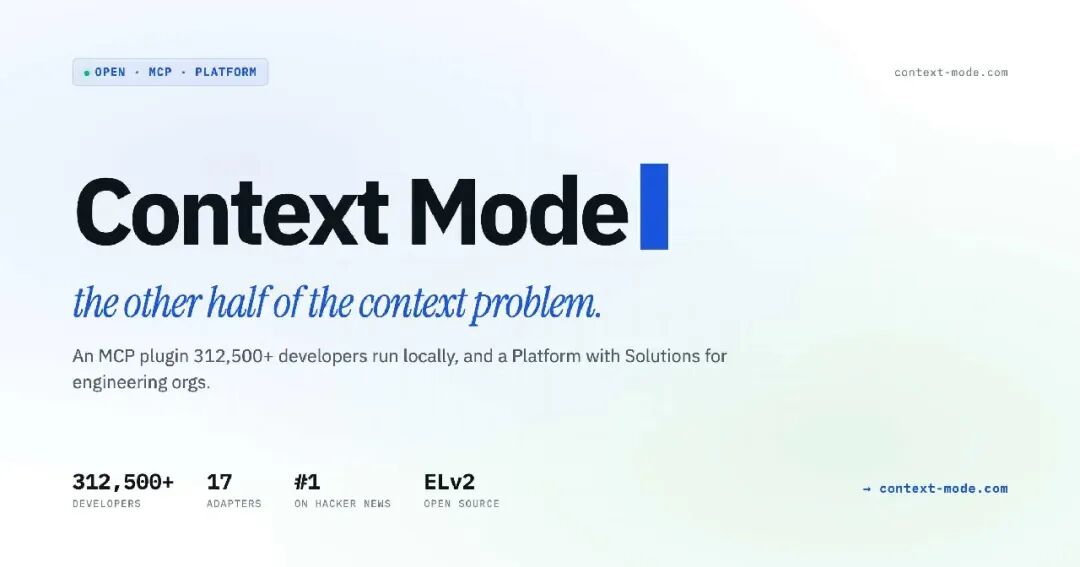
context-mode 支持 Claude Code、Cursor、Copilot、Codex、Gemini CLI、OpenCode、Zed 等 17 个客户端,但开源仓库不是一键企业管控平台。
团队要自己包一层:
用内部 npm 镜像锁定版本 Claude Code 走内部 plugin registry Copilot/Cursor/OpenCode 下发统一 hooks 配置 新员工机器执行 ctx doctor做安装检查版本升级先灰度,再全员推送
3. 流水线集成:别碰源码边界
开源插件默认本地运行,无云同步、无遥测、无账户。
如果团队要审计,建议优先把事件留在本地 SQLite;如果确实需要组织视图,官网提供 Context Mode Platform,付费、opt-in,只转发结构事件。
边界要写死:不采源码,不采 Prompt,不采文件内容。
4. 团队规范:路由比口号可靠
有 hooks 的平台,可以自动路由和阻断。没有 hooks 的平台,只能依赖 AGENTS.md、GEMINI.md 这类指令文件。
所以团队规范别只写“请大家节省上下文”。要落成具体条目:
日志分析必须用 ctx_execute_fileAPI 文档必须用 ctx_index + ctx_search大文件禁止直接 Read 网络命令默认进沙箱 敏感变量进入 denylist
六、优缺点
优点
数据链路清楚:拦截、沙箱、索引、检索、恢复 官方 benchmark 覆盖 21 个真实场景 17 平台覆盖广,Claude Code 的 hooks 支持完善 本地优先,隐私边界清楚
局限
许可证是 Elastic License 2.0(ELv2),不是 OSI 认证开源协议。你可以用、改、内部部署,但不能把软件包装成托管服务提供给第三方,也不能移除许可声明。
平台能力也不齐:
Claude Code:完整 hooks,适配成熟度较高 Cursor、Codex CLI、Kiro:部分能力受限 Antigravity、Zed、OMP:无 hooks,只能依赖指令文件,官方文档标注约 60% 合规 会话恢复能力取决于平台是否暴露 PreCompact / SessionStart
我的建议
别拿 98% 当承诺。 它主要适用于日志、测试、构建、快照这类“可摘要”数据;代码示例检索强调原文保真,节省率会低一些。
别把 benchmark 当生产压测。 21 个场景是官方数据,真实团队要先跑自己的日志、仓库和工具链。
别忽略 276 个 open issues。 项目很活跃,也意味着接口和平台适配还在快速变化。
七、笔者有话说
我的判断:如果你已经在用 AI 编程 Agent 做真实项目,context-mode 值得试点。
它真正值钱的不是“315KB 压到 5KB”,而是把上下文从聊天日志变成可检索、可路由、可恢复的工程数据。
但别神化。ELv2、平台 hook 差异、benchmark 适用范围,这三件事决定它适不适合你的团队。
GitHub 地址:
https://github.com/mksglu/context-mode
关注【极客AI开源圈】,领取【百万字AI大模型全景进阶脑图】
本号持续更新实用有趣的开源项目。如果你不想逐篇翻阅往期文章,可以直接关注公众号【架构文摘】,在后台留言与号主互动交流。