ARTICLE · 1083290
AI 联网不只会搜索:web-access 让 Agent 会选工具,也会操作浏览器
AI技能图鉴 / AI SKILL ATLAS
ARCHIVE 059 · WEB ACCESS
FIELD GUIDE/OPEN SOURCE/AI SKILL
AI 联网不只会搜索:web-access 让 Agent 会选工具,也会操作浏览器
分类:Agent 联网 / 浏览器自动化 / 信息核实
来源:https://github.com/eze-is/web-access
CATALOG / 目录
PHASE00
判断
·任务判断
·联网选路
PHASE01
执行
·浏览器执行
·并行调研
PHASE02
收尾
·结果核对与经验复用
让 AI 联网查资料,真正费判断的是搜到之后怎么办。
公开网页可以直接读取,动态页面要等内容加载,创作者后台需要登录,视频里的信息还得逐帧查看。碰到这些情况,只会调用搜索工具的 Agent 很容易停在页面之外。
web-access补上了一套完整的处理方法。它会根据任务选择 WebSearch、WebFetch、curl、Jina 或浏览器 CDP。需要真实页面时,它还能接入用户日常使用的 Chrome、Edge 等 Chromium 浏览器,沿用现成登录状态继续点击、滚动、上传文件和读取内容。
关注AI技能图鉴,持续介绍AI技能
它解决什么问题
CASE 01
联网工具不少,什么时候用哪个更重要
搜索适合发现线索,已知网址适合定向读取,原始 HTML 适合找网页里的结构化字段。遇到登录后的页面、动态内容或需要点击操作的网站,再进入浏览器会更合适。
web-access把这套判断写进 Skill。Agent 先看任务要达到什么结果,再选择起点。如果当前方法没有推进,它会根据页面和返回内容换路,及时尝试更合适的通道。
CASE 02
网页打开了,不等于内容已经拿到
动态网站经常先出现空白页、加载状态或登录跳转。基础导航完成后,web-access还会检查目标内容是否真的出现在页面里。页面继续变化时,它会等一等再重新判断。
进入 CDP 模式后,Agent 可以读取 DOM、点击按钮、滚动触发懒加载、填写表单、上传本地文件和截图。网页里的视频也能跳到指定时间点取帧,适合分析演示片段或教程内容。
CASE 03
公网找不到的页面,也有入口
有些目标不在搜索引擎里,比如公司内部系统、收藏过的工具页,或者前几天看过却忘了地址的文章。
仓库里的find-url.mjs会检索本机 Chrome 和 Edge 的书签与历史记录。它支持关键词、时间范围、最近访问和访问次数排序,让 Agent 可以从用户真实访问过的页面继续工作。
一次联网任务,会怎样推进
例如,你可以直接提出这样一个任务:
帮我调研这 5 款 AI 录音笔最近一次产品更新,整理成对比表,并附上官方出处。
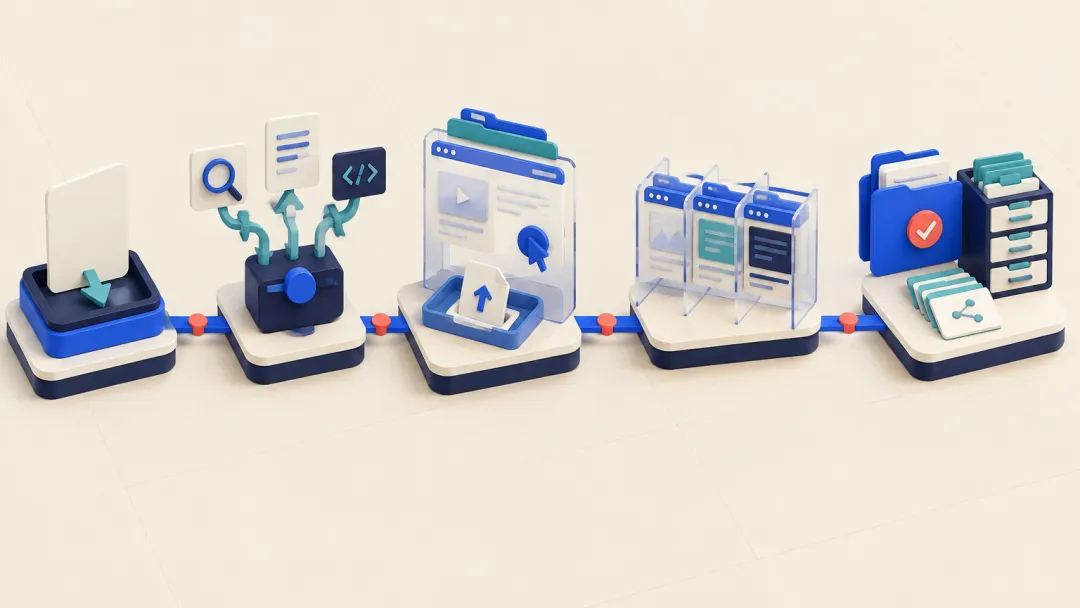
一项联网任务会经过目标判断、选路、浏览器执行、并行处理和结果核对。
任务判断
先弄清什么算完成
Skill 会先拆出目标对象、所需字段和最终交付。这个例子要确认五款产品的更新内容、时间和官方来源,再形成一份能对照阅读的结果。
这一步让后面的每次搜索、跳转和读取都有明确用途。
联网选路
从最合适的入口开始
Agent 可以先用 WebSearch 找到各产品的官方页面,再用 WebFetch 读取正文。需要网页源码中的日期、版本号或 JSON-LD 时,可以改用 curl。文章和文档型页面还可以先经 Jina 转成 Markdown,减少无关页面元素占用的上下文。
这些工具可以组合使用。搜索负责找到入口,官网和原始页面负责核实事实。
浏览器执行
在真实页面里继续
如果更新记录藏在动态页面、登录后的控制台或交互组件中,CDP Proxy 会连接日常浏览器,并新建后台标签页处理任务。Agent 可以查看页面结构,再决定点击、滚动、输入、上传还是截图。
Proxy 提供普通 JS 点击、真实鼠标事件和文件上传三种操作。它会追踪自己创建的标签页,任务结束时关闭;标签页长时间没有访问,也会自动清理。
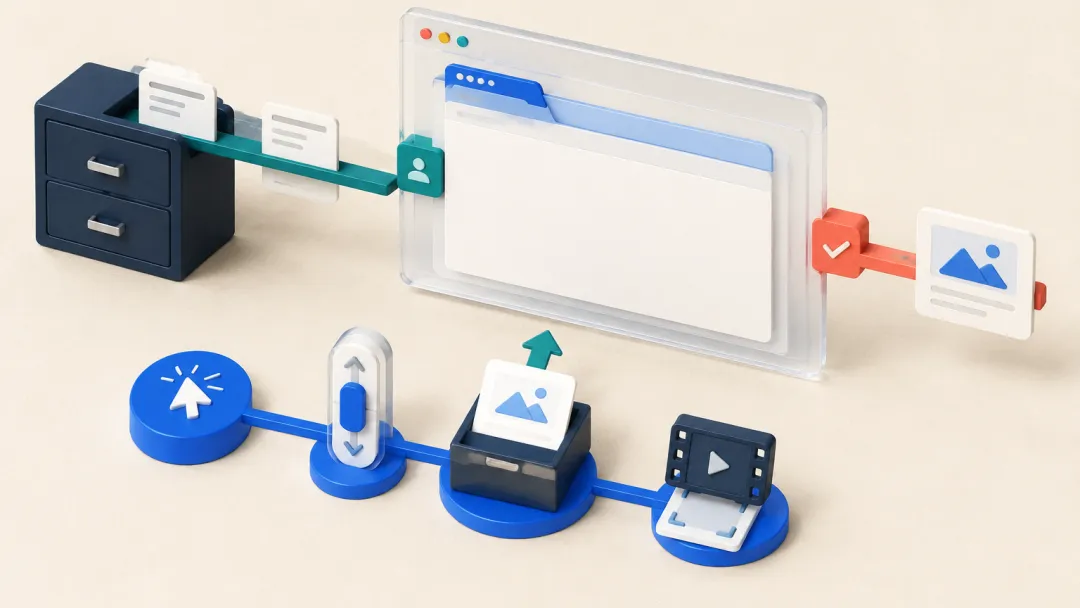
本地历史、登录状态和页面操作汇入同一个浏览器通道。
并行调研
多个目标同时推进
五款产品彼此独立时,Skill 可以把它们分给多个子 Agent。每个子任务使用不同的targetId操作自己的标签页,共享同一个 Proxy,主 Agent 只接收整理后的结果。
这样既能同时推进多个来源,也能避免五组网页内容全部挤进主对话。
结果核对与经验复用
把出处和走法一起留下
web-access把搜索结果当作线索,结论尽量回到官网、官方公告或原始文档。对同一个站点完成操作后,已经验证过的 URL 规律、页面特点和有效操作方式还可以按域名写入经验文件。
下次再访问这个网站,Agent 先读取已有经验,再根据当前页面调整。交付内容包括核实后的对比结果和原始链接。
最常见的使用方式
公开资料调研适合用它做完整核实。Agent 可以先发现来源,再回到官网、论文原文或企业公告确认内容,收尾时整理出处。
登录后的网页操作更能发挥 CDP 的作用。创作者后台、会员页面和内部系统可以沿用日常浏览器里的登录状态,在后台标签页中完成读取与交互。
找回旧页面时,本地书签和历史记录成了搜索入口。只记得主题、访问时间或大概网站,也可以继续定位。
多目标任务则可以结合子 Agent 并行推进。竞品调研、多站点资料汇总和批量页面核对,都能把独立目标分开处理,再统一汇总。
它为什么能工作
仓库同时提供核心规则和可运行脚本。SKILL.md负责目标判断、工具选择、完成标准和信息核实;check-deps.mjs负责检查 Node.js、浏览器远程调试和 Proxy 状态;cdp-proxy.mjs把浏览器能力变成一组本地 HTTP 接口;find-url.mjs负责读取本机书签和历史。
几部分的分工很清楚。Skill 决定下一步做什么,脚本把浏览器动作执行出来,页面结果再回到 Skill 继续判断。站点经验文件则保存已经确认过的操作规律,供下一次任务参考。
这种分工带来的变化很直接。用户只需说清目标,Agent 根据真实页面一路判断,直到拿到目标内容或完成网页动作。
安装与前置条件
项目推荐使用skillsCLI 安装:
npx skills add eze-is/web-access它适用于支持SKILL.md的 Agent。项目 README 列出的环境包括 Claude Code、Cursor、Gemini CLI 和 Codex CLI 等。
要使用 CDP 浏览器能力,本机需要 Node.js 22+,并在 Chrome 或 Edge 中开启远程调试。Chrome 对应chrome://inspect/#remote-debugging,Edge 对应edge://inspect/#remote-debugging。首次运行会创建本地config.env,可以用WEB_ACCESS_BROWSER保存常用浏览器偏好。
适用范围
web-access很适合经常让 Agent 查公开资料、读取动态网页、处理登录后页面或同时调研多个目标的人。内容创作者可以用它核实来源和操作创作后台,开发者可以用它读取内部系统或检查网页状态,研究任务则可以用并行分工处理多个独立来源。
它也适合那些“记得看过,但找不到链接”的日常任务。本地浏览记录、真实浏览器和普通联网工具被放进同一条流程后,Agent 能从更多入口找到目标,也能把页面里的事情继续做完。
关注AI技能图鉴,持续介绍AI技能