ARTICLE · 1085836
Jev:不聊天、只做判断的 AI 模型,能给软件省下什么?
最近我在 X 上看到一个挺反常的模型发布:Jev 不聊天、不写代码,也不生成解释。它只接收一段状态和几个问题,再把答案作为有类型的判断和概率交给程序。
与此同时,TypeSafe 给出的发布标题是最高 193.6 倍速度、444.6 倍成本优势。这个组合很容易把讨论带向两个极端:要么把它当成下一代模型范式,要么觉得它不过是给分类器重新起了名字。
我想先把广告数字放一边,看看 Jev 实际提供的接口是什么,再讨论它和通用 LLM、结构化输出、规则系统之间的边界。下文的产品规格来自 TypeSafe 当前公开文档;速度、成本和准确率会分别标明是厂商结果还是小规模外部测试,不把它们混成一个结论。
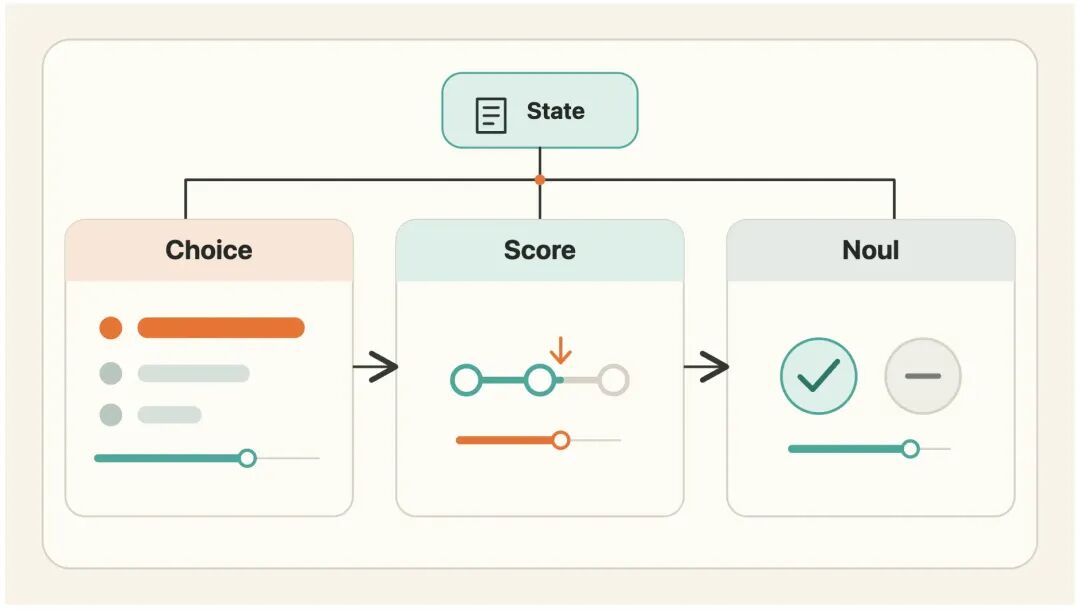
这是按公开 API 结构整理的解释性示意,不是 Jev 的实际界面。
它不是聊天模型,而是给软件用的判断接口
Jev 是 TypeSafe AI 在 2026 年 9 月 15 日推出的第一个 System One 模型。TypeSafe 把 System One 定义成一类面向软件决策的模型:输入一段 state,再附上一组有明确类型的问题,返回程序可以直接读取的值,而不是一段回答用户的文字。TypeSafe 的发布说明 和 官方文档 都把它定位为自动化工作流里的判断层。
这里的 state 可以是文本、JSON 对象或文本数组。问题目前有三种:
Choice | |||
Score | |||
Noul |
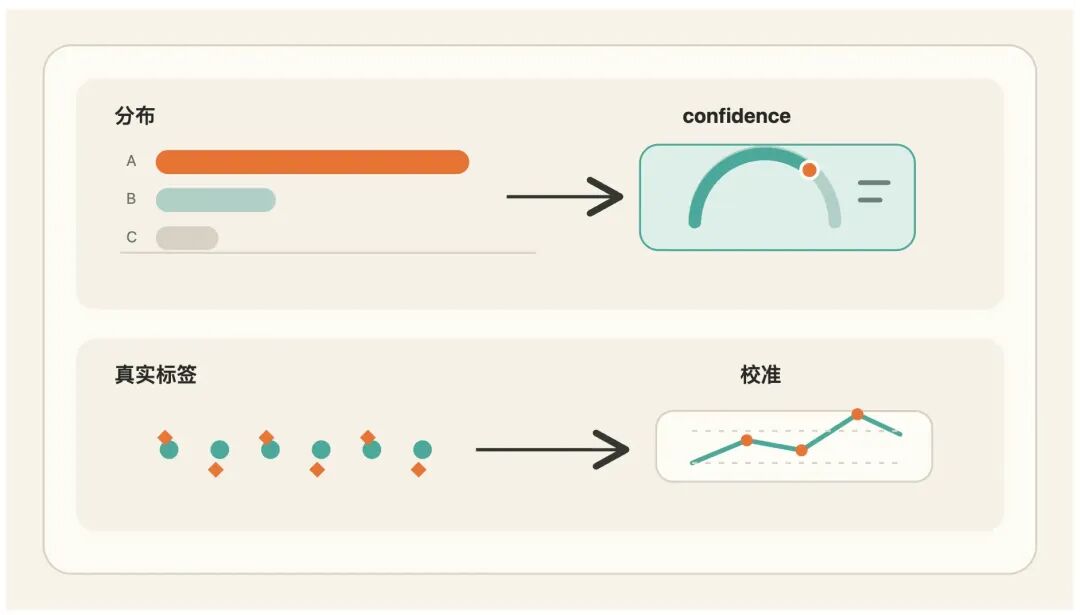
三种问题类型的返回形状示意,不是某个请求的真实结果。
例如,客服系统可以把当前对话、账户信息和最近的支付记录放入 state,再同时问“应该由哪个团队处理”和“用户是否表达了紧迫性”。Jev 返回 department.choice、各选项的概率分布,以及 is_urgent.noul。应用代码再根据这些结果和自己的业务规则决定路由。
多个问题可以放在同一个请求里;官方文档称它们会针对同一份 state 并行、独立地计算。一个问题不会把自己的答案作为另一个问题的上下文。这是一个重要的设计选择:Jev 适合把一项工作拆成若干个短判断,再由代码组合;它并不负责替你推理出整条业务流程。官方 primitives 文档
把接口摊开看:一份请求同时做三项判断
下面这个例子把一张客服工单作为 state,一次问它归哪个团队、用户有没有明确要求退款、问题有多紧急。它调用的是官方 HTTP API;示例里的业务文本和返回数值都是虚构的,没有真的发出请求。
curl https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "state": {
      "ticket": "我被重复扣款了,麻烦把多收的那笔退给我。",
      "order_id": "A-104",
      "payment_status": ["captured", "captured"]
    },
    "model": "jev-latest",
    "questions": {
      "department": {
        "type": "choice",
        "instructions": "Which team should handle this ticket?",
        "criteria": {
          "billing": "Payments, invoices, and refunds",
          "technical": "Bugs, outages, and integrations",
          "sales": "Pricing and new accounts",
          "other": "Anything that does not fit the options above"
        }
      },
      "refund_requested": {
        "type": "noul",
        "instructions": "Does `ticket` explicitly request a refund?",
        "criteria": {
          "true": "The customer asks for money to be returned",
          "false": "The customer does not ask for money to be returned"
        }
      },
      "urgency": {
        "type": "score",
        "instructions": "How time-sensitive is the issue described in `ticket`?",
        "criteria": [
          "Routine; no time pressure is expressed",
          "Urgent; a prompt response would help",
          "Critical; immediate action is needed"
        ]
      }
    }
  }'
返回值按问题 ID 放回 answers,而不是要求应用再从一段解释里找答案。形状大致如下,数值仅为说明:
{
"model":"jev-1.13.0",
"answers":{
"department":{
"type":"choice",
"choice":"billing",
"probabilities":{"billing":0.88,"technical":0.07,"sales":0.02,"other":0.03},
"confidence":0.81
},
"refund_requested":{"type":"noul","noul":0.96},
"urgency":{
"type":"score",
"score":1.2,
"legend":{"0":"Routine","1":"Urgent","2":"Critical"},
"probabilities":{"0":0.08,"1":0.72,"2":0.2},
"confidence":0.62
}
},
"usage":{"input_tokens":200,"output_tokens":30}
}
这份示意把几个容易混淆的地方放在一起了:Choice 的 choice 是概率最高的那个选项,probabilities 则保留完整分布;Score 的数值是按各级概率加权后的结果,因此可能落在两个等级之间;Noul 直接给出“是”的概率,没有单独的 confidence 字段。输入里的 criteria 是应用定义的答案空间,模型不能返回一个没列出来的部门名。完整的字段和错误码见 API Reference。
Noul 的 0.5 表示模型对 yes 和 no 给出相近概率,不是“中等严重”或“有一半把握”的通用分数;如果问题本身是程度判断,应该用 Score 明确量表。反过来,Choice/Score 的 confidence 也不是新的答案,而是从完整概率分布计算出的摘要。如果你的程序需要不同的不确定性指标,API 仍然把每个候选项的概率都返回了。
问题也不是写得越长越聪明。TypeSafe 建议每个问题尽量只问一个可以独立回答的判断,并把选项、等级和边界情况说清楚。如果三个判断彼此独立,就适合放在同一次请求里;如果第二个判断必须先看第一个答案才能定义,就要先在代码里取回第一个结果,再把它放进下一次请求的 state。并行不等于自动推理依赖关系。
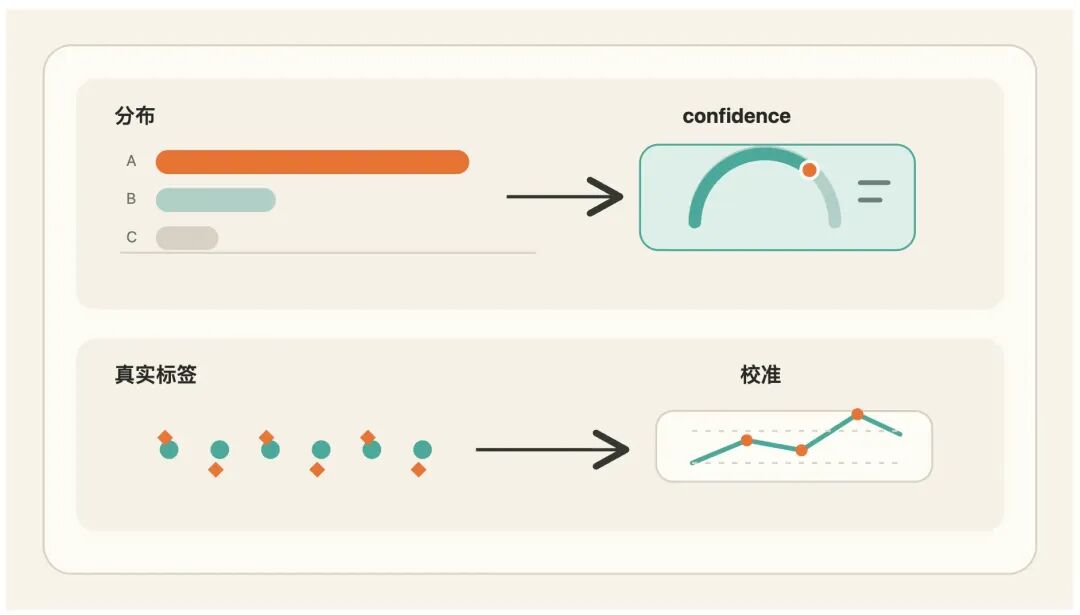
confidence 是单次输出分布的摘要;是否校准,要看一批预测与真实标签的对应关系。
System One 是产品定位,不是“模型像人脑”的证明
TypeSafe 用 Daniel Kahneman《思考,快与慢》里的 System 1 / System 2 区分来命名:System 1 是快速直觉判断,System 2 是较慢的审慎思考。Jev 的方向是前者——快速处理边界明确的判断。
这个名字容易让人以为模型复刻了人类的直觉系统。公开资料并没有证明这一点。TypeSafe 披露的技术关键词是新模型架构、parallel sampler,以及它称为 RLCD(Reinforcement Learning for Calibrated Decisions)的训练方法;模型参数规模、完整架构和训练数据细节并没有在公开文档里展开。所以我会把它理解成 TypeSafe 定义的一类产品/模型接口,而不是已经被学术界统一采用的模型分类。
Jev 这个名字则来自经济学家 William Stanley Jevons 和 Jevons paradox:一种资源效率提高后,总需求反而可能增加。TypeSafe 的产品假设是,如果一次机器判断变得足够便宜,软件就能在更多步骤里调用判断模型。这个想法有吸引力,但“调用更便宜”不自动等于“整个系统更便宜”:状态准备、业务验证、错误复核、隐私处理和调用编排也都要算进账里。命名与产品定位见 TypeSafe 发布文
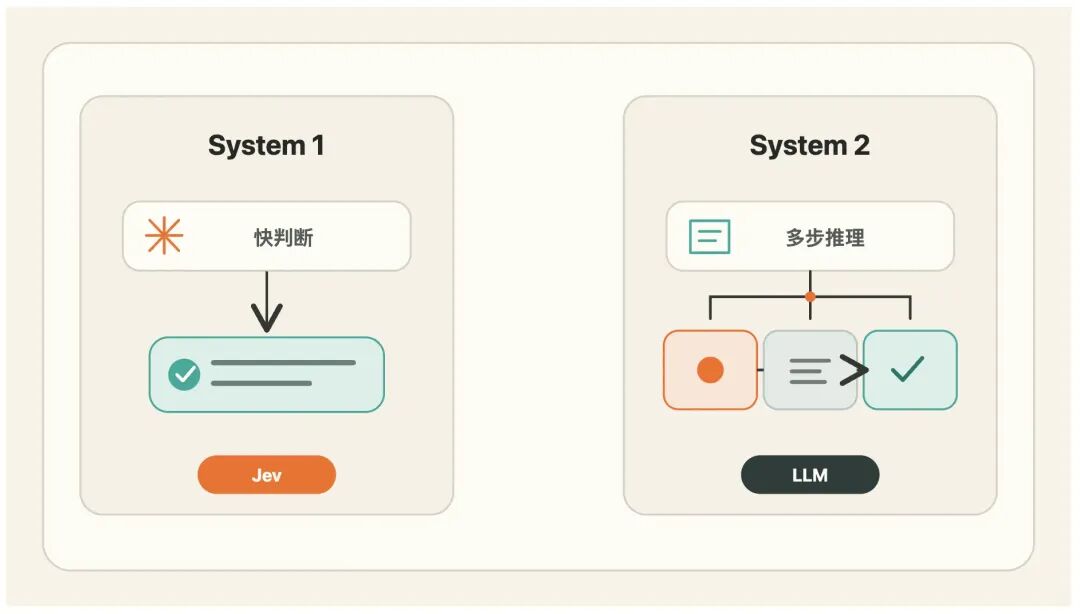
这里借用的是任务形态的类比,不代表 Jev 复刻了人脑 System 1,也不意味着通用 LLM 只能做慢推理。
和 JSON mode / function calling 有什么不同?
不能把这个问题简化成“LLM 不会输出结构化数据,Jev 会”。现在的通用模型可以通过 JSON Schema、structured outputs 或 function calling 返回受约束的数据。TypeSafe 自己还发布了一个 System One LLM Adapter,可以让普通 LLM API 以近似的接口回答 Choice / Score / Noul,再由客户端做格式校验、概率归一化和错误重试。
所以区别不在于“一个能出 JSON,另一个不能”。更值得比较的是模型的训练目标、工作方式和任务范围:
在一个混合系统里,这几种工具并不冲突。代码处理“金额是否超过 75 美元”这类硬规则;Jev 判断“描述和收据是否明显不一致”;通用 LLM 负责向用户解释处理结果;无法确认或后果严重的情况交给人工。这比让一个模型包办提取、判断、执行和解释更容易审计。
把判断问题设计得好坏,往往比选 Choice 还是 Score 更影响结果。官方文档建议在备选项可能不全时加上 other 或 none of the above,而不是逼模型从错误选项里挑一个;量表的每一级最好有可观察的区别;涉及政策或记录时,把相关材料放在 state 里,并在 instructions 中明确指向对应字段。若问题含糊、答案空间漏项,格式再安全也只是稳定地返回一个不合适的答案。
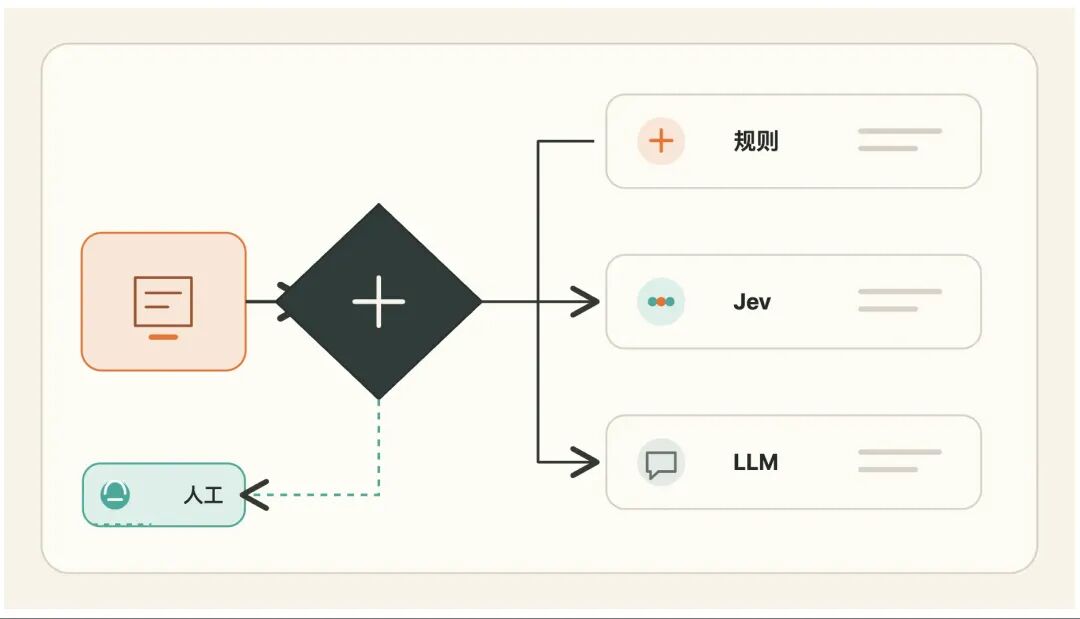
路由依据是问题形状和出错代价,而不是把某个模型设成万能默认项。
有 confidence,不等于每次都知道自己对不对
Jev 的 Choice 和 Score 返回概率分布,并额外给一个 confidence 值。TypeSafe 说,它的训练目标是让概率在一批预测上和实际命中率相匹配。举例说,一组被标成 0.8 的判断,长期看应该接近八成正确。
这里有个容易被忽略的限定:校准说的是一组预测的统计性质,不是单条回答的正确保证。 官方文档也明确提醒,校准不能保证某一个答案一定正确;confidence 是由概率分布计算出来的摘要值,并不等于一个外部验证过的“真相分数”。TypeSafe 的 confidence 说明
把 confidence 接到系统里,应该由业务代码按风险设门槛。低影响、可撤销的路由可以较低门槛自动走;涉及付款、账号封禁、权限变更的判断,即使分数高,也可以要求确认或二次校验。模型告诉程序“我倾向哪一项、分布有多集中”,最后的风险容忍度仍是系统设计者的责任。
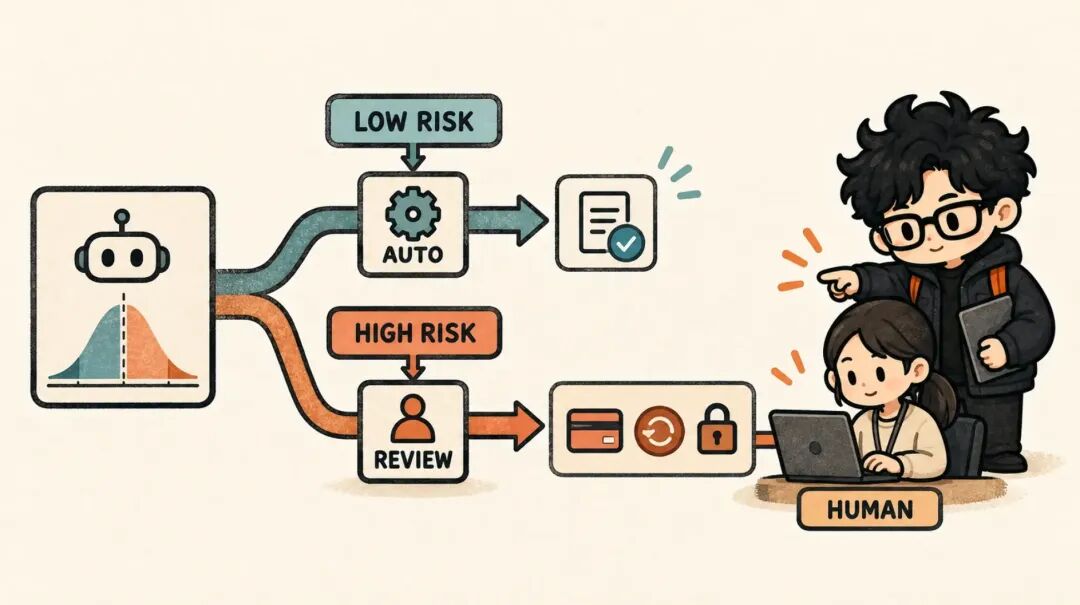
解释性示意:confidence 用来路由和升级处理,不是正确性的保证。
TypeSafe 的“零 hallucination”说法也得拆开看。按它的解释,输出空间被请求里的类型和选项限制,因此模型不会凭空返回一个没定义的部门名,也不会把答案变成一段不符合 schema 的文章。这是有用的格式保证,但它仍然可以从合法选项里选错一个。The Register 对这个区别说得很直接:不胡编输出格式,和判断永远正确,是两件不同的事。The Register 对 Jev 的报道
193.6 倍更快、444.6 倍更便宜,该怎么读?
TypeSafe 发布时给出的 headline 是最高 193.6 倍速度和 444.6 倍成本优势。这两个数字来自它自建的四个 workflow evaluation。其评测把任务拆成多个模型判断和程序规则,基线参考是 GPT-6 Astra 与 Claude Fable 5.1 高推理输出的平均值;官方也说,这些数字处在它观察到的高端,而不是典型承诺。工作流由 TypeSafe 的能力团队设计,参考答案是模型共识而非人工核验的客观标签。TypeSafe 的评测方法 适合说明它的设计目标,但不能直接当成独立排行榜。
一个 9 月 19 日的独立计时实验把分母拆得更细。同一个 Jev 单次判断,对 Gemini 3.1 Flash Lite 是 1.7 倍快,对 Claude Haiku 4.5 是 1.9 倍;对开启推理的 Claude Fable 5.1 是 5.4 倍。把六个判断作为六次串行调用交给 Fable,再和一个 Jev 批量请求比较,结果变成 74.42 秒对 0.739 秒,也就是约 100.7 倍。作者每个比较跑了三次取中位数,并说明前几个结果扣除了网络时间,工作流比较则计入了实际往返时间。TrueStandard 的计时方法与结果
同一模型能出现 1.7 倍和 100 倍的差距,不是算术把戏,差别在比较对象:单个简单判断对单个快速模型,优势有限;多个独立判断如果原来要串行叫六次模型,现在可以一次批量完成,省下的不只推理时间,还有重复的往返调用。高价、开了深度推理的模型作基线,成本倍数也会放大。
同一组六连问的成本对照里,TrueStandard 报告的 Claude Fable 5.1 thinking 工作流约为 0.16251 美元,Jev 批量请求约为 0.00002167 美元,成本差距约 7,499 倍。这个数字尤其依赖基线:它比较的是六次高推理调用和一次批处理,不代表 Jev 对任意 LLM 都能便宜几千倍。Jev 当前官方单价是每百万输入 token 0.042 美元,输出 token 不收费;但请求中的 state、问题文本、调用前后的代码、人工复核和数据治理仍然是系统总成本的一部分。当前模型价格与限制
另一个独立实验把 Jev 用在 37 篇文章、21 个 AI 写作特征上,一次返回 777 个判断花了不到 0.7 秒,估算成本约四分之一美分。但作者也说,自己还需要更充分的准确率验证,不能直接拿它上线做裁决。后来对 12 篇人工构造的段落做四项写作检查,Jev 找到 7 个问题中的 6 个,Claude Fable 找到全部 7 个。它说明低成本地多跑几次检查是可行的,也提醒我们速度不会自动补齐准确度。Every 的小规模实践
JevBench 也出现了社区试验:当前公开的 v1.2 pilot 在 534 个判断、25 个系统上按“智能、校准、速度、成本”四项等权组合,Jev 排名靠前。这个排名不是纯准确率榜:权重、成本估算、测试任务语言和硬题占比都会影响综合分数;项目自己也强调它只有 534 个英语案例,是 pilot,不代表每个应用。JevBench v1.2 方法与限制
准确率也有一个小型外部数据点可看。TrueStandard 另做了一次 108 条人工标注 claim、覆盖六个领域的单轮测试,报告 Jev 准确率 96.3%,Gemini Flash Lite 为 94.4%,Claude Haiku 4.5 为 93.5%;三者的 ECE(预期校准误差)分别为 0.066、0.061、0.067,差别不大。108 条样本和一次运行不足以给模型排定长期名次,作者本身也在做商业化验证产品;我更愿意把它读成一个提醒:目前公开结果还不能证明 Jev 的校准能力在所有任务上都天然更好,必须用自己的分布复测。TrueStandard 的准确率与校准测试
把这些结果放在一起,我会把 headline 理解为:Jev 在多判断、可并行、输出无需长文本的工作流里,有机会把单位决策成本压得很低。 这和“任何任务都比大模型快 193 倍”不是同一句话。
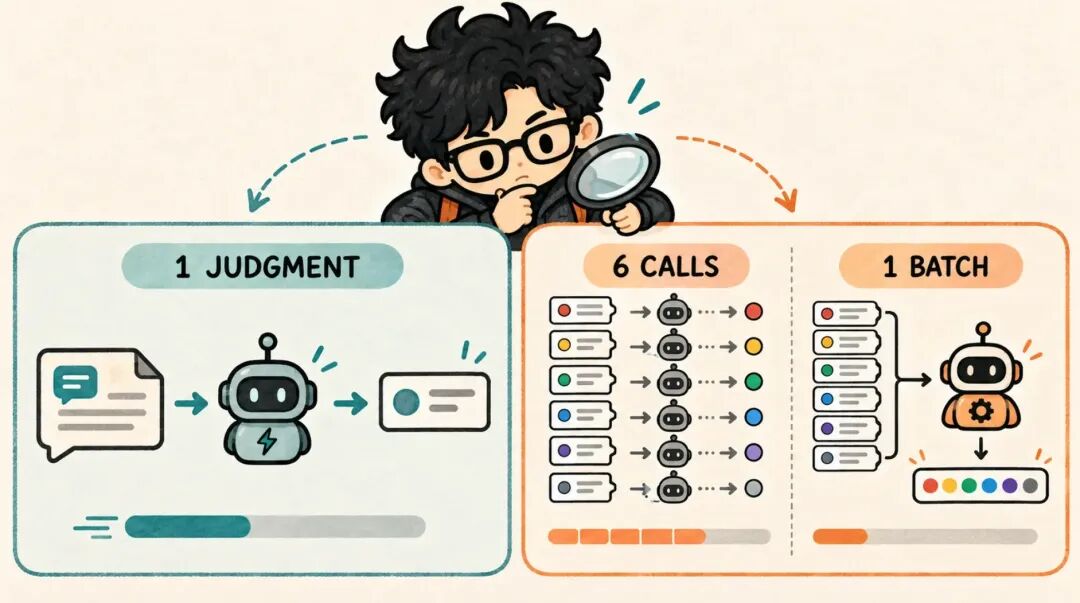
适合从哪种小任务开始试?
我会先找一件系统里已经存在、反复发生、答案范围也说得清的小判断:客服工单路由、告警是否升级、文档类型归类、agent 做完任务后是否需要人复核。不是先问“能不能把整条流程交给 Jev”,而是先看这个判断现在是用规则硬凑、还是每次都叫一个通用 LLM。
上线前至少要把几件事自己跑出来:拿真实且脱敏的领域样本,设定可复现的正确答案;分别检查总体准确率和不同子类的错误;量 confidence 是否在你的数据上有校准;测真实请求长度、批量数、端到端延迟和总成本;明确低分、冲突和高风险的升级路径。不要用模型自带的 confidence 门槛直接当公司的风险策略。
如果我来做一个两周的试点,会按这个顺序收窄范围:先挑一条只影响分流、不直接触发不可逆动作的链路;从历史数据里抽样,并由人复核一份小而可信的评估集;用同一批输入比较现有规则、快速 LLM 和 Jev,统一输出标签、重试策略、并发方式和网络测量口径;最后按错误代价设定自动通过、要求确认、转人工三档。先跑影子流量、不让模型直接执行,再看它在哪些子类上有稳定收益。这样即使试验失败,也能知道是模型边界、问题定义还是原系统成本假设不成立。
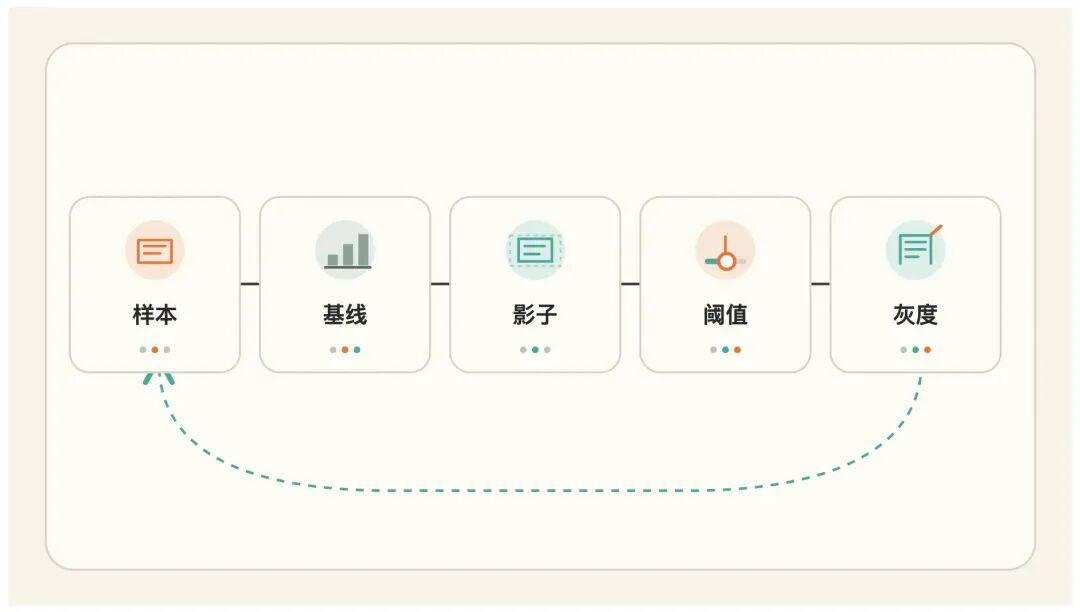
这是试点步骤示意,不代表固定两周就能完成上线。
工程接入也不能只看一次 200 OK。官方 API 会用 401 表示密钥无效、422 表示问题结构不符合定义;流量超限可能是 429,服务过载可能是 529,文档建议后两者用指数退避重试。SDK 默认有重试策略;直接调 HTTP 的话,需要在自己的服务里配置退避、超时和失败后的保守路径,避免模型不可用时业务卡死。错误码与重试建议
还要留意当前边界。Jev 目前只接收文本、JSON 或文本数组,不处理图像、音频、视频;官方文档说英语是主要训练语言,中文等 CJK 内容也能输入,但准确率并不等同于英文,建议用自己的数据先测。早期访问期的 rate limit 也可能调整。官方模型规格
截至我查阅文档的 2026 年 9 月 21 日,当前稳定模型是 jev-1.13.0,请求可以用 jev-latest 这个别名;别名会随新版本移动,如果某个置信度阈值是按特定版本测出来的,最好固定版本并记录响应中的 model 字段。每个请求总上下文上限为 64k tokens,其中 state 与最长的单个问题合计最多 32k;Choice 最多 255 个候选,Score 接受 2 到 10 个有序等级。文档还列出 250,000 tokens/s 和 1,200 requests/min 的速率限制,但注明早期访问期间会动态调整,不能把它当长期 SLA。
隐私边界也别被“只问一个分类问题”掩盖了:state 仍可能包含客户消息、账号记录或内部资料。TypeSafe 公开文档称不会用客户请求和响应训练模型,同时把零数据保留说明在企业条款里;接入前还是要按自己的数据政策核对保留、访问控制和脱敏要求,而不能仅凭推理接口短就默认合规。TypeSafe 数据与模型说明
更合适的系统形状大概是:规则负责硬边界,Jev 负责边界清晰的模糊判断,普通 LLM 负责需要解释和生成的部分,代码负责组合结果和限制权限,人类接住低置信度和高风险例外。Jev 是其中一块,不是把其他层都抹掉的“智能总开关”。
我的判断:新东西在接口,也在成本单位
我觉得 Jev 值得关注的地方,不是它证明了“System One”已经成了全新的大模型范式,而是它把很多工程师原本塞进 prompt 的一小段决策拆了出来:模型回答限定问题,程序掌握组合逻辑,输出里再带一个可以用于升级处理的概率分布。
这个边界足够清楚时,Jev 看起来不像一个更会聊天的助手,更像一个新型的软件依赖。以后架构里可能同时有会写会解释的大模型、做快速判断的决策模型、硬规则、专用分类器和人工复核——调用哪一层,取决于问题的开放程度、风险、成本和所需输出。
TypeSafe 用 Jevons paradox 给模型命名,背后是一个大胆的判断:当机器智能便宜一个数量级,软件会开始在更多地方使用判断模型。这个逻辑很有意思,但产品能否长期成立,最终要看每个具体工作流:模型是否足够准,低置信度时系统会不会停,新增的判断有没有真的改善结果。
所以我不会把 Jev 总结成“比 LLM 更快的新模型”。更准确一点:它试图把一部分智能从“生成答案”变成“给软件一个可执行的、带不确定性的选择”。值不值得接入,别看 headline 倍数,挑一条真实业务链路测完再说。
资料来源
Introducing System One Models & Jev — TypeSafe AI System One 与 Jev 官方文档 · Primitives · Models · Confidence · API Reference TypeSafe 官方 Workflow Evals System One LLM Adapter(TypeSafe GitHub) The Register:TypeSafe AI debuts model for machines that plays Doom Every:Mike Taylor 的 Jev 实测 TrueStandard:单个判断与批量工作流的速度对照 JevBench v1.2(社区 pilot)